概要
検索した資料から答えるエージェントが、関係の薄い文書を集め、誤った回答を返したとする。検索質問の指示を直す、検索と回答を別の呼び出しに分ける、検索結果を確かめる処理を実装する、過去の成功した検索手順を再利用する。同じ失敗に対して、モデルの重みを変えずに試せる変更は複数ある。
ハーネスとは、モデルに渡す指示や情報、ツール、呼び出し順序、状態の保持など、モデルを実際に動かす周囲の仕組みである。ハーネス最適化は、実行結果や評価を手掛かりにこの仕組みを変更し、よりよく問題を解ける構成を探す。本書は、プロンプト最適化からワークフロー・コード・メモリの改善までを関連研究として比較する。
基本的な流れは、実行記録を手掛かりにハーネスの変更候補を作り、現行版と比較して、採用した変更を次の入力でも使うことである。候補の生成だけでなく、評価と選択を含む手続き全体が最適化器である。
一回の回答を直すことと、解き方を変えること
重要なのは、何が更新され、次に何を解くために残るかである。
ある数学問題の解答を批評して書き直すなら、改善するのはその問題への回答である。一方、複数の学習問題の誤答から共通の指示を書き換え、未使用の問題に同じ指示を使うなら、改善の対象は問題を解く仕組みである。ProTeGiは分類の誤答から指示を編集し、MIPROは複数のモデル呼び出しに与える指示と例示を探索する (Pryzant ほか 2023年; Opsahl-Ong ほか 2024年)。
コードも同様である。利用者に渡すプログラムを直すことと、プログラムを書くエージェント自身のツールや制御処理を直すことは異なる。ADASとDGMは後者を探索対象に含める (Hu ほか 2025年; Jenny Zhang ほか 2026年)。
図 1 は、この境界をモデル訓練との対比で示す。AgentOptimizerの図で「Update Functions」とされるのは、エージェントが使う関数の更新であり、対象モデルの数値パラメータの更新ではない (S. Zhang ほか 2024年)。
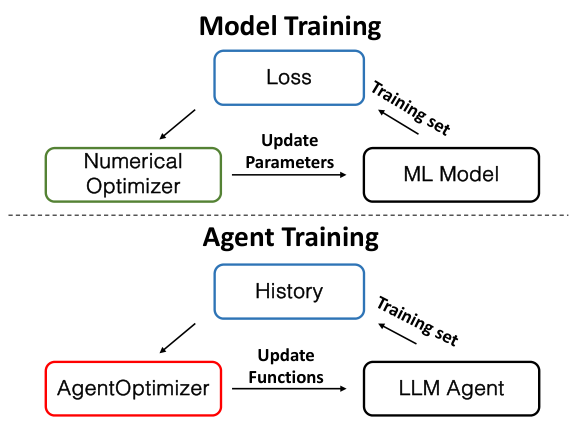
本書の中心は、対象モデルの重みを固定し、複数の入力に使う外部の仕組みを改善する研究である。ただし、関連する研究をこの条件だけで切り落とすことはしない。入力ごとにワークフローを生成する方法や、モデル重みの更新を含む方法も、何が共通し何が異なるかを明示して比較する。
実行経験から残す指示・処理・手順
冒頭の検索失敗から作れる変更を、説明用の例で比べる。
| 残す変更 | 次の入力で変わること | その変更だけでは分からないこと |
|---|---|---|
| 「検索質問には人物名と年代を含める」という指示 | モデルが生成する検索質問 | 実際に必要な文書を取得できるか |
| 検索後に根拠確認を行う処理の追加 | 呼び出しの順序と実行回数 | 確認の費用に見合うか |
| 検索結果を空のまま回答しない実装 | 特定の失敗時に選ぶ動作 | 他の入力でも有効か |
| 過去の成功した検索手順 | 次に参照する経験 | 新しい課題へ転用できるか |
ここでの例は、特定論文の実測結果ではない。比較する単位を具体化するためのものである。実際の研究では、変更可能な表現や評価が異なる。GPTSwarmはモデル呼び出しのグラフ、AFlowはコードで記述するワークフロー、ExpeLは経験から抽出する知見を扱う (Zhuge ほか 2024年; Jiayi Zhang ほか 2025年; Zhao ほか 2024年)。これらを単に「プロンプトを工夫する」とまとめると、探索できる変更の違いが消えてしまう。
反対に、表現が違っても同じ制約を共有する場合がある。指示もコードも、評価用の入力に繰り返し合わせれば、その入力だけで高得点になる可能性がある。編集の自由度が広いことと、未知の問題でも改善することは別である。
候補生成器と、最適化器全体を分ける
修正案を文章やコードとして書くモデルを候補生成器と呼ぶ。一方、本書でいう最適化器は、候補の生成だけでなく、実行、評価、選択、探索履歴の更新を含む手続き全体である。
図 2 は、これらを三つに分けて考えるための原論文の図である。左は表現可能な候補の範囲、中央はその範囲を探す手続き、右は候補を採点する基準である。コードを編集可能にすることは左の変更であり、次の候補を選ぶ方法を変えることは中央の変更になる。評価問題を変えることは、そのどちらとも異なる (Hu ほか 2025年)。
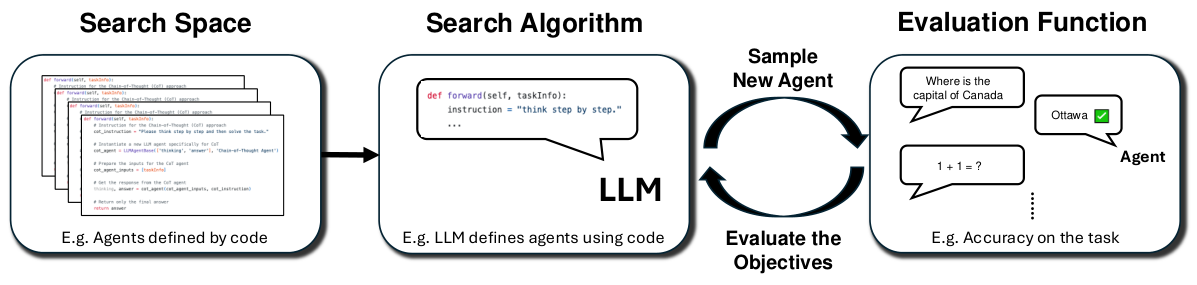
たとえばProTeGiでは、誤答から批評を作るモデル呼び出しと、批評を使って指示を書き換える呼び出しがある。さらに、複数の指示候補を評価し、次の反復へ残す探索手続きがある。候補を書けることと、よい候補を限られた予算で見つけられることは同じ能力ではない (Pryzant ほか 2023年)。
GEPAは実行記録に基づいて指示を編集するだけでなく、検証入力ごとに異なる候補の強みを利用して編集元を選ぶ。DGMは評価済みコードの候補集合を保持する。どちらも、単一のモデルへの「改善してください」という指示だけでは説明できない (Agrawal ほか 2026年; Jenny Zhang ほか 2026年)。
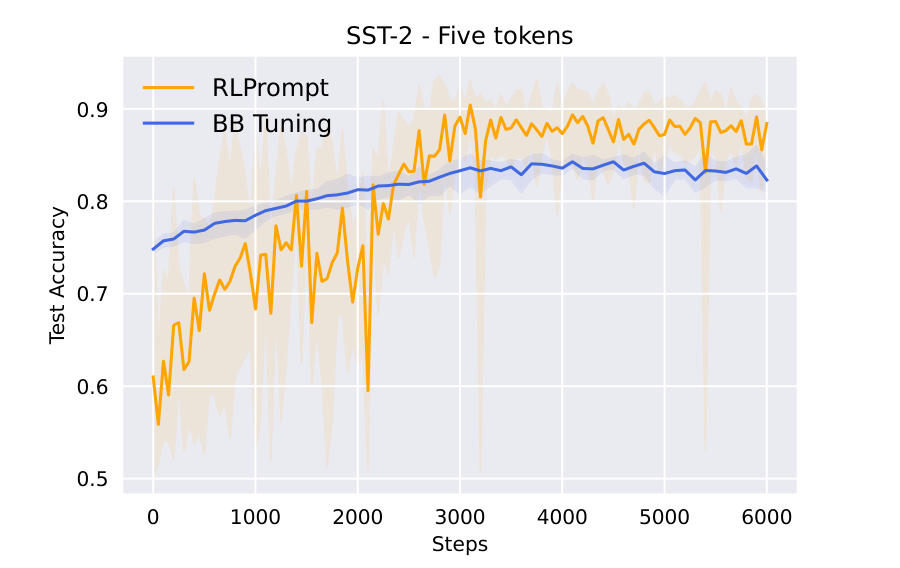
最適化器と対象モデルの区別も必要である。RLPromptは、固定した対象モデルに付ける離散プロンプトを生成する方策を学習する。対象モデルの重みを変えない研究にも、候補生成器の重みを学習する方法は含まれる (Deng ほか 2022年)。図 3 は、生成方策を訓練する間に、得られたプロンプトのテスト正解率が変わる様子を示す。したがって、「強化学習を使う」だけでは、対象モデルを訓練したことにはならない。
研究を比較する五つの問い
各章では、次の問いを共通して使う。
- 何を変えるか。 指示、例示、呼び出し構造、コード、記憶のどれか。何は固定されているか。
- 何から次の候補を作るか。 最終スコア、誤答、批評、途中の実行記録、過去候補など、見せる情報は何か。
- どう探索し、選ぶか。 一度に候補を列挙するか、局所編集を重ねるか、複数の系譜を残すか。
- 何を学習するか。 履歴や候補だけを更新するか、候補生成器や対象モデルの重みも変えるか。
- 実験は何を支持するか。 最終構成の性能、探索効率、未知入力への汎化、別モデルへの転用のどれを測ったか。
これらの問いは、すべての研究を一つの順位表に並べるためのものではない。対象モデル、初期構成、編集の権限、評価予算が異なる研究では、報告された得点を直接比較できないからである。同じ論文内の対照実験やアブレーションを優先し、どの設計要素の効果が分離されているかを読む。
本書の範囲と文献の読み方
プロンプトの生成・評価から始め、固定された複数モジュールの共同最適化、呼び出し構造とコードの探索、経験の再利用、学習された最適化器へと対象を広げる。この順序は、後の研究が前の研究を一律に置き換えたという歴史ではない。何を変更可能にするかによって、異なる研究課題が生じることを示すための順序である。
採択済みの主要会議・査読誌論文を中心とし、Findingsも含める。ワークショップ論文、著者による採択報告だけがある研究、公式採択未確認のプレプリントは、その区分を明記する。確認時点は2026年10月である。新しい研究の存在と、分野横断的な合意があることを混同しない。
メモリを追加すること、毎回の回答を反省すること、対象モデルを訓練することは、いずれも改善に関係する。ただし、それぞれ何を蓄積し、どの入力に対して評価したかが異なる。Reflexionの同一問題への再挑戦と、ExpeLの課題をまたぐ経験利用を区別するのは、このためである (Shinn ほか 2023年; Zhao ほか 2024年)。
最後に、未知の入力での性能、探索費用と実行費用、最適化器自体の比較を整理する。外部評価やデータ分割は、研究を定義する条件ではなく、改善の主張をどこまで信頼できるかを判断するために扱う。目標は、手法名を覚えることではない。新しい論文を読んだときに、何が変わり、なぜ変わり、その実験から何が分かったのかを説明できることである。
図版クレジット
Figure 1: (S. Zhang ほか 2024年)。原図公刊版、Figure 1。© 著者。CC BY 4.0。原図の周囲を切り抜き・ラスタライズ(内容変更なし)。
Figure 2: (Hu ほか 2025年)。原図公刊版、Figure 2。© 著者。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (Deng ほか 2022年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。