最適化器の学習
新しい問題に適した指示やエージェント構成を、そのたびに多数の候補を試さずに作れるだろうか。ここで学習するのは、問題を解く対象モデルではなく、そのモデルに与えるプロンプトや実行構造を生成する側である。大規模言語モデル(Large Language Model, LLM)を固定しても、生成器の重みは学習できる。この区別によって、ハーネス最適化とモデル学習は排他的ではなくなる。
ただし、生成器の学習は、探索・評価・採択を含む最適化器全体を学習したことを意味しない。生成したコードを実行できるか、どの候補を残すか、失敗から再探索するかは、別の固定手続きである場合が多い。本章では、まず離散プロンプトの生成方策と選好学習を比較し、次に質問ごとの複数エージェントシステムの生成へ進む。中心となるのは EMNLP 2022 の RLPrompt、EACL 2026 の MePO、ICML 2025 の MAS-GPT、ICML 2026 の MAS-Architect である。ワークショップ論文の FlowReasoner とプレプリントの Harness-R1 は、学習対象と評価の違いを示す補足として扱う。
候補を探す処理から候補を作る能力へ
たとえば数学問題に対し、単独で解く、別のエージェントに検算させる、複数解を統合する、という構成が考えられる。固定 LLM に候補を提案させる外側の探索では、候補を実行し、その結果を履歴へ戻して次の候補を提案する。履歴や候補集合は変わるが、提案するモデルの重みは変わらない。これに対し学習済み生成器は、過去の問題と良い構成の対応、あるいは構成を実行した報酬によって、次に生成する構成の確率自体を変える。
問題を \(q\)、生成する指示・構成・コードを \(h\)、生成器を \(G_\theta(h\mid q)\)、固定した対象モデルを \(T_\phi\) とする。実行結果に対する報酬を \(R\) とすれば、強化学習(Reinforcement Learning, RL)による生成器の学習は、概念的には次の形である。
\[ \max_\theta\;\mathbb{E}_{q\sim D,\,h\sim G_\theta(\cdot\mid q)} \left[R\bigl(\operatorname{Exec}(T_\phi,h,q)\bigr)\right], \qquad \phi\text{ は固定する}. \]
これは各論文の損失を同一視する式ではない。教師あり学習では良い構成のトークン列を模倣し、選好学習では好ましい書換えと好ましくない書換えの相対確率を学ぶ。RL では実行結果を報酬として生成確率を更新する。どの場合も、対象側へ数値勾配を通すことは必須ではない。離散的なコードや文字列でも、それを生成する方策の重みには勾配を計算できる。
また、全問題に共通のプロンプトを学ぶことと、質問ごとに構成を作ることは異なる。前者では一度得た文字列を配布できる。後者では生成器の呼出しが各質問に必要であり、生成後の複数エージェントの実行費用も残る。表 1 は、この出力単位と教師信号を対応させた比較である。
| 方法 | 学習する部分と出力 | 学習データ・目的 | 新しい問題で残る処理 |
|---|---|---|---|
| RLPrompt | 小さな方策モジュールから離散トークンを生成 | 少数ラベルやスタイル評価を報酬とする soft Q-learning | 分類では学習済み共通プロンプトを利用。生成タスクでは入力条件付き生成も扱う |
| MePO | 7B のプロンプト書換えモデル | Alpaca・BPO 由来の選好対で直接選好最適化 | 質問を書き換え、固定した回答モデルへ渡す |
| MAS-GPT | 32B の質問条件付きシステム生成器 | 実行評価・対応の整合性で作った質問とコードの対を教師あり学習 | 1 回の生成で得たシステムを実行する |
| MAS-Architect | 宣言的構造とノード実装を生成するモデル | 正答する教師コードで初期化後、妥当性・不正検査・正答報酬で RL | 質問別に構造と実装を生成して実行する |
離散プロンプトを報酬または選好から学ぶ
プロンプトの各単語を直接置換する代わりに、次の単語を選ぶ方策を訓練することができる。RLPrompt はこの方法を取り、既出のプロンプトトークンを状態、次のトークンを行動、完成したプロンプトで対象 LLM を動かした結果を報酬とする。対象モデルは固定し、生成側も小規模な事前学習モデルの本体を固定する。その内部表現を変換する小さな多層パーセプトロンだけを学習し、元の語彙出力層から次トークンの分布を得る。論文では on-policy の soft Q-learning を用いる (Deng ほか 2022年, sec. 2.2–2.3)。
図 1 の白いモデル部分は固定され、赤い小さな方策モジュールだけが報酬から更新される。図の二つの対象モデルは、穴埋め型と左から右へ生成する型であり、同じ語列生成の仕組みを異なる対象へつなぐ設計を示す。
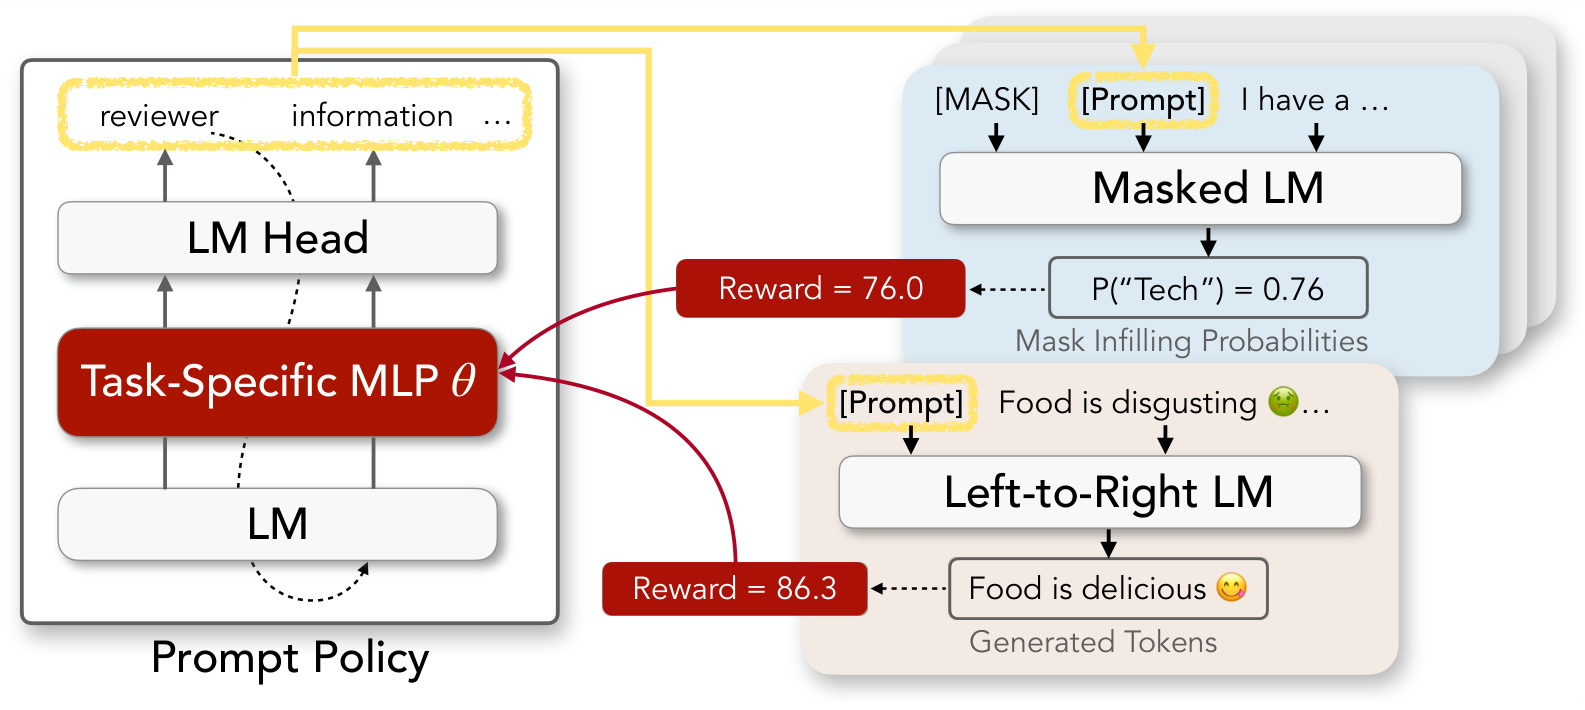
分類では、正解ラベルの確率と最も有力な誤ラベルの確率との差を使い、正しく分類した場合を重く扱う区分的な報酬を設計する。正解確率だけを最大化すると、入力を無視して特定クラスを高確率にする指示でも報酬が上がり得るためである。スタイル変換では内容保持と目的スタイルの強さを評価し、同じ入力に対する複数プロンプトの報酬を平均と標準偏差で正規化する。入力自体の難しさと、プロンプトの良し悪しを分けるための工夫である (Deng ほか 2022年, sec. 2.4)。
学習後の分類では貪欲生成した離散文字列を使えるため、生成器を毎回動かす必要はない。一方、入力条件付きのスタイル変換では入力ごとのプロンプト生成を扱う。得られる文字列が自然な指示になるとは限らず、非文法的な語列も含まれる。したがって離散形式であることと、人間にとって意味が明確であることは同じではない。
実験上も、対象モデルを固定したことと推論費用が小さいことは分けて読む必要がある。Yelp の感情スタイル変換では、GPT-2-xl に対する 5 トークンの RLPrompt が、内容・スタイル・流暢性を合わせた主指標 \(J\) で 61.4、手書きプロンプトが 53.4 であった。ただし両者とも出力候補を 32 個生成し、報酬最大のものを選ぶ条件である。これはプロンプト学習の有効性を示す比較であって、単一出力で同じ性能が得られる証拠ではない (Deng ほか 2022年, Table 3, §3.2)。
別の方法は、毎回対象を実行して報酬を得る代わりに、良い書換えの選好対を先に集めることである。MePO は、明瞭さ、精確さ、簡潔な推論の指示、元の情報の保持という四つの性質を明示し、軽量モデルにプロンプトを改稿させる。Alpaca と BPO を基に、改稿後の回答を DeepSeek-R1 が元回答より高く評価し、かつ所定の品質閾値を満たす対を残す。データは 40,151 件であり、一部の入力を意図的に劣化させて利用者の不完全な指示も模擬する (Zhu ほか 2026年, sec. 2–3, Table 1)。
図 2 は、性質の発見、改稿データの構成、書換え器の訓練という三段階を示す。左の棒グラフは性質の出現頻度であり、正答率でも、各性質を除去した効果でもない。右端で学習するのは回答そのものではなく、入力指示を書き換える生成器である。
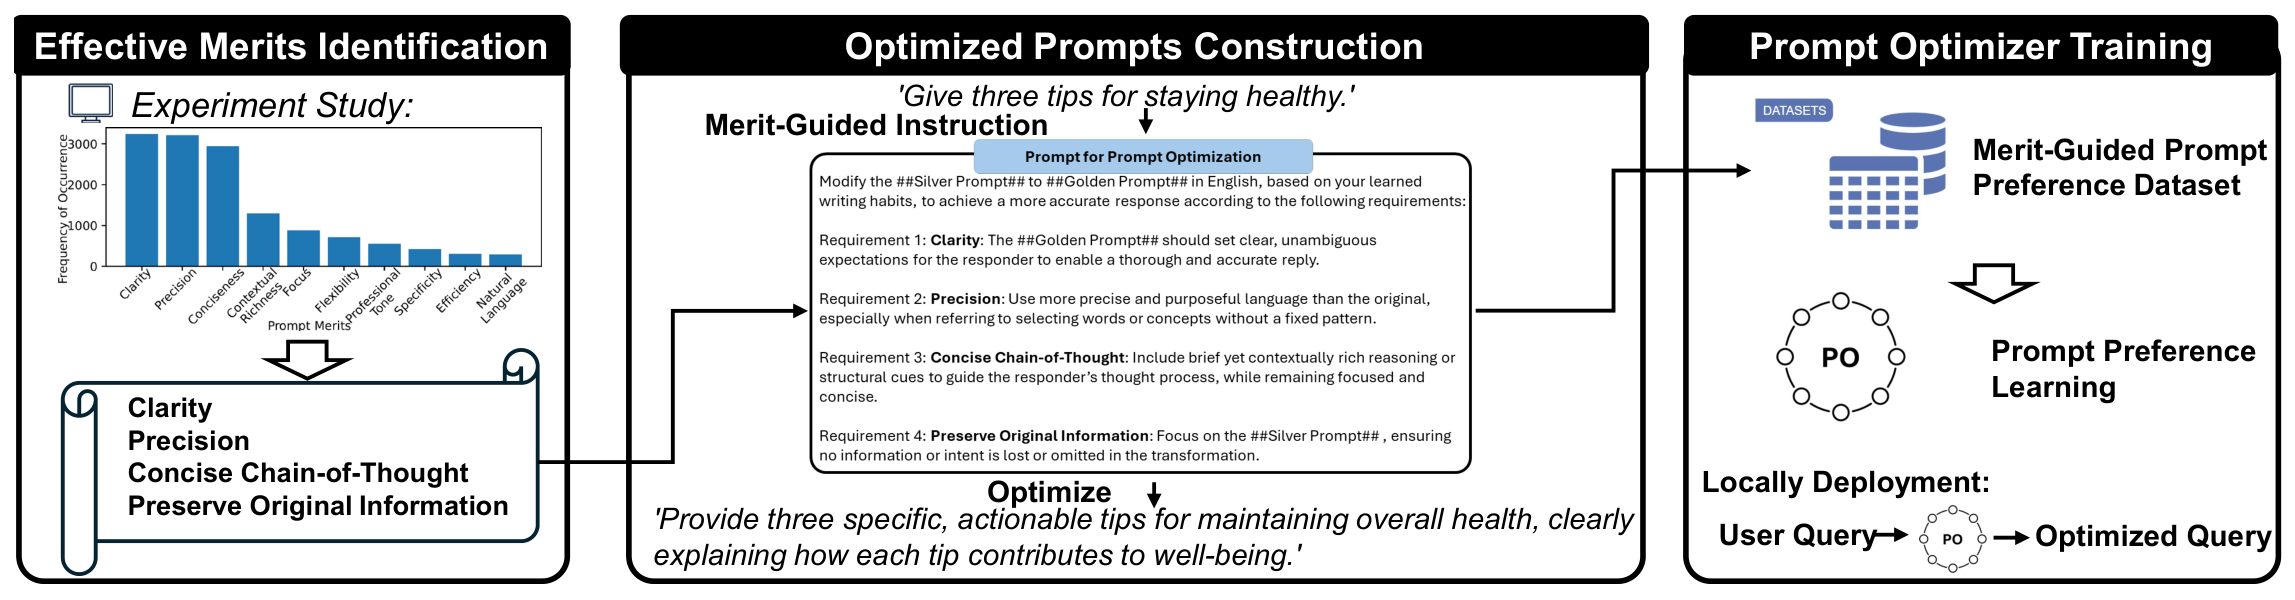
訓練では Qwen2.5-7B-Instruct を基に、直接選好最適化(Direct Preference Optimization, DPO)によって、元のプロンプトより改稿後のプロンプトを出力しやすくする。回答はデータを選別する根拠であり、回答モデル自身を DPO で訓練するわけではない。評価時にはテスト質問の部分だけを書き換え、他の例示などは固定する。RLPrompt のように特定対象から継続的に報酬を受ける学習と異なり、多様な質問に対する書換え能力をオフラインで学ぶ設計である。
この設計は配備時に外部最適化 API へ依存せず、ローカルに書換え器を置ける利点を持つ。ただしデータの選別や性質の発見には大規模な評価モデルを使っている。「ローカルに動く」と「開発全体が外部モデル不要」は区別すべきである。また四つの性質は、すべてのタスクに普遍的な最適性条件ではない。
MePO の Table 4 は、静的な性質の指示で回答モデル自身に書き換えさせる学習なし条件とも比較する。Qwen3-8B の五系列の課題平均は学習なしが 76.28、MePO が 76.88、LLaMA2-7B-chat では 37.13 と 39.66 である。学習後に一貫した上積みがある一方、その大きさは対象によって異なる。さらに Table 5 の性質除去実験は学習なしのテンプレート条件であり、DPO の学習データから各性質だけを除いた実験ではない (Zhu ほか 2026年, sec. 4.4–4.5)。
質問ごとのシステムを模倣から探索へ進める
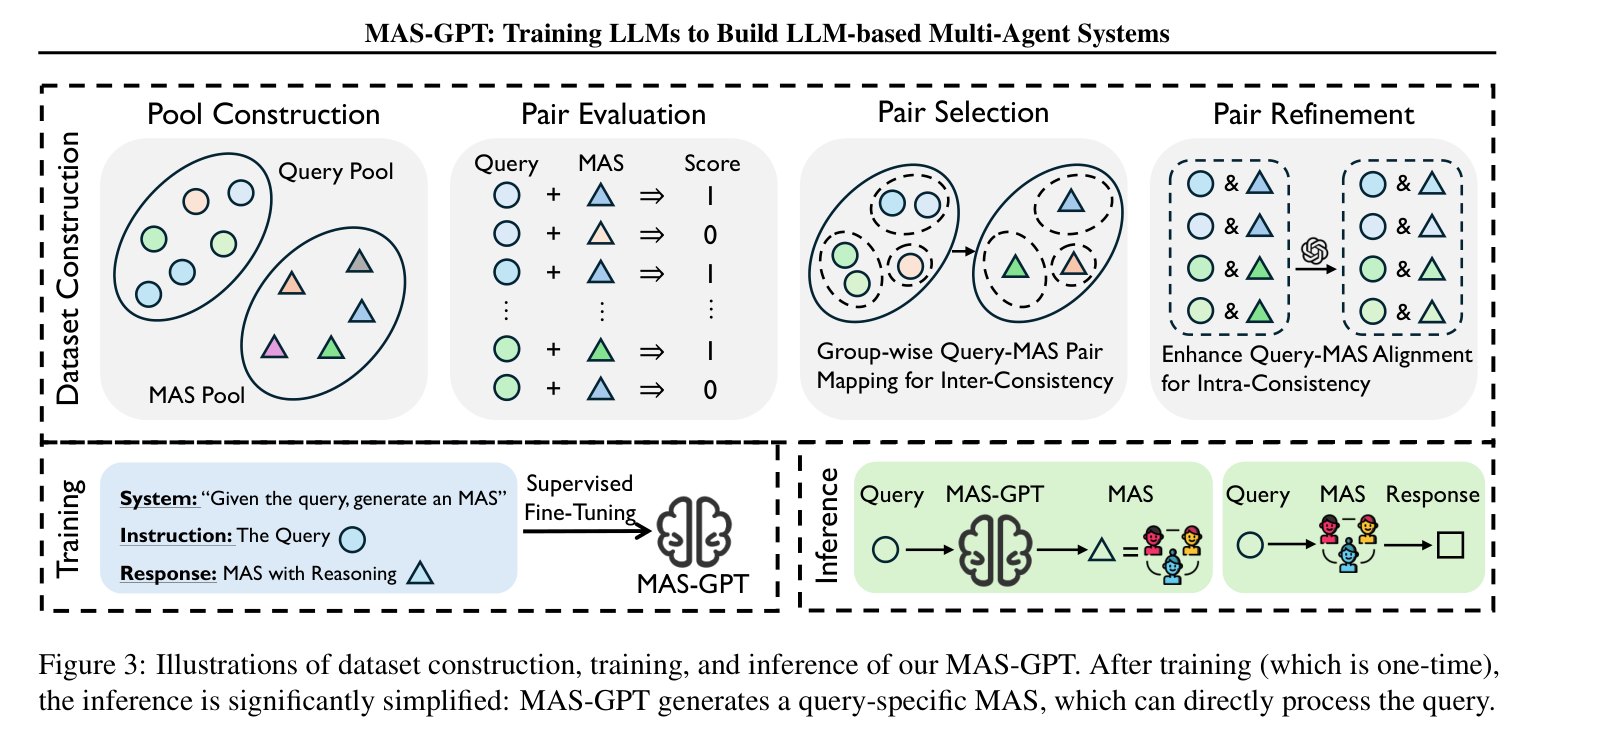
複数エージェントの役割や通信を一つの文字列では表しにくい場合、実行可能コードを教師にできる。MAS-GPT は、質問を受け取り最終回答を返す Python の関数で複数エージェントシステム(Multi-Agent System, MAS)を表す。変数が役割別のプロンプト、関数呼出しが LLM の実行、文字列の結合がエージェント間の情報伝達に対応する。生成器は回答そのものではなく、この実行可能なシステムを出力する (Ye ほか 2025年, sec. 3)。
重要なのは教師データの作り方である。まず検証可能な質問群と 40 種類以上の基本構成を用意し、質問と構成の組合せを実行して正誤を記録する。同じ質問に多数の異なる正答構成を無差別に割り当てると、教師信号が曖昧になる。そこで似た質問をまとめ、グループ内の合計成績が良い構成を代表として選ぶ。さらに強い LLM が質問に合わせて役割を修正し、なぜその構成が適するかという説明を添える。修正した構成は再実行し、元より成績が悪化しない場合に採用する。
得られた 11,442 件の質問・説明・コードを用い、Qwen2.5-Coder-32B-Instruct を教師あり微調整する。新しい質問では 1 回の生成でシステムを作れるが、その後の各エージェントの呼出しまで 1 回になるわけではない。また初期の構成群から学習するものの、推論時にその群から一つを選択するだけの分類器ではなく、コードを生成するモデルである (Ye ほか 2025年, Tables 1-2)。
Llama-3-70B-Instruct を実行側に置いた Table 1 では、八つのベンチマーク平均が単独モデルの 59.83 から MAS-GPT の 65.47 になる。同じ表では、学習領域外とした HumanEval が 79.01 から 80.25、SciBench が 21.05 から 24.21 となる一方、自己整合性を用いた GSM8K の 94.99 は MAS-GPT の 93.39 より高い。生成器の学習が全課題で既存構成を上回るわけではない。領域外の成績は、学習済み生成器と実行モデルを組み合わせたシステムの転移であり、基盤モデルの事前学習から完全に未知であることを示すものでもない。
教師の構成を模倣するだけでは、その教師が示さなかった構造を積極的に改善する信号がない。MAS-Architect は、構造の表現と学習方法の両方を変更する。宣言的な構造層にノード、条件付き接続、ループ、共有状態の型を記述し、実装層で各ノードの役割、ツール、推論手順を実現する。これにより、接続と処理内容が一続きの命令型コードに埋まる場合よりも、何を接続し何を実行するかを分けて生成できる (Huang ほか 2026年, sec. 3.1–3.2)。
学習は二段階である。最初に大規模な教師が作る宣言的コードを実行し、正答するものだけを残して教師あり微調整する。次に同じ質問から複数の候補を生成し、コンパイルと実行ができるか、回答の埋込みなどの不正がないか、最終回答が正しいかを評価し、その報酬に基づく強化学習で構成生成方策を更新する。不正または無効なら報酬は 0、妥当だが誤答なら 0.1、正答なら 1 である。更新するのは構成生成器であり、生成した各エージェントを駆動する対象モデルではない。教師あり段階は MMLU と HotpotQA、RL 段階はそれらと GSM8K の問題を使う (Huang ほか 2026年, sec. 3.3, Eq. 8, §4.1)。
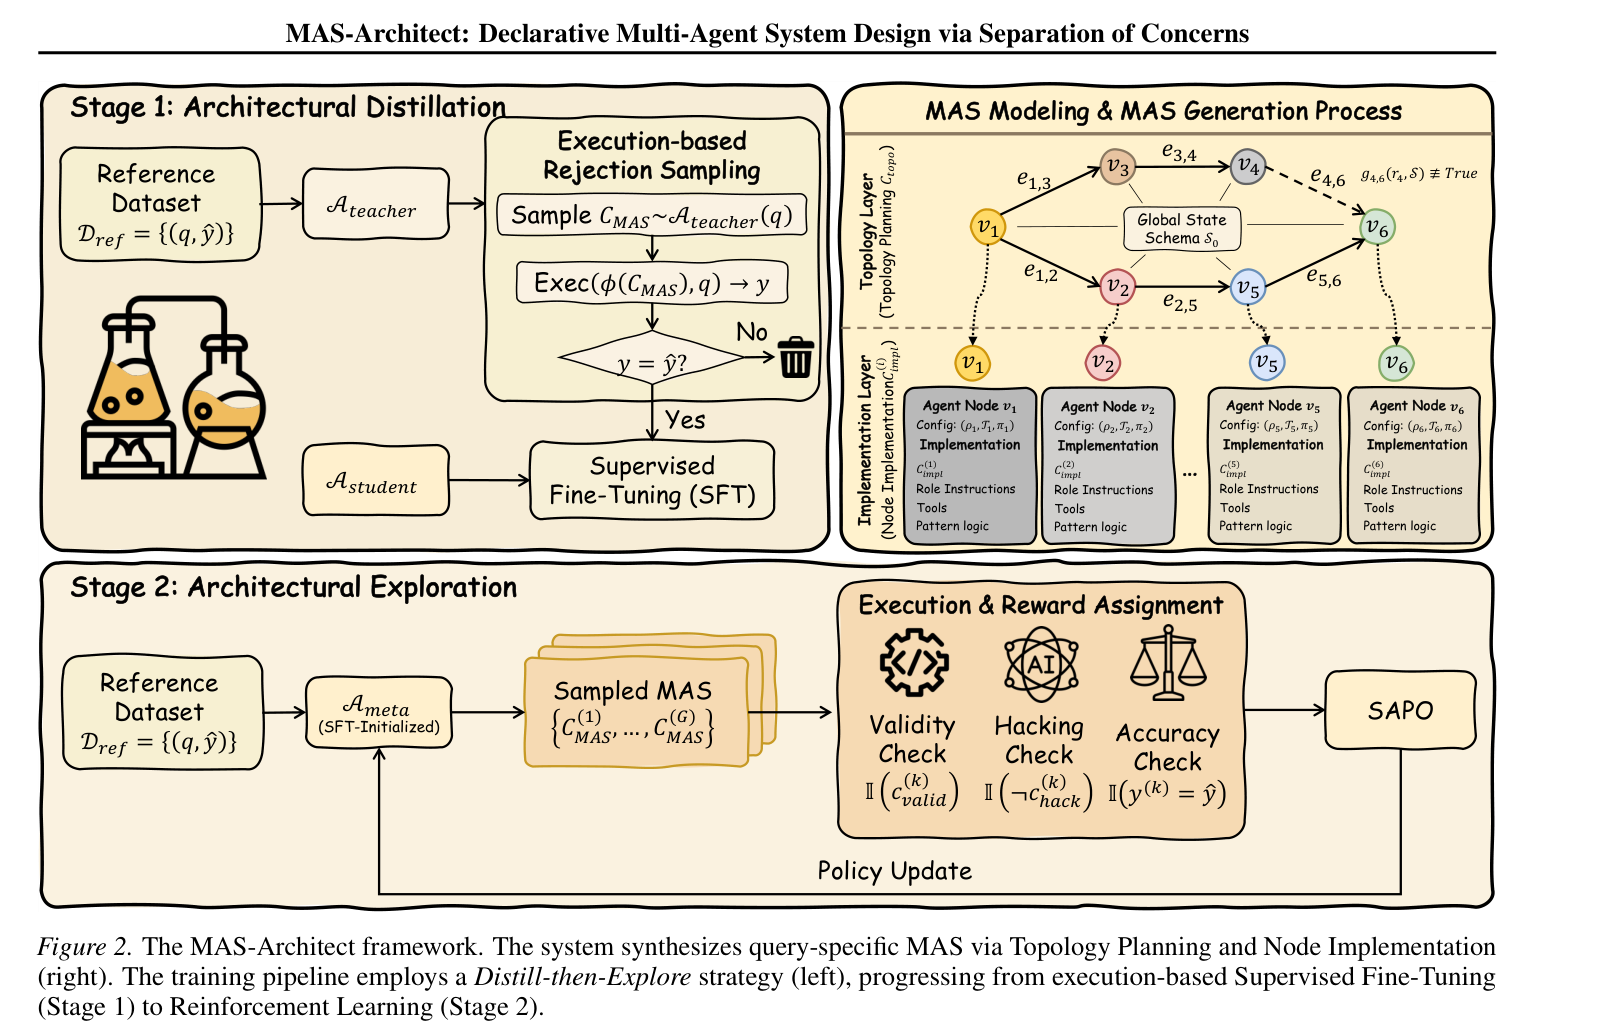
実行側を Qwen3-4B-Instruct-2507 とした Table 2 では、MATH の正答率が単独条件 82.1、教師あり段階 83.3、RL 後 89.5 である。学習データに MATH を含めない設定で、模倣後にも改善することを示す。ただしこれは宣言的表現と RL を含む手法内の段階比較であり、表現だけの純粋な効果を切り出したものではない。GPQA は主結果の Table 1 が 63.8、段階比較の Table 2 が 64.1 と異なるため、一つの数値系列として混ぜない (Huang ほか 2026年, Tables 1-2)。
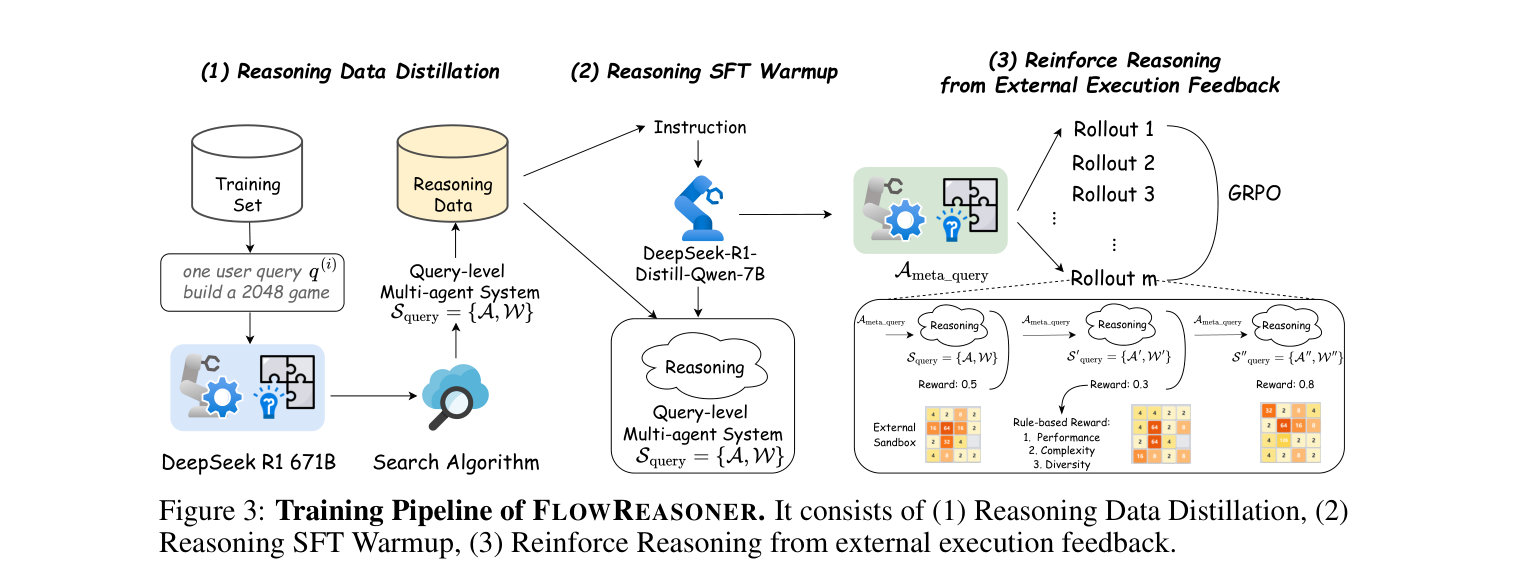
外部実行による追加学習の別例が FlowReasoner である。これはワークショップ論文として位置づけ、ここで参照する arXiv 版の結果を主会議論文と同列には扱わない。DeepSeek-R1 の複数ラウンドの構成推論を蒸留して初期化し、生成コードの実行フィードバックを用いたグループ相対方策最適化(Group Relative Policy Optimization, GRPO)で生成器を更新する。報酬はテスト通過率、抽象構文木に基づく複雑さ、多様性を組み合わせる。推論時にも外部テストを用いる複数ラウンドの構成改良を行うため、MAS-GPT の単発生成と同じ推論予算ではない。Table 2 の 14B 条件では三つのコード課題の Overall が教師あり学習の 81.50 から RL 後の 81.89 となる。この結果から、RL の追加効果が常に大きいとは言えない (Gao ほか 2025年, sec. 4.1–4.3, Table 2)。 図 5 の三段階は、教師の推論を模倣する段階と、実行報酬から生成器をさらに改善する段階を区別している。
再利用手順の生成と実行方策の学習を分ける
学習される生成器は、質問ごとの新規システムだけを作るわけではない。MetaFlowLLM は、既存の二つのタスクとその手順から、共通部分を静的な操作として残し、違う部分を動的なエージェントへ委ねる上位手順を作る。生成器 MetaFlowGen は、統合した手順がすべての元タスクのテストを通る教師例で初期化される。その後は、元タスクの正答割合と静的操作の保持割合を合わせた報酬で GRPO を行う。後者は二つの入力手順の静的操作数の小さい方に対する比であり、単純な LLM 呼出し回数の直接最小化ではない (Fan ほか 2025年, sec. 3.2, Eqs. 3-5)。
ここでは生成器の重みを更新する学習と、生成済みの手順を統合・検索する経験木の更新が併存する。経験木へ節点を追加すること自体は重みの訓練ではない。記憶の保持単位と検索・実行の詳細は経験の再利用で扱う。
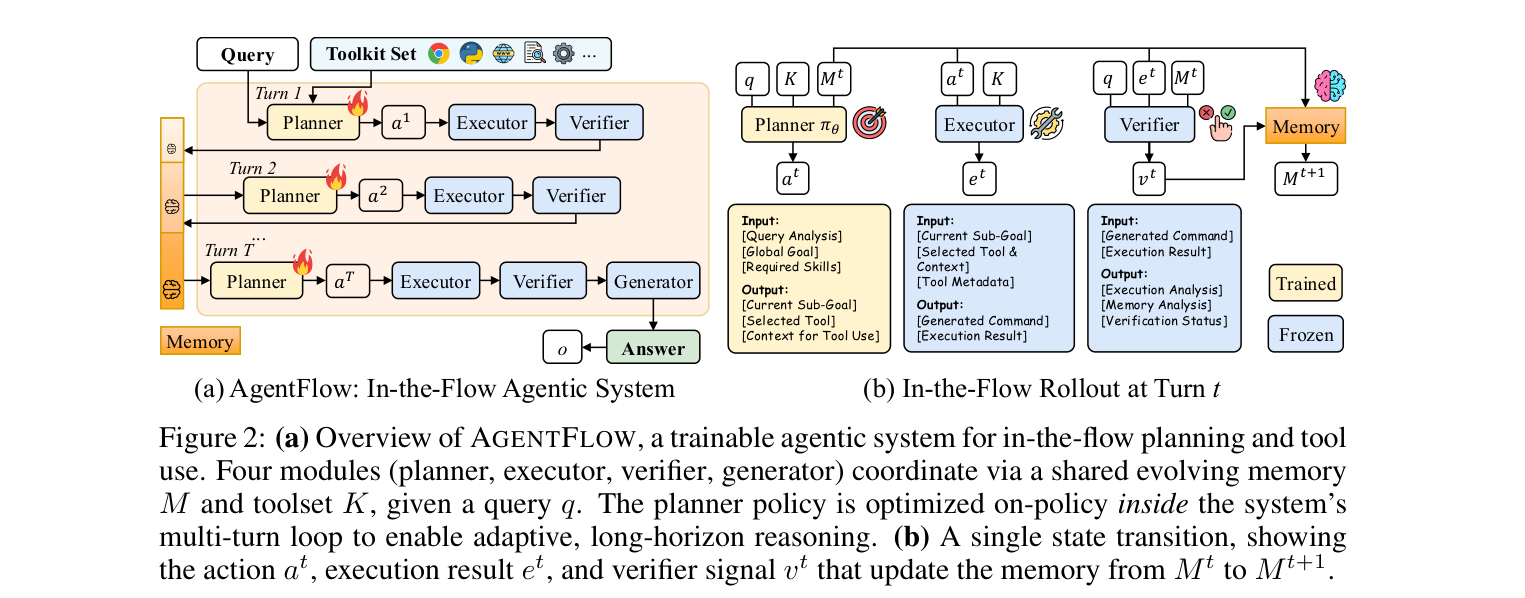
一方、実行の中で計画を立てるモデルを訓練する研究も、比較から除くべきではない。AgentFlow は計画器、ツール実行器、検証器、回答生成器を共有メモリで接続し、計画器がサブゴールとツールを選ぶ。Flow-GRPO は最終回答の正誤を各ターンへ配り、実際の複数ターン実行から計画器を更新する。生成するのは後で別の固定対象に適用する構成ではなく、その場で実行される行動である。したがって、これは対象側の実行方策の重みを学ぶ設計であり、固定対象向けのハーネス生成器ではない (Li ほか 2026年, sec. 3.1–3.2)。 図 6 の学習・固定の区別は、再利用コードを作る外側の生成器ではなく、実行中の計画器を学ぶことを明確にする。
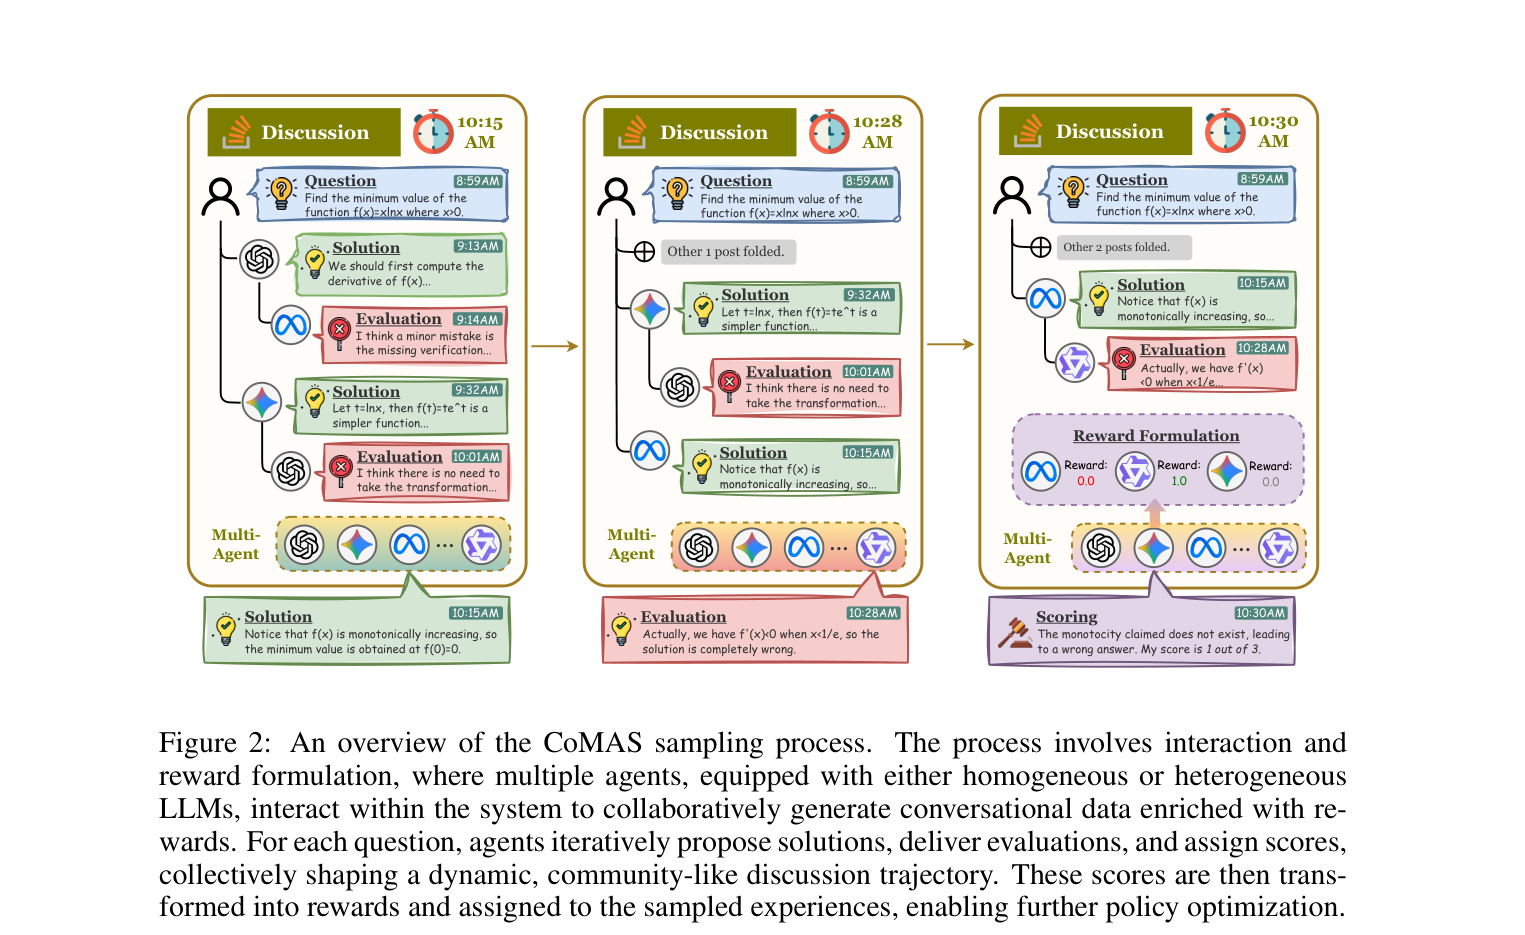
CoMAS も、外側のコード生成器を学ぶ方法ではない。複数エージェントが解答、批評、採点を交わし、採点結果から解答と批評へ相補的な報酬を割り当てる。解答が高評価なら解答側、致命的な誤りを発見すれば批評側が報われる。採点形式の失敗にも罰則を与え、REINFORCE++ で参加エージェント自身の重みを更新する。外部正解を毎回要求せず対話から学習信号を作るが、内部採点が真の正しさと一致するかという問題は残る。この違いは、「エージェントを改善する」という共通目的の下でも、誰の重みを変えるのかを明記する必要を示す (Xue ほか 2026年, sec. 3.1–3.3)。 図 7 の対話から報酬形成への流れは、採点のやり取り自体が学習信号の一部になる理由を示している。
実行環境の修正を学ぶ場合の評価
生成物をシステムの構成から実行時の修正コードへ広げると、正しそうな修正と実際に効く修正の隔たりがさらに問題になる。プレプリントの Harness-R1 は、固定対象の失敗記録から、エピソード開始、判断直前、行動直前、フィードバック後に介入するコードを生成する専用モデルを学習する。修正は入力文脈の補足、行動の正規化や拒否、停止状態からの復旧などに使われ、対象モデルの重みを変更しない (Shao ほか 2026年, sec. 3)。
初期化では教師による有効かつ非悪化の修正を残して教師あり学習する。RL では一つの失敗集約から八つの候補を生成し、各候補を独立に導入して固定対象を再実行する。報酬は、失敗例だけでなく元々成功した例も含む同じバッチ全体の平均報酬差である。無効、実質的な変更なし、評価未完了の候補には 0 を与える。もともと成功したタスクを壊す変更も測る点は重要である。
ただし、この学習報酬は同じバッチで測る改善であり、未知タスクへの汎化そのものではない。別途、各環境の失敗 10 件だけから修正を一つ作り、その証拠に含めなかったタスクへ適用する実験がある。図 8 は、修正の再利用を問うこの評価である。
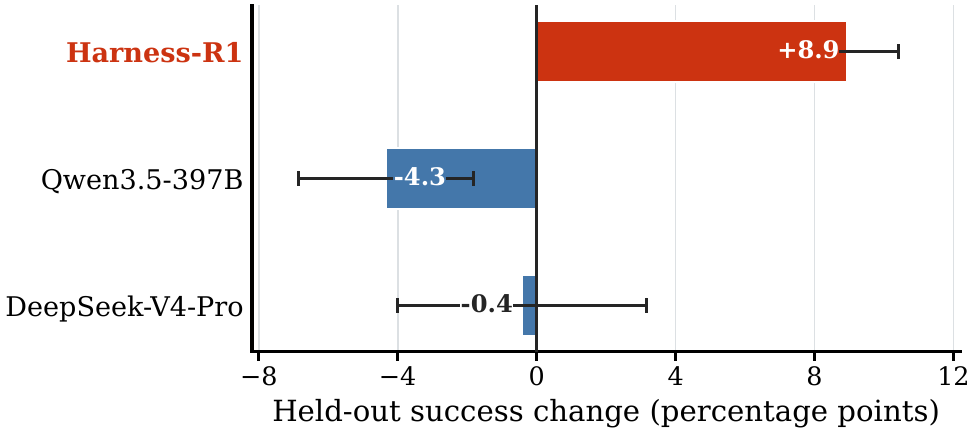
この評価は WebShop、ALFWorld、DBBench の残り 1,270 タスクをプールした値であり、環境ごとの成績を等重みで平均する別の集計とは異なる。変化量はそれぞれ +8.9 ± 1.5、−4.3 ± 2.5、−0.4 ± 3.6 ポイントである。対応する対象・失敗証拠で、学習済み修正器と大規模な固定修正器に差が出る例だが、同じ条件の独立再現や一般的な標準評価が確立したことを示さない (Shao ほか 2026年, sec. 4.4, Table F.1)。
学習によって移る費用と汎化の負担
生成器の学習は、新しい問題ごとの探索を、訓練時のデータ収集と実行評価へ移す。MAS-GPT のように生成を一度にまとめられる場合でも、教師用の質問と構成の組合せの実行費用が先に発生する。RL では候補ごとの対象実行が必要になり、MePO のようなオフライン方式でも選好データと評価モデルの費用が必要になる。訓練費用を多数の利用へ分散できるかは、利用回数だけでなく、対象モデルやツールの仕様がどれほど維持されるかにも依存する。
汎化の問題も二重になる。第一に、生成された指示や構成が新しいタスクで役立つか。第二に、学習済み生成器が、新しい対象モデル、ツール、失敗の型に対して有効な構成を作れるかである。特定対象の報酬を直接使う RLPrompt と、一般的な書換え対を用いる MePO、実行可能構造を学ぶ MAS-GPT と MAS-Architect では、この負担を受け持つデータと評価器が異なる。単一の転移スコアにまとめると、その違いを見落とす。
残る科学的な問いは、同じ対象、利用回数、データ、訓練と探索を含めた総予算をそろえたときに、どの条件で学習済み生成器が固定 LLM による外側の探索より有利になるかである。現時点の結果は学習可能性と個別条件での有効性を示すが、「最適化器も訓練すれば常に良くなる」という結論ではない。
図版クレジット
Figure 1: (Deng ほか 2022年)。原図公刊版、Figure 1。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 4: (Zhu ほか 2026年)。原図公刊版、Figure 4。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 3: (Ye ほか 2025年)。原図公刊版、Figure 3。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (Huang ほか 2026年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 4a: (Shao ほか 2026年)。原図プレプリント、Figure 4a。CC BY 4.0。該当パネルを切り抜き。
Figure 3: (Gao ほか 2025年)。原図論文PDF、Figure 3。原図を切り抜き・ラスタライズ。
Figure 2: (Li ほか 2026年)。原図論文PDF、Figure 2。原図を切り抜き・ラスタライズ。
Figure 2: (Xue ほか 2026年)。原図論文PDF、Figure 2。原図を切り抜き・ラスタライズ。