候補コードの探索
動く候補ができたら、それを磨くべきか、別の方向を試すべきか。答えは、どの候補のスコアが高いかだけでなく、そこから有効な変更を作れるかにも依存する。親候補を選ぶことと、変更を生成することは、探索の別々の部分である。
概要の分類器なら、以前の前処理の版へ戻ることが親の選択であり、欠損値の補完法を置き換えることが変更の生成である。複数の版を残す価値は、履歴の節点数ではなく、実質的に異なる次の実験を得られるかで決まる。
出発点を選ぶ
貪欲な選択は、測定済みの有効な候補のうち、もっともよいものを優先する。過去の候補を消すことや、新しい初期案を禁じることではない。AIDEは複数のスクリプトから始め、失敗した枝も修正する一方、改良では最高スコアの有効な候補を優先する (Jiang ほか 2025年)。
モンテカルロ木探索(Monte Carlo tree search, MCTS)は、訪問回数や枝の価値の推定も使い、有望な候補の再訪と、調べ足りない枝の探索を配分する。進化的探索は候補集団を維持し、変更や組合せで新しい候補を作る。これらは実験を配分する手続きである。実際に何を試すかは、作成、修復、改良、結合を行う操作によって決まる。
AIRAは、この二つを分けて比較した。図 1 のR1の棒を比べると、AIDEの変更操作を固定した場合、貪欲選択をMCTSや進化的探索へ替えても、明確な改善は得られなかった (Toledo ほか 2025年)。
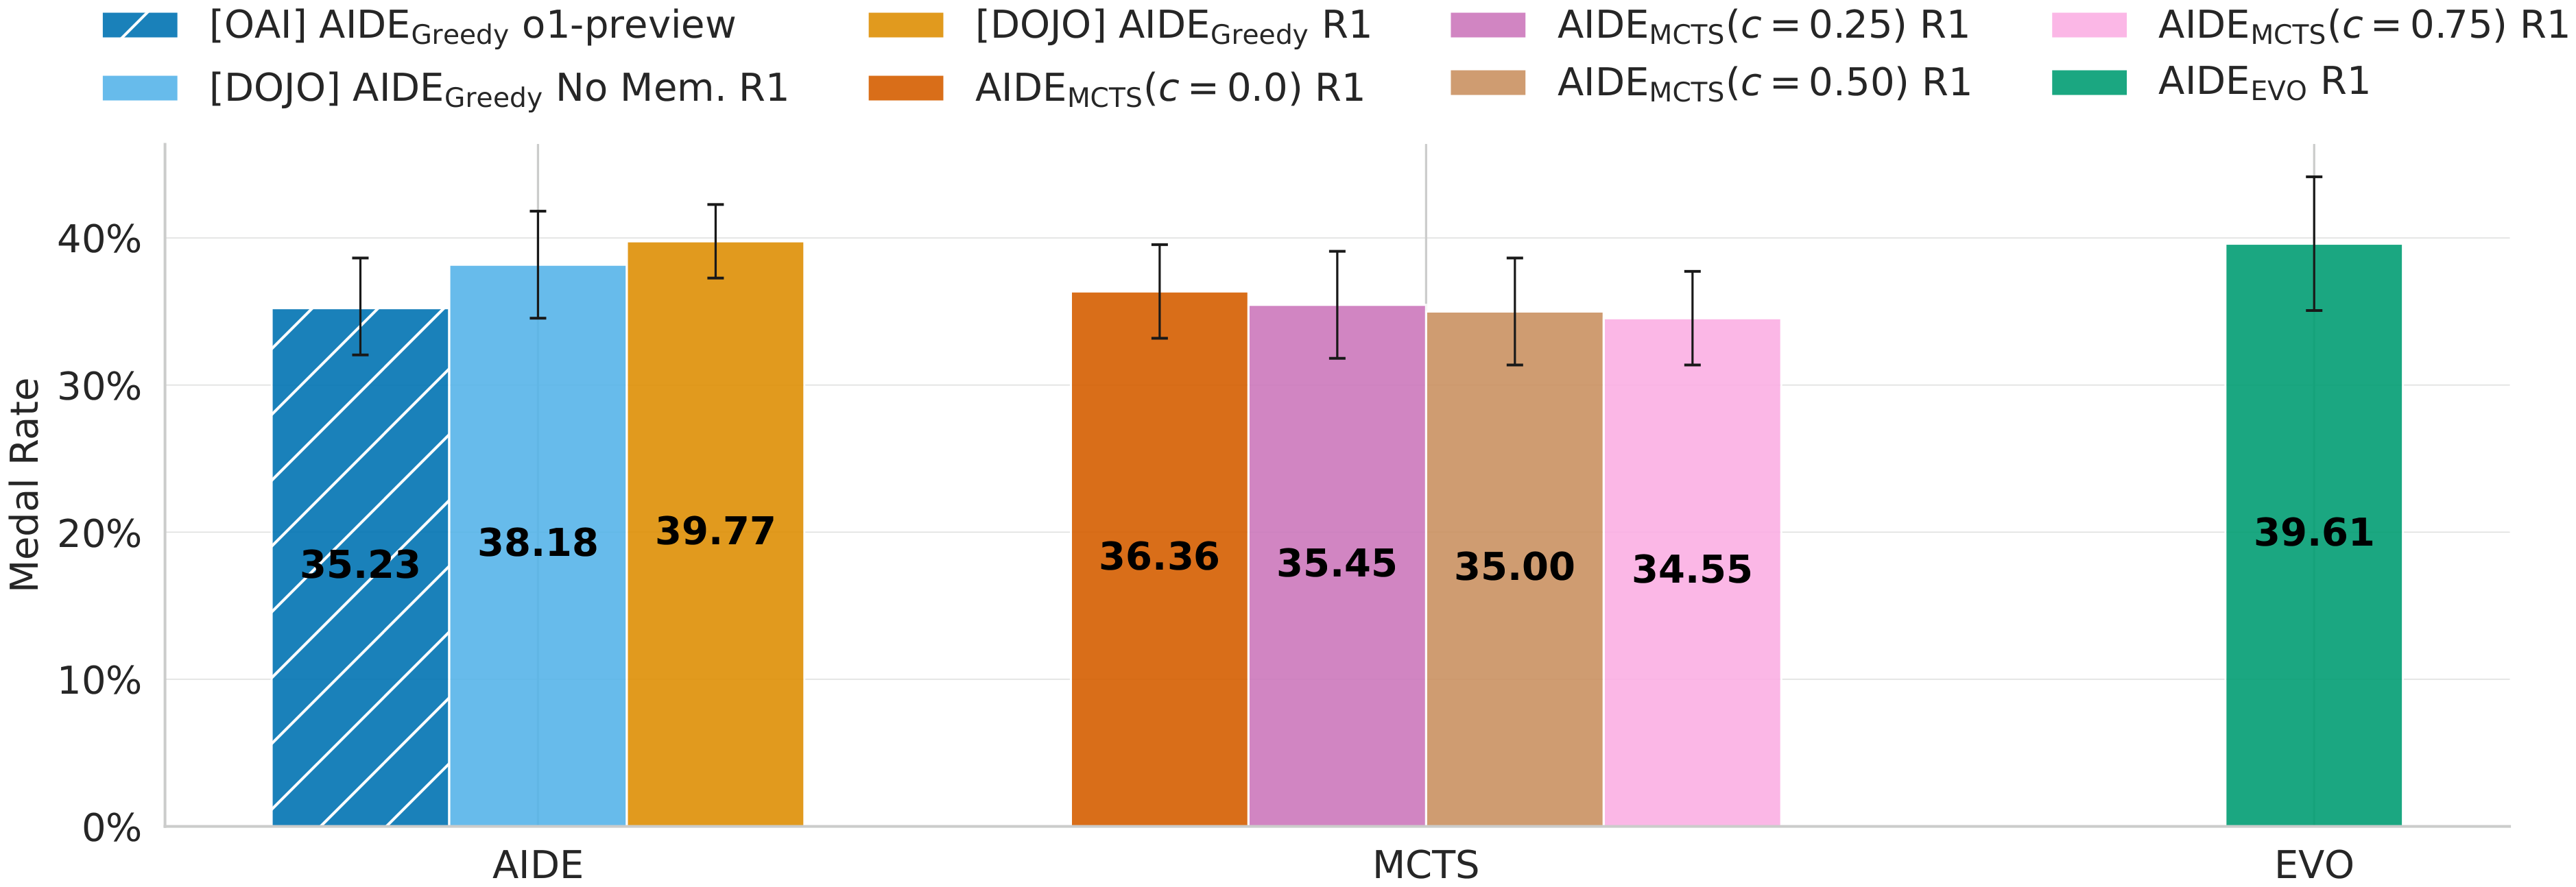
一方、貪欲選択を保って変更操作を替えると改善した。MLE-bench Liteの22課題、DeepSeek R1、24時間、H200一基の条件では、メダル率は39.8%から45.5%へ上がった。改善した操作を使うMCTSは約47%であった。重要なのは両者の関係である。探索方策は、変更操作が作れる機会しか活用できない。
改善した操作は、入力する履歴を使い分ける。初期案の作成と改良には兄弟候補を渡して重複を避け、デバッグには修復の祖先履歴を渡して過去の修正を取り消さないようにする。指示も変更の複雑さや推論量を調整する。出力トークンはおよそ倍になっており、記憶範囲だけを分離した比較ではない (Toledo ほか 2025年)。
変更する場所を選ぶ
動くパイプラインにも複数の改良余地がある。スクリプト全体を漠然とよくするよう求める代わりに、部品を選んでから、その中の代替案を比べられる。
MLE-STARは、図 2 の二重の反復でこれを行う。外側では部品を除去・変更するアブレーションを行い、対象のコードブロックを選ぶ。内側では、そのブロックの改良案を複数作って評価する。各案は同じ出発時点のブロックを置き換えるので、案同士を比較できる。最高の案が現在の解法を上回る場合にだけ、次の外側の反復へ持ち越す (Nam ほか 2025年)。
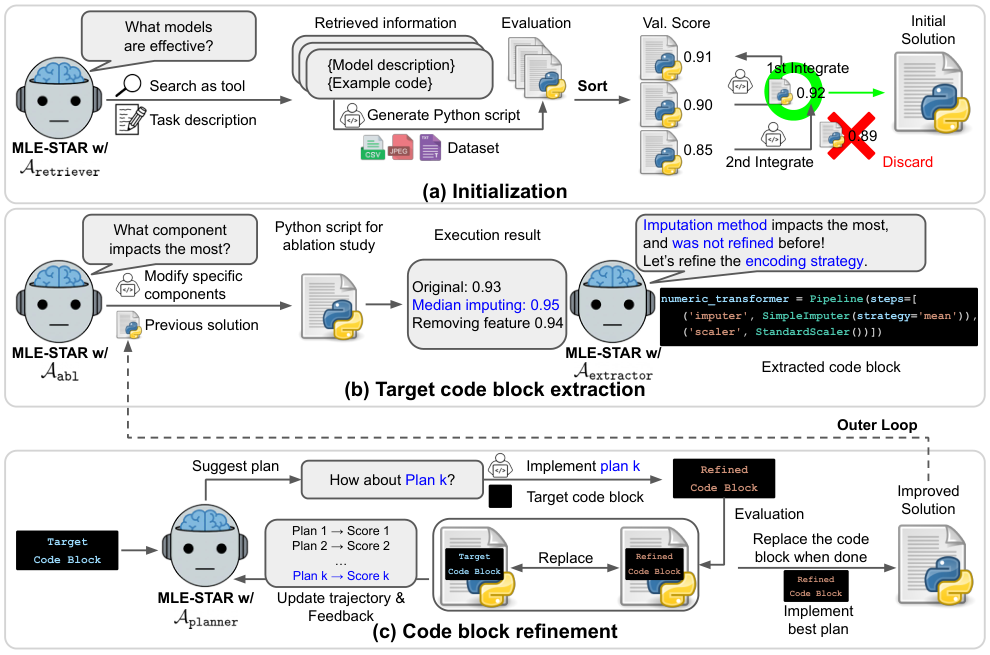
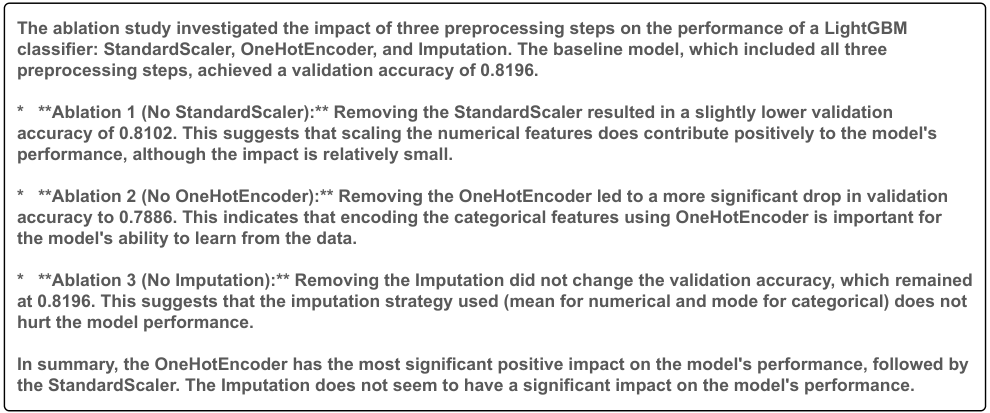
図 3 の分類器の例では、one-hot符号化を除くと検証正解率が下がる一方、欠損値補完を除いても変わらない。この違いは、符号化を調べる理由になる。ただし、除去による大幅な悪化が示すのは、現在の実装への依存である。今後どれだけ改善できるかを直接示すわけではない。
最後の操作は、一つのパイプラインの選択とは限らない。MLE-STARは、独立に作った解法の予測を組み合わせるアンサンブル案も試す。図 4 の反復では、一つの親を選ぶだけでなく、過去の組合せの結果を次の提案と評価へ返す。
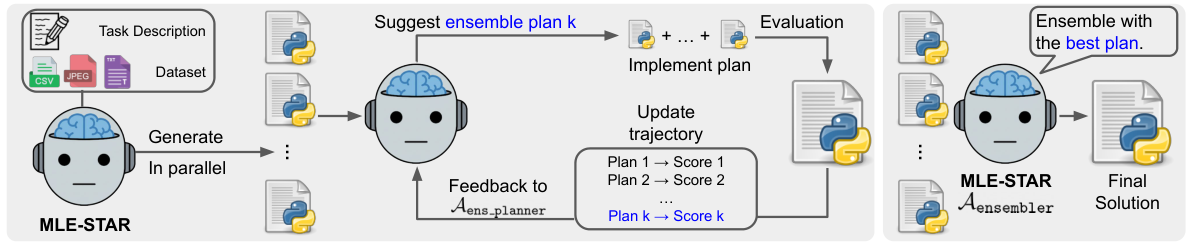
Gemini-2.0-Flashを使ったMLE-bench Liteの3シードの実験では、この最終段階なしのメダル率は37.9%、複数の解法から最高の一つを選ぶbest-of-Nは42.4%、予測の平均化と提案したアンサンブル探索はともに43.9%であった。提案手法は平均化より金メダルが多いが、全指標で上回るわけではない。一つの最高候補を選ぶだけでなく、異なる解法の予測を組み合わせることにも価値がある (Nam ほか 2025年)。
実行結果から変更案を作る
スコアは候補の優劣を示す。ログやコード差分は、次に何を試すかの手掛かりになる。この推論は、木探索の中でも、単純な改良の連続でも行える。
ML-MasterはMCTSと、選択した親・兄弟候補の情報を組み合わせる。直前の親と同じ深さの並列の兄弟候補に絞り、計画、コード、スコア、実行時の観察を次の提案に渡す。図 5 の推論とコード生成へ向かう矢印は、この情報の流れを表す。推論から抽出した要点と実行結果は、モデルが次の変更を考えるための文脈へ組み込む (Liu ほか 2025年)。
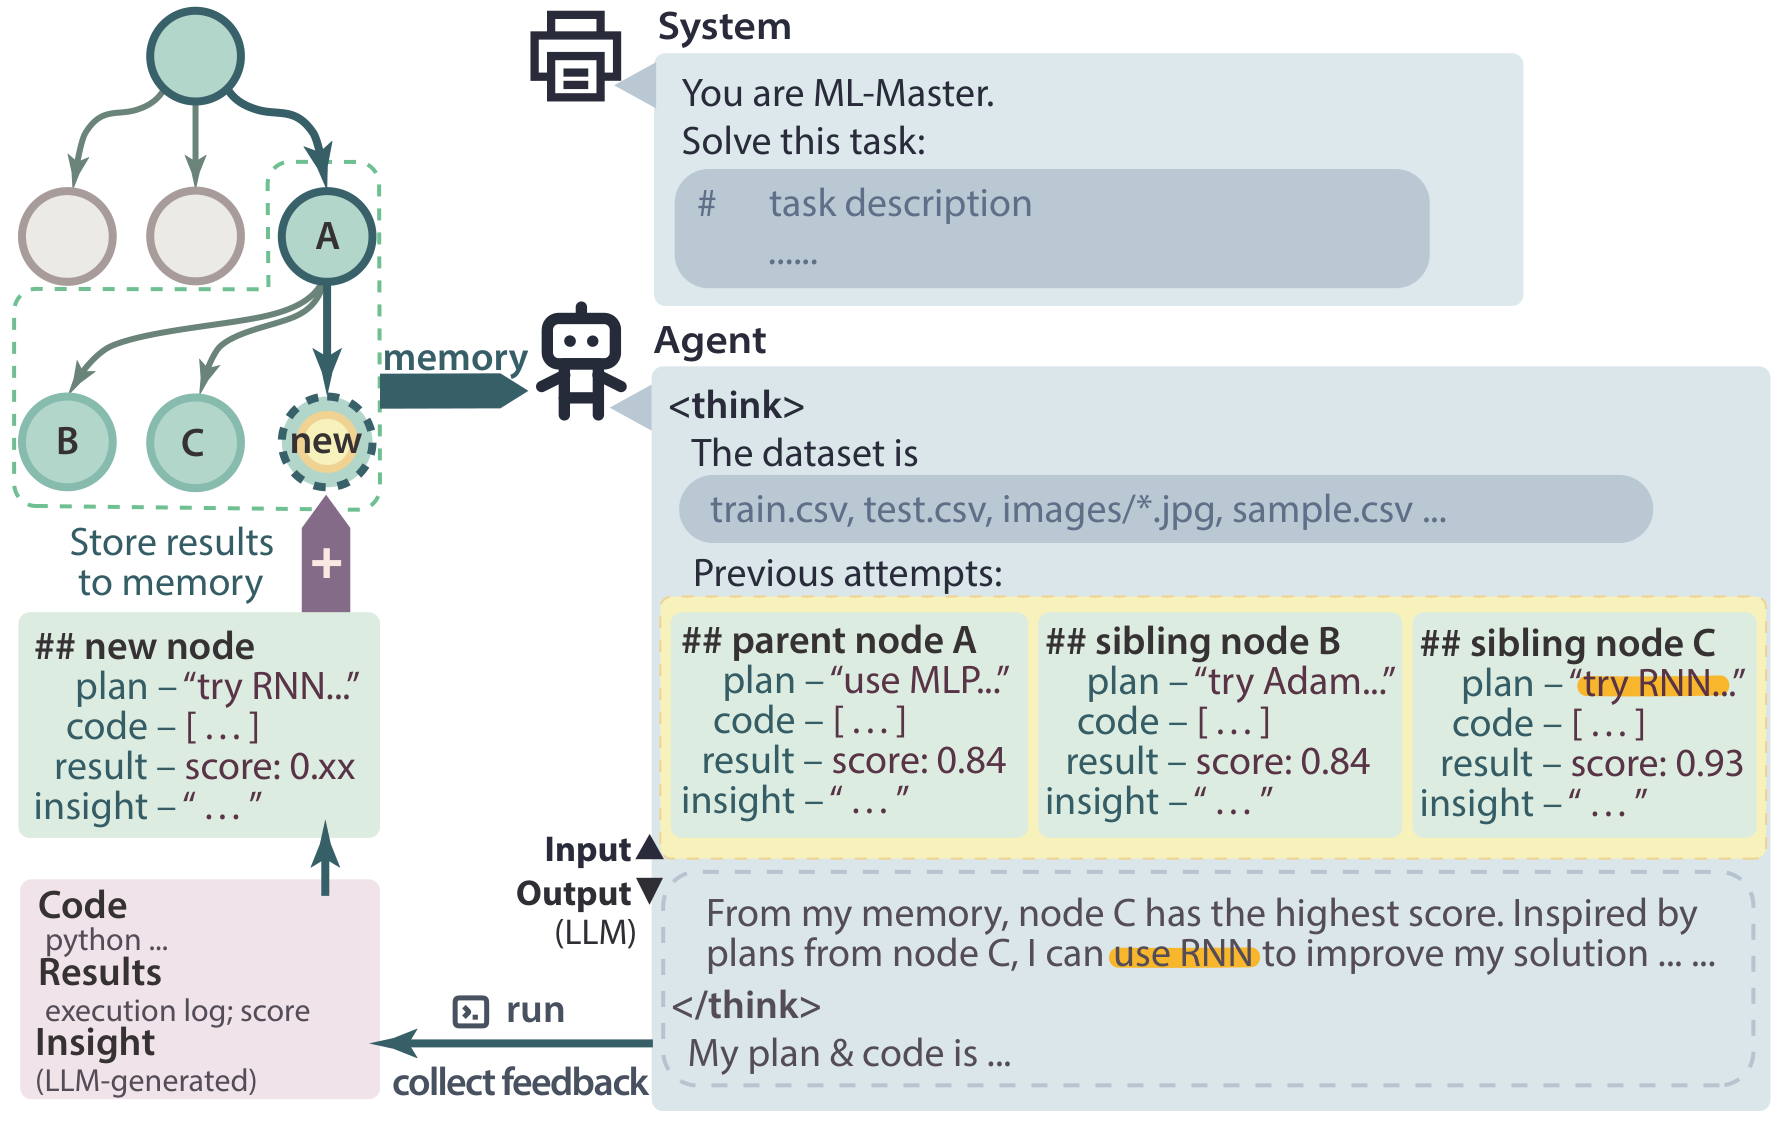
遅い兄弟候補からは、有効な特徴量と、予算に収まらない実装の両方が分かる。失敗した候補からは、有望なライブラリが環境に適合しないと分かるかもしれない。数値の順位だけでは、どちらも表せない。ML-Masterはこの設計の具体例だが、報告は部品別のアブレーションを後に回しており、記憶単独の寄与までは示していない。
Gomeは、変更案を作る過程をさらに明示する。図 6 の各段階は、コード差分、ログ、測定結果から問題点を抽出し、仮説を生成して優先順位を付け、一つの変更へ絞る。並列の軌跡は採用した成功を共有する。仮説と結果を共有記憶へ入れる前に、出力形式、評価との整合性、意図した効果を確認し、スコアが上がるだけでは採用しない (Zhang ほか 2026年)。
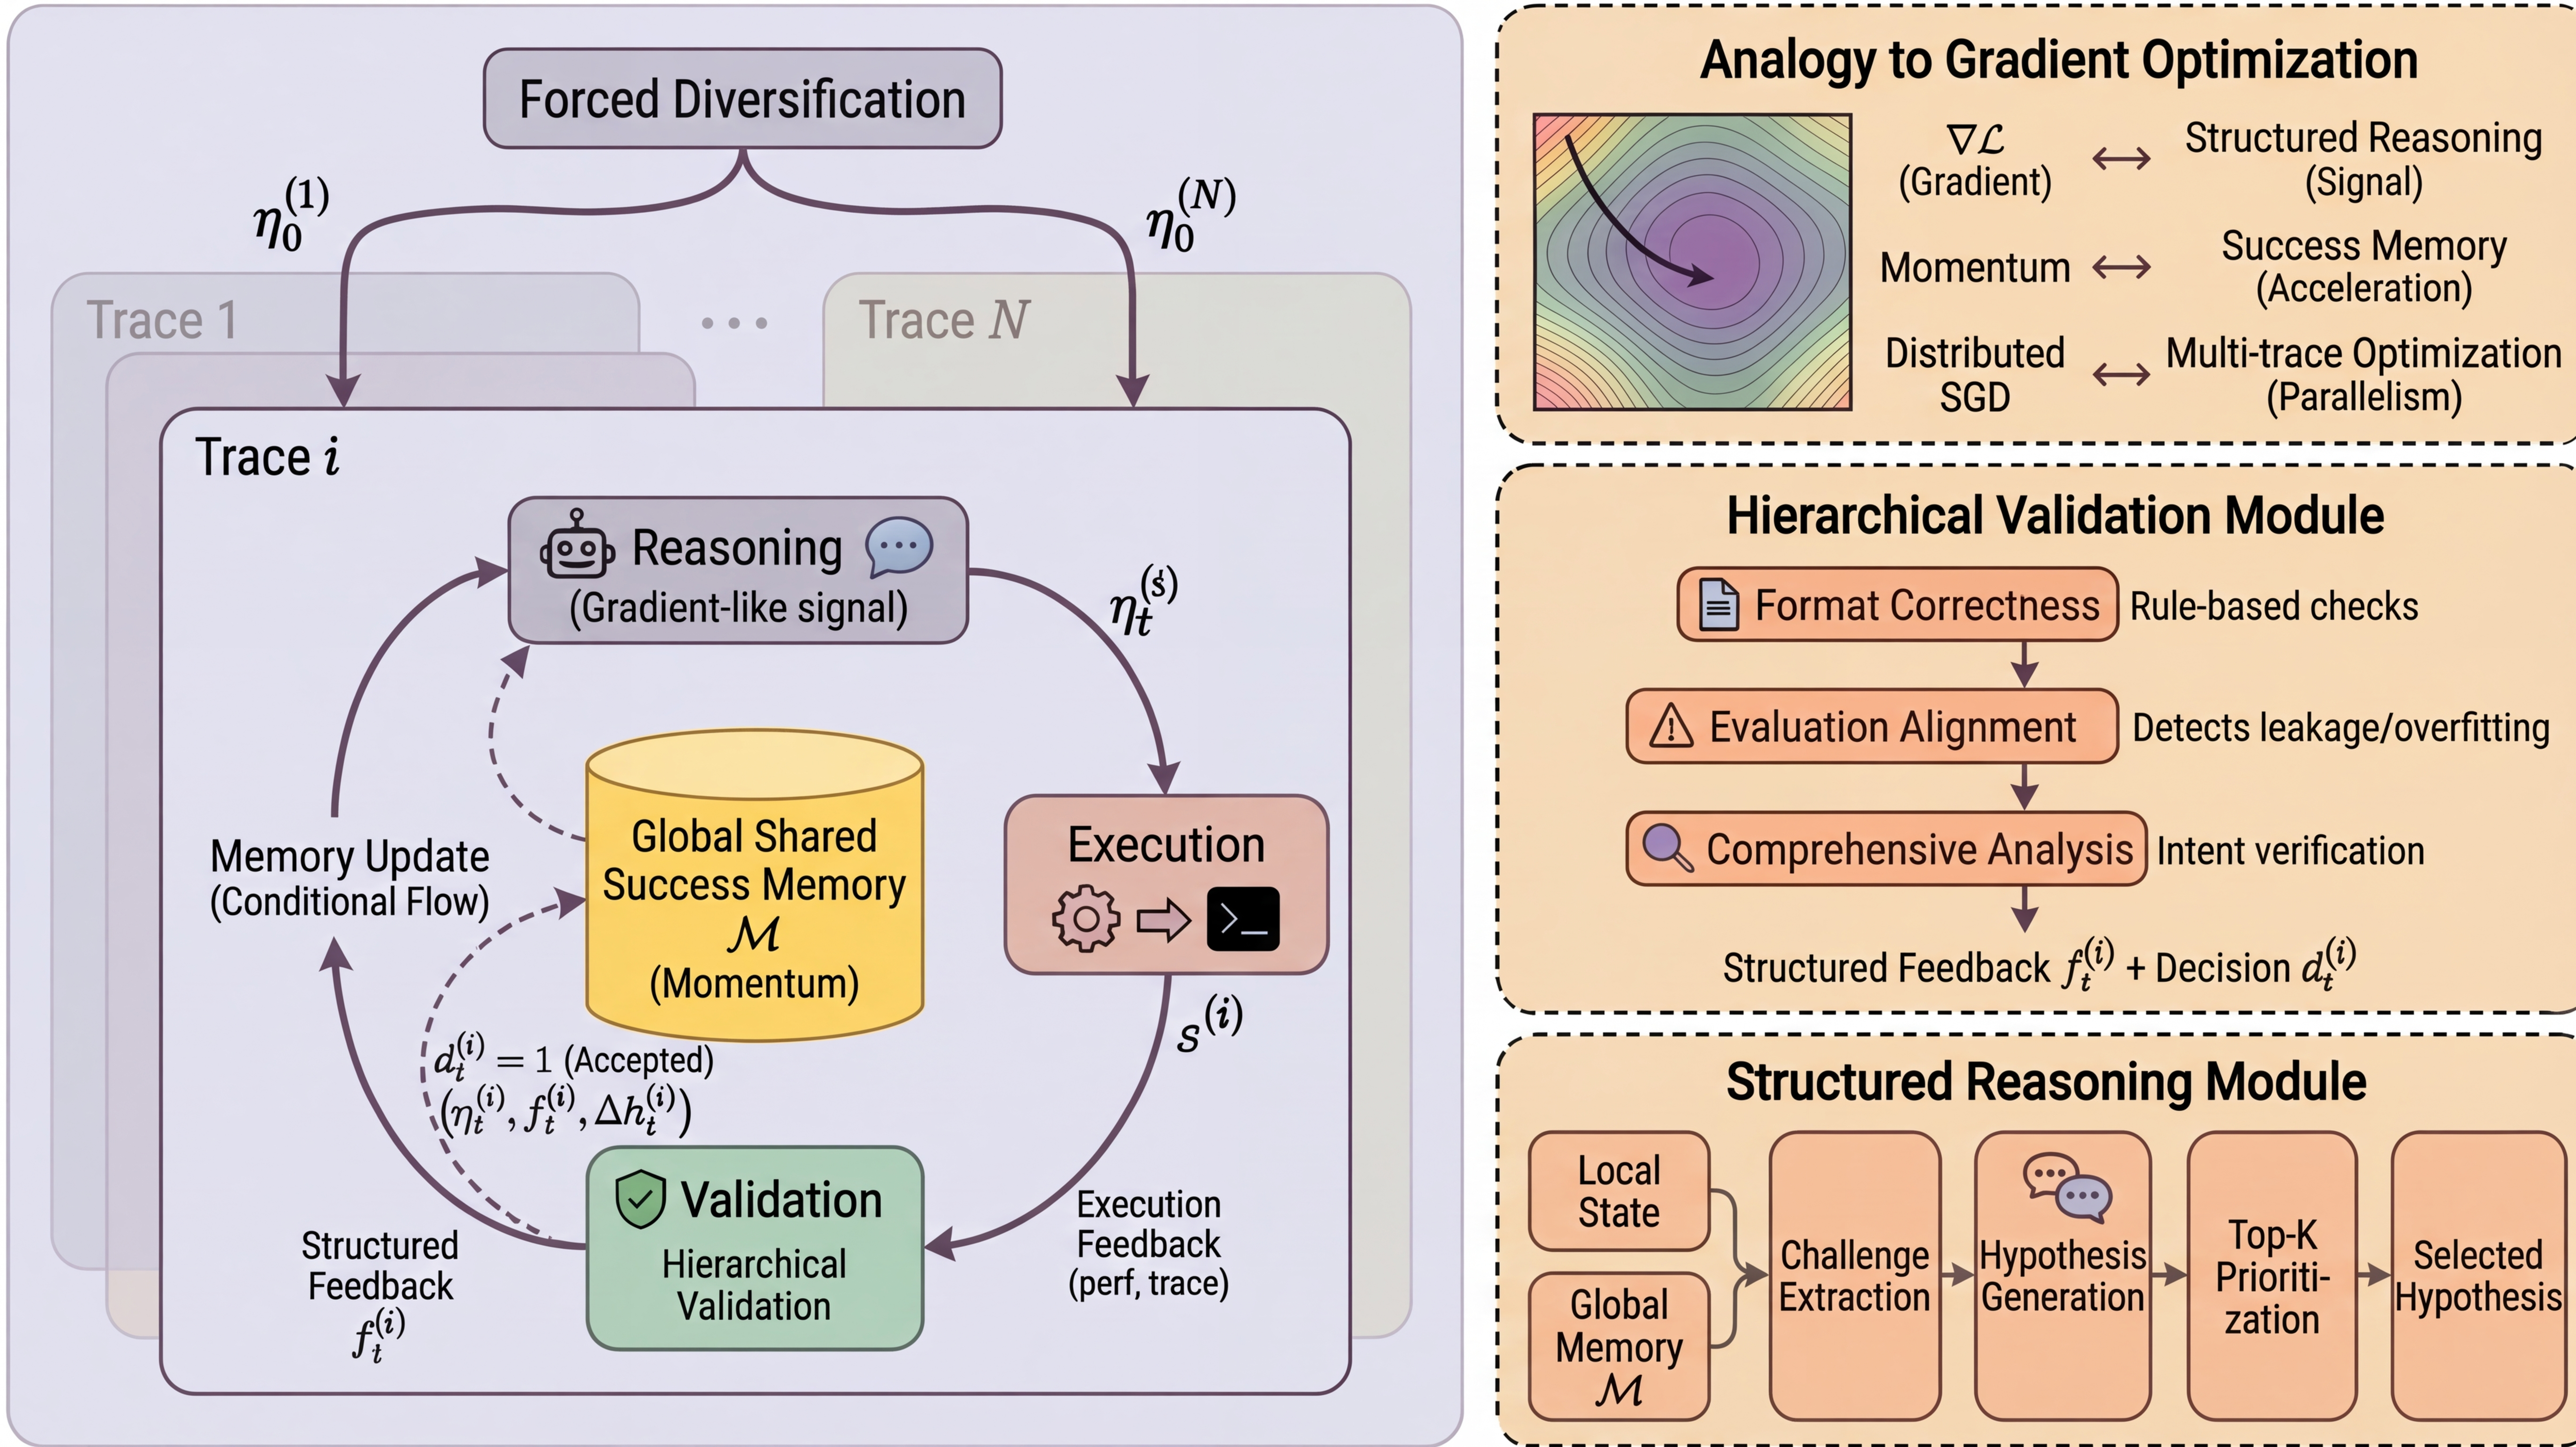
構造化した推論や成功記憶を除くと、同システムのアブレーションではメダル率が下がる。この条件での部品の役割を支える結果である。ただし、診断は探索の反対ではない。Gomeも仮説を順位付けし、木探索のエージェントも実行結果を推論に使える。
探索を広げる価値を判断する
共通の実行基盤は、戦略と実装品質の違いを分ける助けになる。図 7 では、異なる戦略が同じ編集と実行の反復へ接続される。FML-benchは編集器、実行環境、指標表示、検証とテストの分離を共通化する。それでも戦略ごとに指示、記憶、操作は異なり、木の形だけの比較ではない (Zou ほか 2026年)。
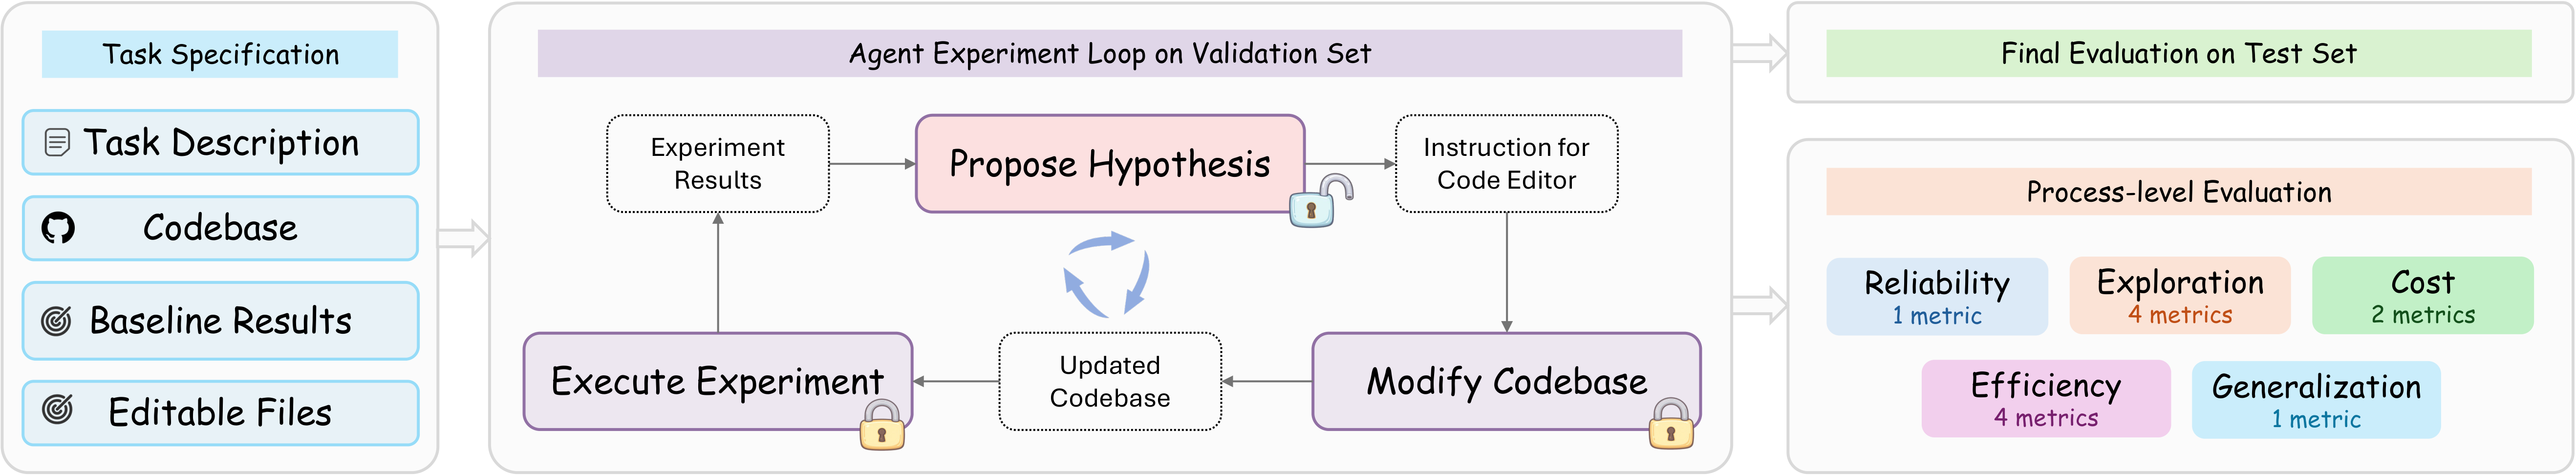
結果は、元のベースラインからのテスト性能の改善を、各指標の最良・最悪の基準値の差で割って比較する。負の改善は0にし、自然な最悪値がない3指標ではベースラインを最悪側の基準とする。この正規化改善値は、正解率や相対的な改善率そのものではない。
18課題をGPT-5.4で解き、各エージェント・課題の組合せで検証実行100回の試行を独立に3回行ったところ、貪欲なAutoresearchと木探索のTAS v2の平均改善値は0.192と0.193で、ほぼ同じであった。得意な課題は異なる。貪欲に始め、停滞時に分岐するAdaptiveSearchは0.208に達した。ただし、この版は探索の形に基づく提案誘導も加え、その一部に本実験から得た課題別の基準値を使うため、改善を切替規則だけの効果とはいえない。観測した進捗に応じて探索を調整する動機にはなるが、未知の課題に使う判断基準は別に確かめる必要がある。また、検証回数が同じでもトークン費用や実行時間はそろわない。
探索を広げるには、内容の異なる案も必要である。図 8 の散布図では、エージェント構成ごとに、モデル構造の多様性が高いほどメダル率も高い傾向がある。Ideation Diversityの研究は、提案したモデル構造の分布のエントロピーで多様性を測った。一種類に偏らず、複数の構造を満遍なく提案するほど高くなる指標である。AIRAに似た案を出すよう指示すると、メダル率は貪欲探索で6.9ポイント、MCTSで8.4ポイント下がった。実行時間内に動かせない高価なモデルを繰り返し試すことが、低下のかなりの部分を説明した (Audran-Reiss ほか 2025年)。
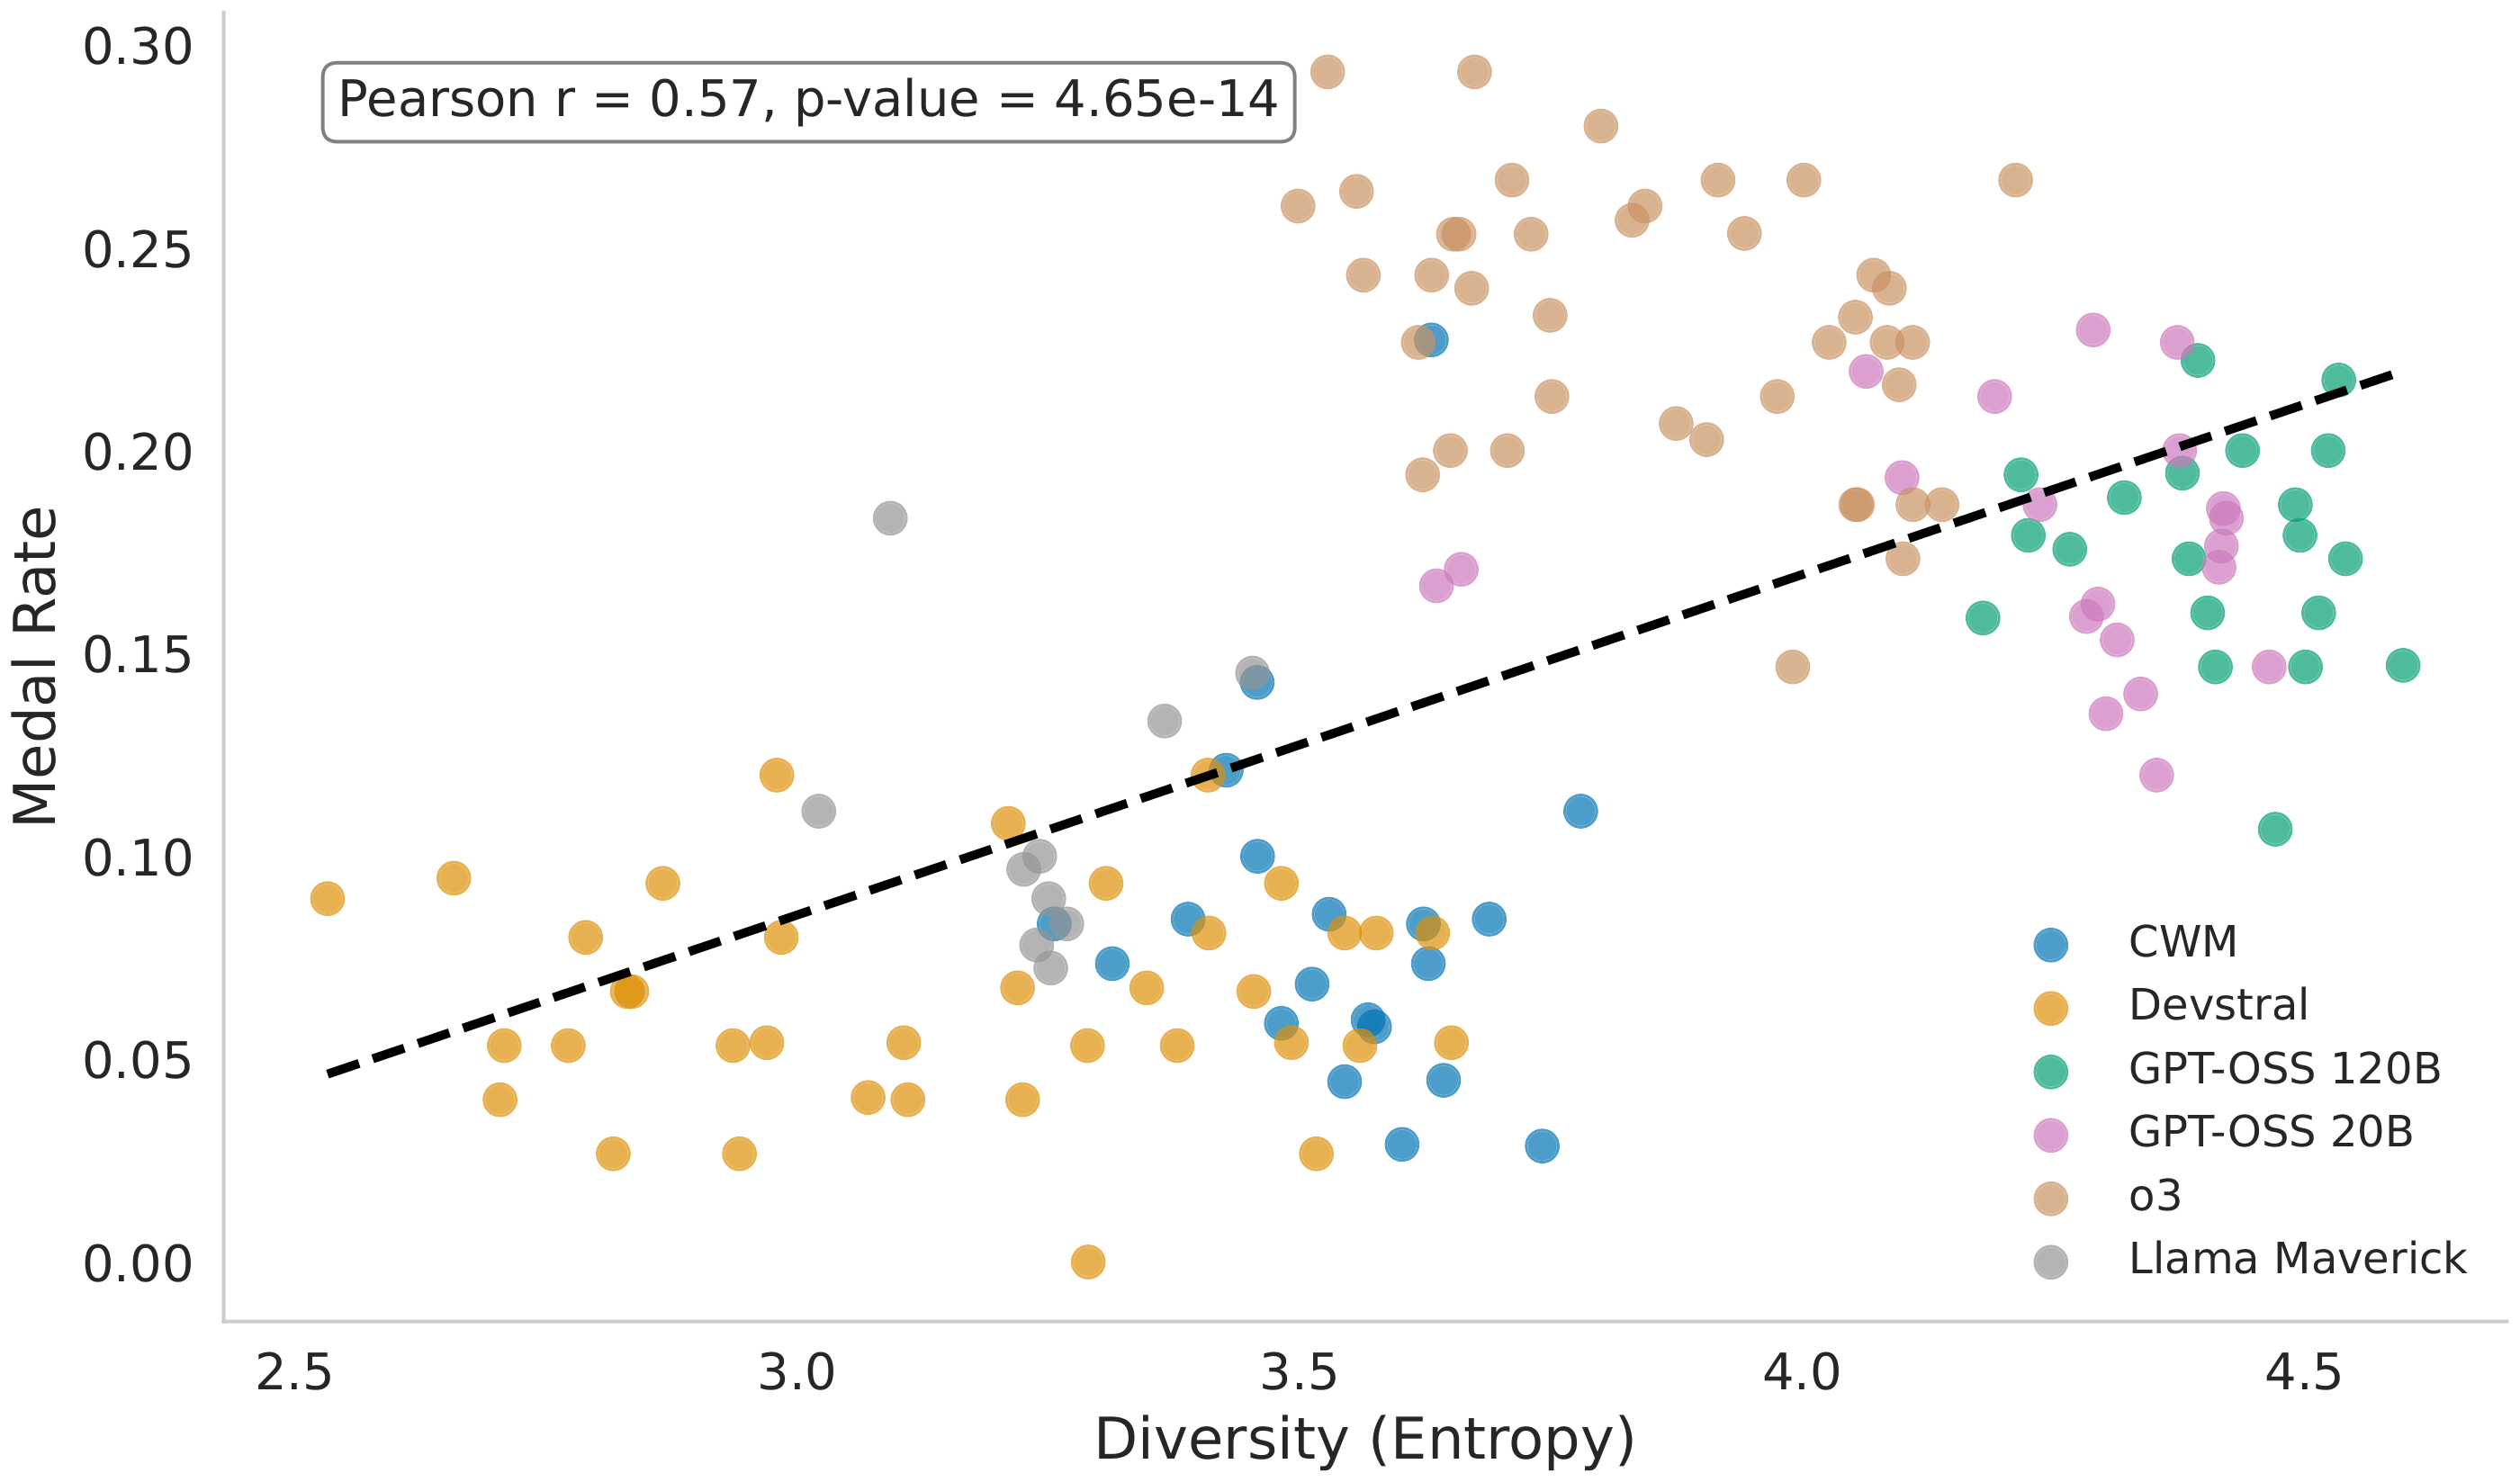
多様性には、実装失敗への備えとしての価値がある。ただし、それ自体が科学的新規性ではない。実験結果の理解では、有用な変更と、過去の案と違うだけの提案を分ける。
有望な提案に実行を配分する
すべての提案をすぐに学習させる必要はない。AIBuildAI-2.5は、実装済みで本学習を待つ候補プログラムと、性能を実測済みの候補を分けて保持する。Judgeが期待改善、過去の結果とのつながり、実現可能性を評価し、Selectorが実行順序を選ぶ。図 9 では、この二つの役割が学習実行の前に置かれ、破線の提案節点と塗りつぶした実行済み節点が区別されている。さらに実行のスケジューリングとモデルの役割分担で計算資源や推論費用を管理する (Qin ほか 2026年)。
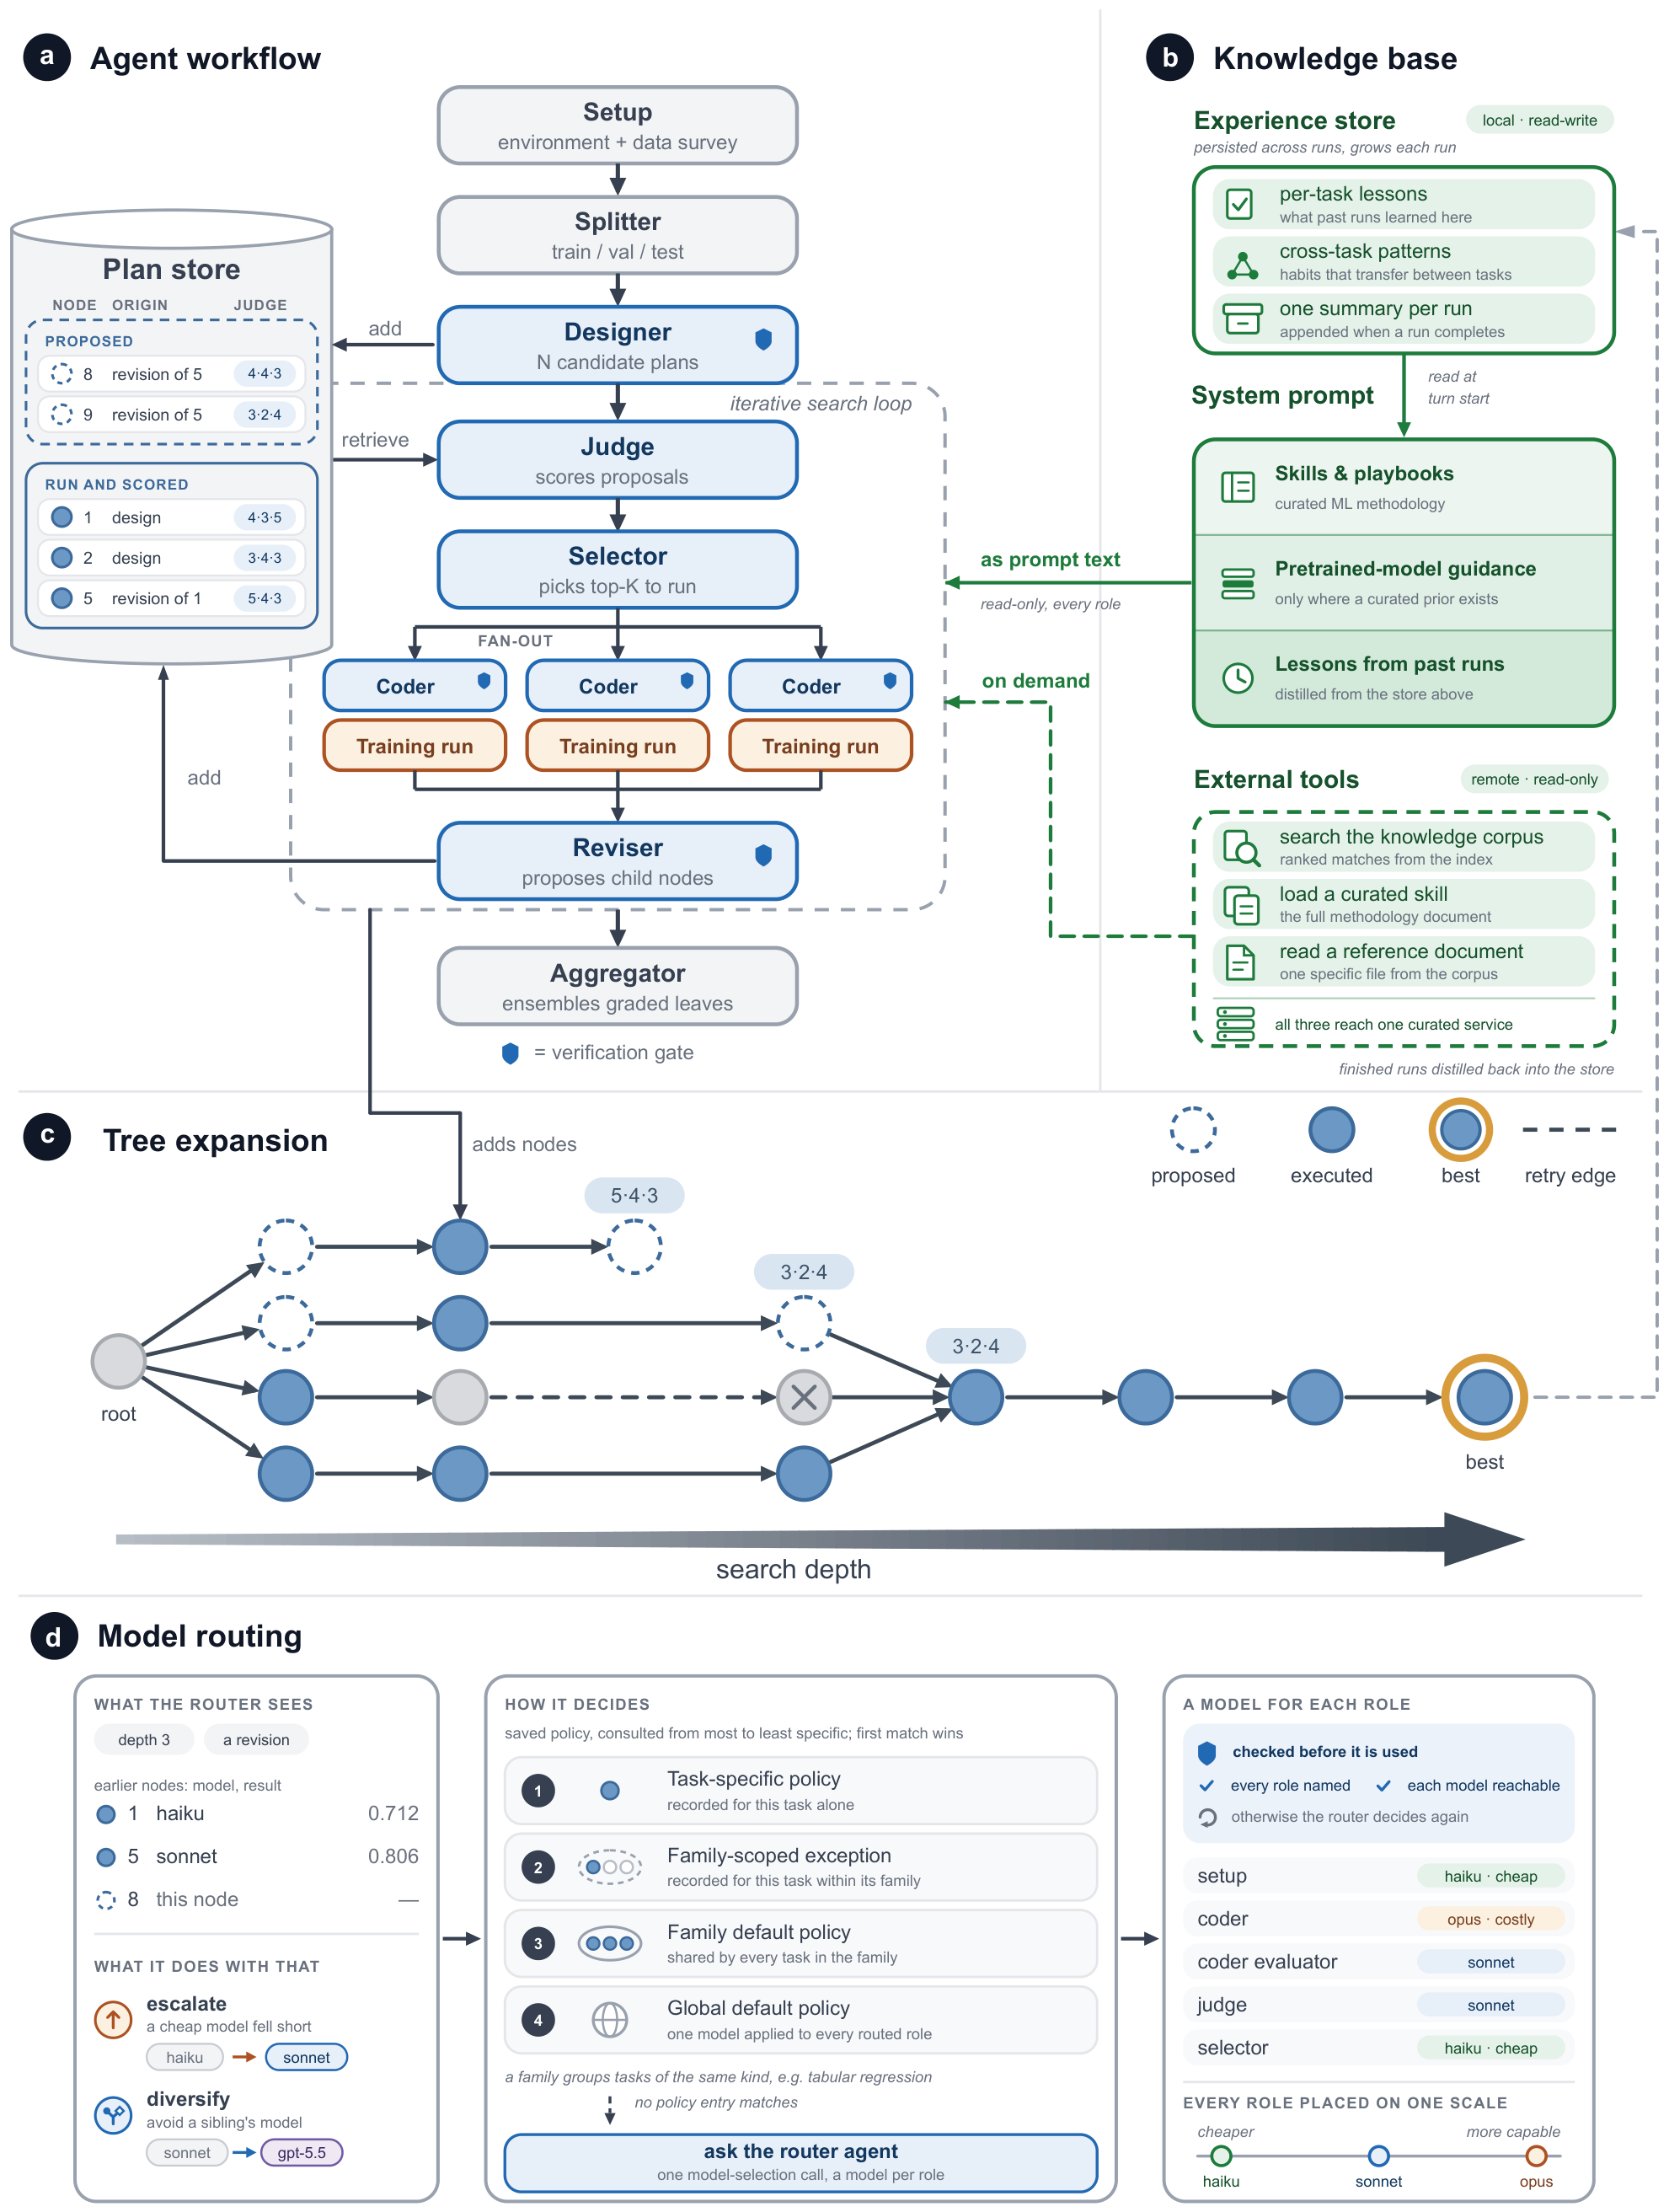
これは、親の選択から実行の配分へ同じ原則を広げた設計である。探索の価値は、限られた資源を、情報が得られ、実行できる変更へ変えることにある。探索の構造、変更操作に渡す情報、操作が確実に生成できるコードを一緒に考える必要がある。実験経験の再利用では、この情報の供給を詳しく扱う。
図の出典・利用条件
- 出典: (Toledo ほか 2025年) Figure 3(原図を引用、PNG変換・余白除去。原論文のライセンス: CC BY-NC-SA 4.0)。
- 出典: (Nam ほか 2025年) Figure 2(CC BY 4.0、原図のPNG変換)。
- 出典: (Nam ほか 2025年) Figure 24(CC BY 4.0、原図のPNG変換)。
- 出典: (Nam ほか 2025年) Figure 3(CC BY 4.0、原図のPNG変換)。
- 出典: (Liu ほか 2025年) Figure 5(原図を引用、PNG変換・余白除去)。
- 出典: (Zhang ほか 2026年) Figure 2(原図を引用、PNG変換・余白除去。原論文のライセンス: CC BY-NC-SA 4.0)。
- 出典: (Zou ほか 2026年) Figure 2(公式リポジトリと同一の原図PDFをPNG変換・余白除去。図の配布ライセンス: Apache 2.0)。
- 出典: (Audran-Reiss ほか 2025年) Figure 1(原図を引用、PNG変換・余白除去。原論文のライセンス: CC BY-NC-SA 4.0)。
- 出典: (Qin ほか 2026年) Figure 1(原図全体を引用、PNGへの形式変換のみ。原論文のライセンス: CC BY-NC-ND 4.0)。