実験経験の再利用
新しい実験は、以前の仕事から何を引き継ぐべきか。分類器なら、動く前処理コード、符号化法の比較、高価なモデルが繰り返し時間切れになった記録などが考えられる。それぞれが支える判断は異なる。有用な再利用には、何が適用でき、何を確かめ直す必要があるかを、受け手が判断できる情報が必要である。
本章では、関連する経験を得る、次の行動に使える形へ変える、受け手の条件で確かめる、という三段階を追う。会話や報告書を渡すことは、この三段階をつなぐ一つの方法にすぎない。
関連する過去の仕事を見つける
経験の供給源には、現在の探索の外側と内側がある。CoMindは両方を使う。図 1 では、共有するコード、データセット、議論が調整役につながり、実装と評価の反復からも結果が調整役へ戻る。公開されたKaggleのノートブックや議論を分析して実行可能な案を抽出し、コード担当へ計画を送り、実装と評価報告を内部のコミュニティへ戻す (S. Li ほか 2026年)。
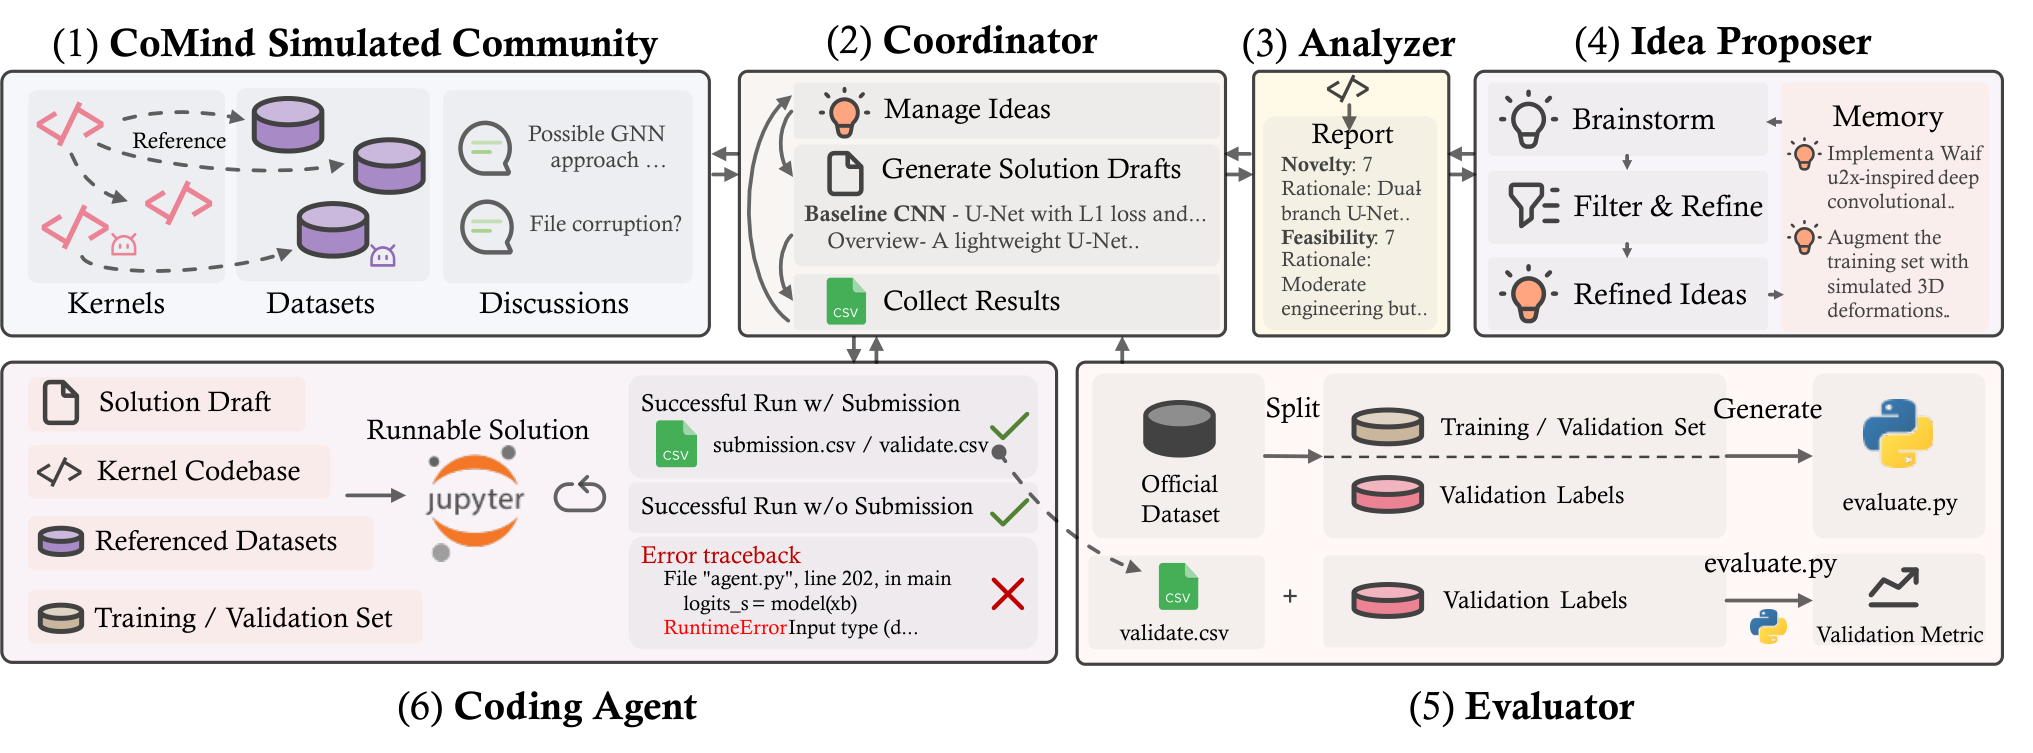
MLE-bench Liteの20コンペティションを用いた資源制限下の比較では、全手法がo4-mini、4 vCPU、5時間の予算を使い、平均win rateはCoMindが0.668、検索と要約を加えたAIDEが0.510であった。win rateは人間の参加者のうち何割を上回ったかを表す。公開資料を除くとCoMind自身の性能も下がった。外部の経験を分析と実装につなぐ価値を示すが、AIDEとの差には報告共有以外の手順変更も含まれる。また、公開資料には人間がすでに行った仕事が含まれる。
AgentRxivは別の接続方法である。図 2 のラボは共有アーカイブを介してつながり、報告を投稿し、過去の報告を検索して次の実験へ使う (Schmidgall と Moor 2025年)。
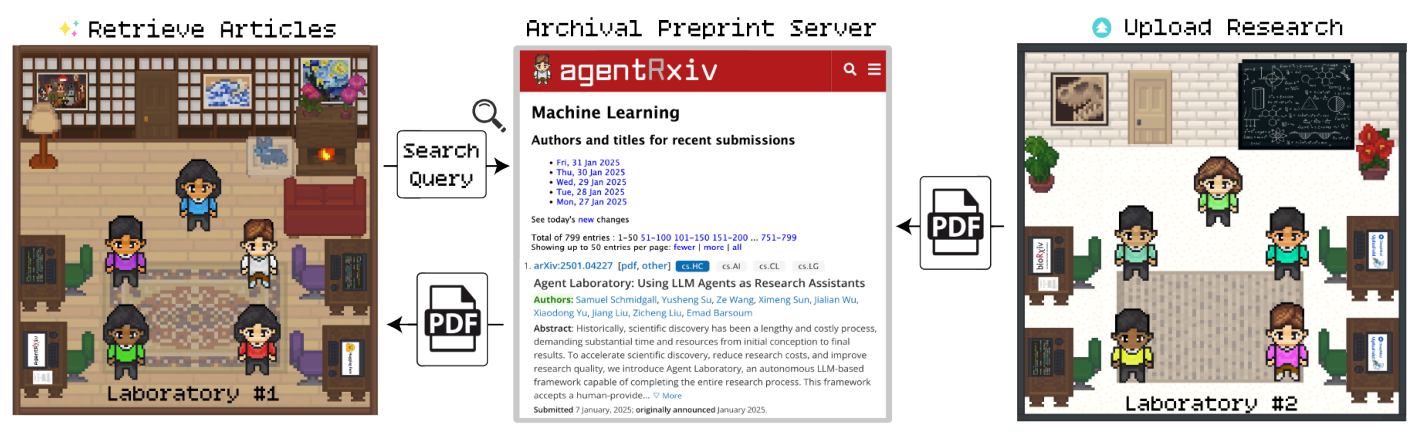
論文の推論課題では、共有報告が反復的な改善を支えた。並列ラボは経過時間を短くした一方、重複作業と資源消費も増やした。著者らは結果の捏造やコード修正の不備に遭遇し、報告された正解率のコードと出力を人手で確認した。検索可能なアーカイブは経験を利用可能にするが、すべての主張の信頼性を保証するものではない。
次の変更に使える形へ変える
長いログは調査に役立つが、毎回の提案にすべて渡すには扱いにくい。短い教訓なら、変更、観察した結果、重要な条件を取り出せる。
MARSは、現在のリポジトリと最高の既知解法を比較し、コード差分と実行結果から改良の教訓を作る。デバッグの教訓には、失敗したコード、エラー、有効だった修正を記録する。図 3 の共有教訓集は、こうして作った関連する記録を、同じ課題内の別の枝の変更にも返す (Chen ほか 2026年)。
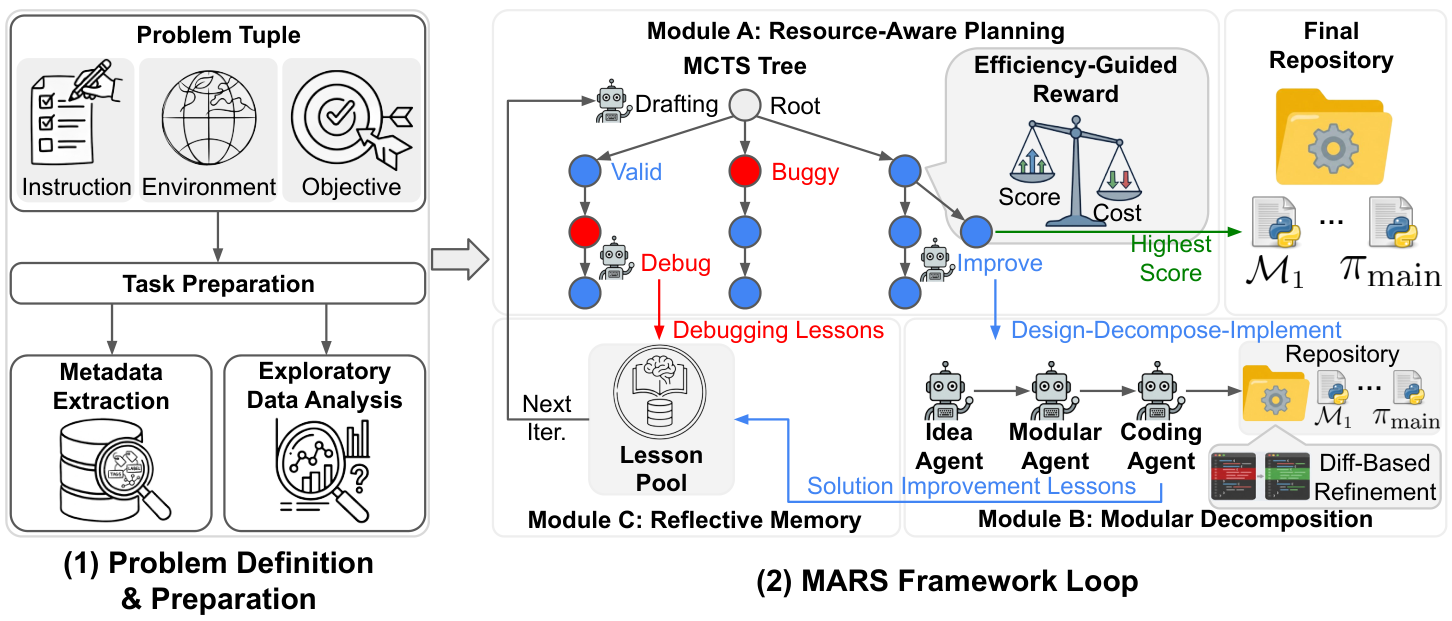
使われた改良の教訓の63.0±1.8%は、別の枝から来たと報告されている。これは参照された教訓の供給元の割合であり、新しい課題への転用成功率ではない。記憶や比較による蒸留を除くアブレーションでは性能が下がる。差分は説明を具体化するが、複数変更の同時実施や学習の乱数があれば原因はなお曖昧である。教訓は次の行動に使える証拠と仮説であり、自動的に統制された因果的知見になるわけではない。
短い教訓に加え、元の候補への参照を残すこともできる。MLEvolveは、親コードを記録する生成の系譜と、変更時に参照した他の試行を記録する参照関係を分ける (Du ほか 2026年)。
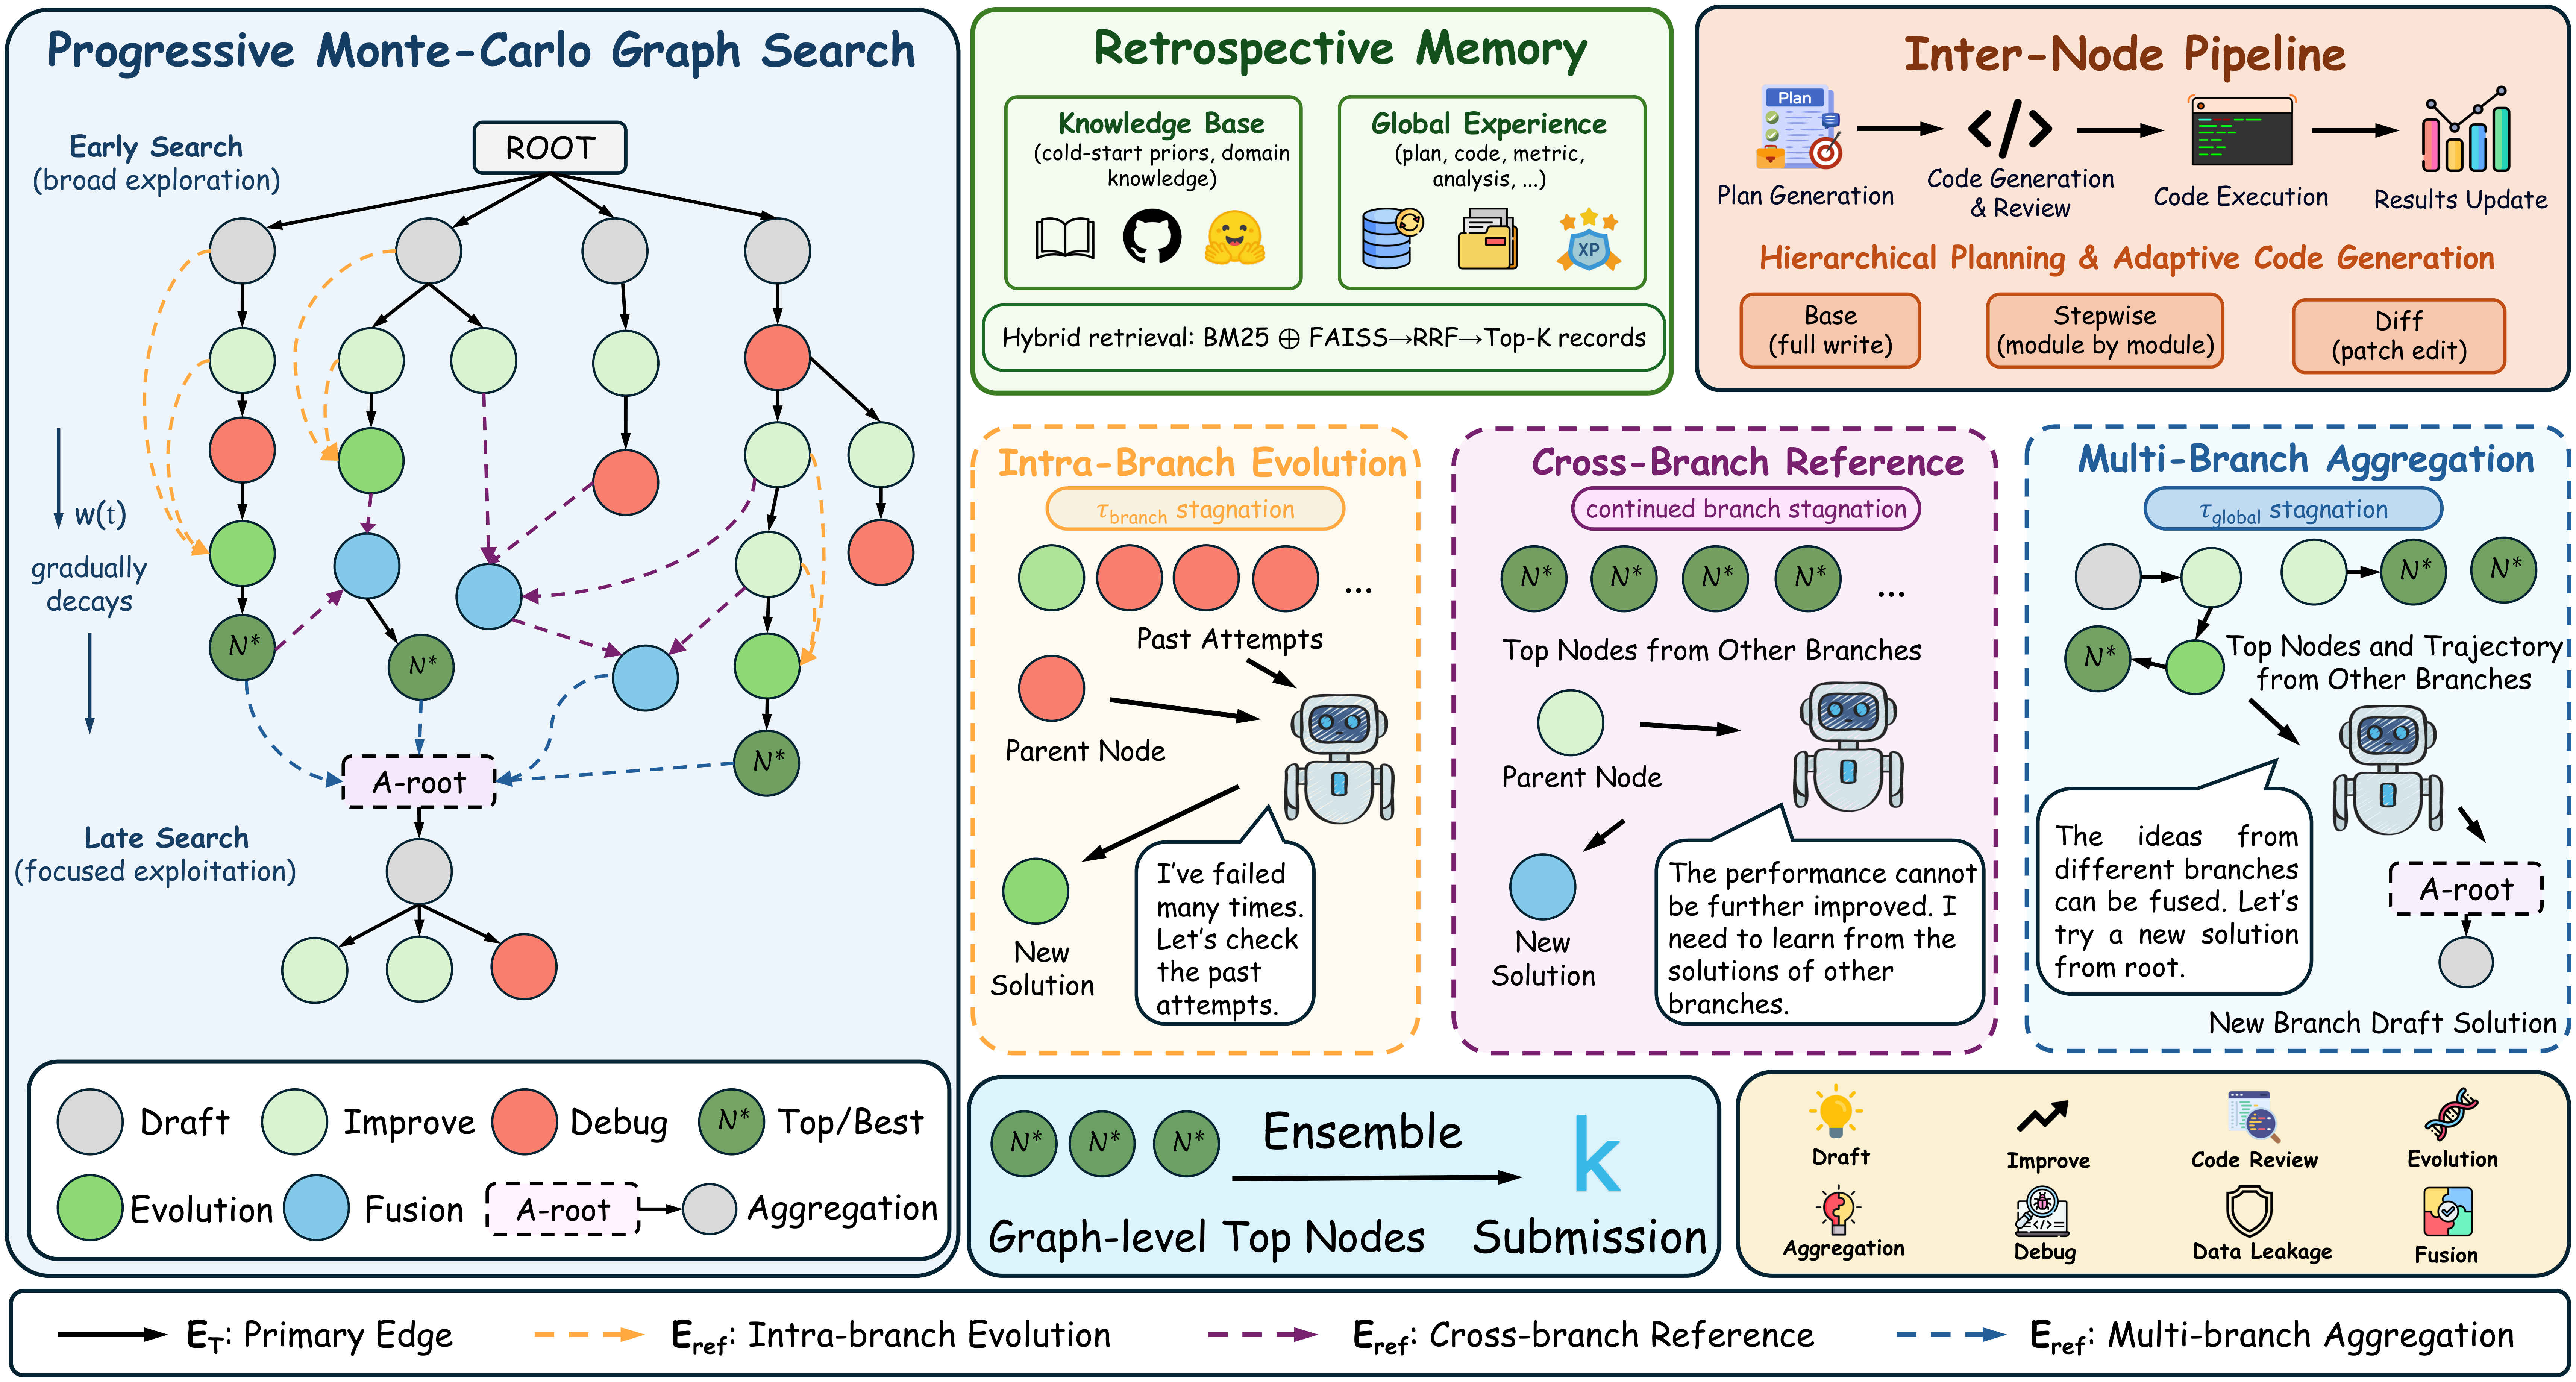
図 4 の二種類の関係は、次のように読み分けられる。Aを変更してBを作る際にCの観察を使っても、Bの親はAであり、Cは参照先となる。探索の統計量は系譜へ伝わり、参照リンクには伝わらない。9課題のアブレーションでは、同じ枝を振り返る操作を除くとメダル率が66.67%から33.33%へ下がり、枝をまたぐ操作を除くと55.56%へ下がった。履歴を使う操作ごと除く比較なので、参照を読むこと単独ではなく、このシステムでの操作の役割を示す。局所的な経験と別の枝からの再利用の両方が重要である。
MLEvolveは参照関係だけでなく、初期案に使う分野知識ベースと、探索中の計画、結果、分析、フィードバックの記録も持つ。計画時には成功・失敗の経験を、デバッグ時には似た解決済みエラーを取り出す。候補そのものへの参照と、次の判断に使う情報の検索を組み合わせている。
使う先で変更を確かめる
成功した設計を渡すことには、それが受け手でも役立つという仮定がある。Population Evolutionは、この仮定を測定可能にする。局所探索は、実行可能な変更、仕組みの説明、来歴、スコアを公開する。他の探索は、その変更を自分の基準実装へ適用し、自分のデータ、初期化、学習量で学習し直す (Peng ほか 2026年)。
引き継ぐのは設計であり、学習済み重みのコピーではない。受け手の結果は共有台帳へ入り、次の提案に使われるが、各探索は自分の候補集団を保つ。受け手での基準を満たす候補は、より大きい規模の評価へ進められる。
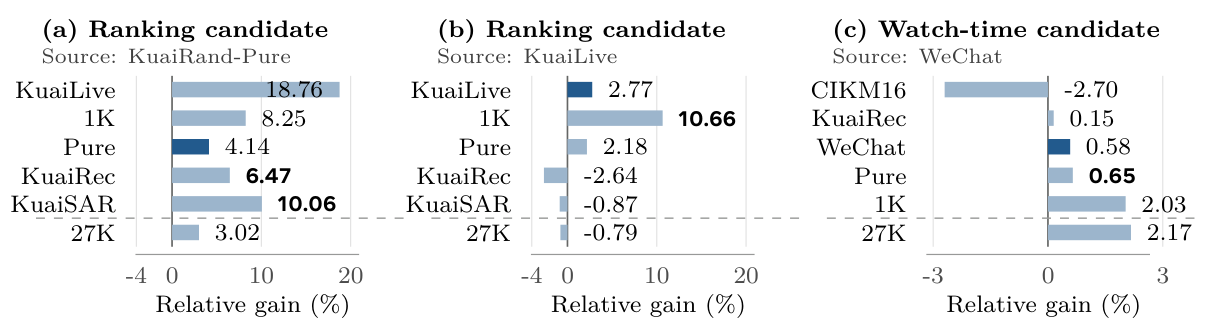
図 5 の(a)は全受け手で改善し、破線より下の大規模評価でも利得が残る。(b)は小規模の複数条件でよくても大規模では悪化し、(c)は小規模の受け手の間でも改善と悪化が混在する。受け手での測定は、送り手の成功だけでは分からない情報を探索へ返す。
論文には、局所探索の反復数をそろえた比較と、総GPU計算量をそろえた別の比較がある。両者は異なる効率の問いに答える。階層的な探索では、最終規模の成績は結果報告に使うが、その後の提案には返さない。発見中に使える証拠と、後から行う評価を分けている。
失敗を広すぎる禁止にしない
失敗の記録が次の探索を絞れるのは、どの条件で何が失敗したかを説明できるときである。「このモデルを使うな」よりも、「この学習経路は利用可能なCPU時間を繰り返し超えた」の方が有用である。
Negative Knowledgeは、失敗の種類、適用範囲、危険な操作、代替案を短い記録にする。図 6 の採用・不採用の段階では、後のエージェントが各記録を適用できるか判断し、理由とともに明示する (Wang 2026年)。
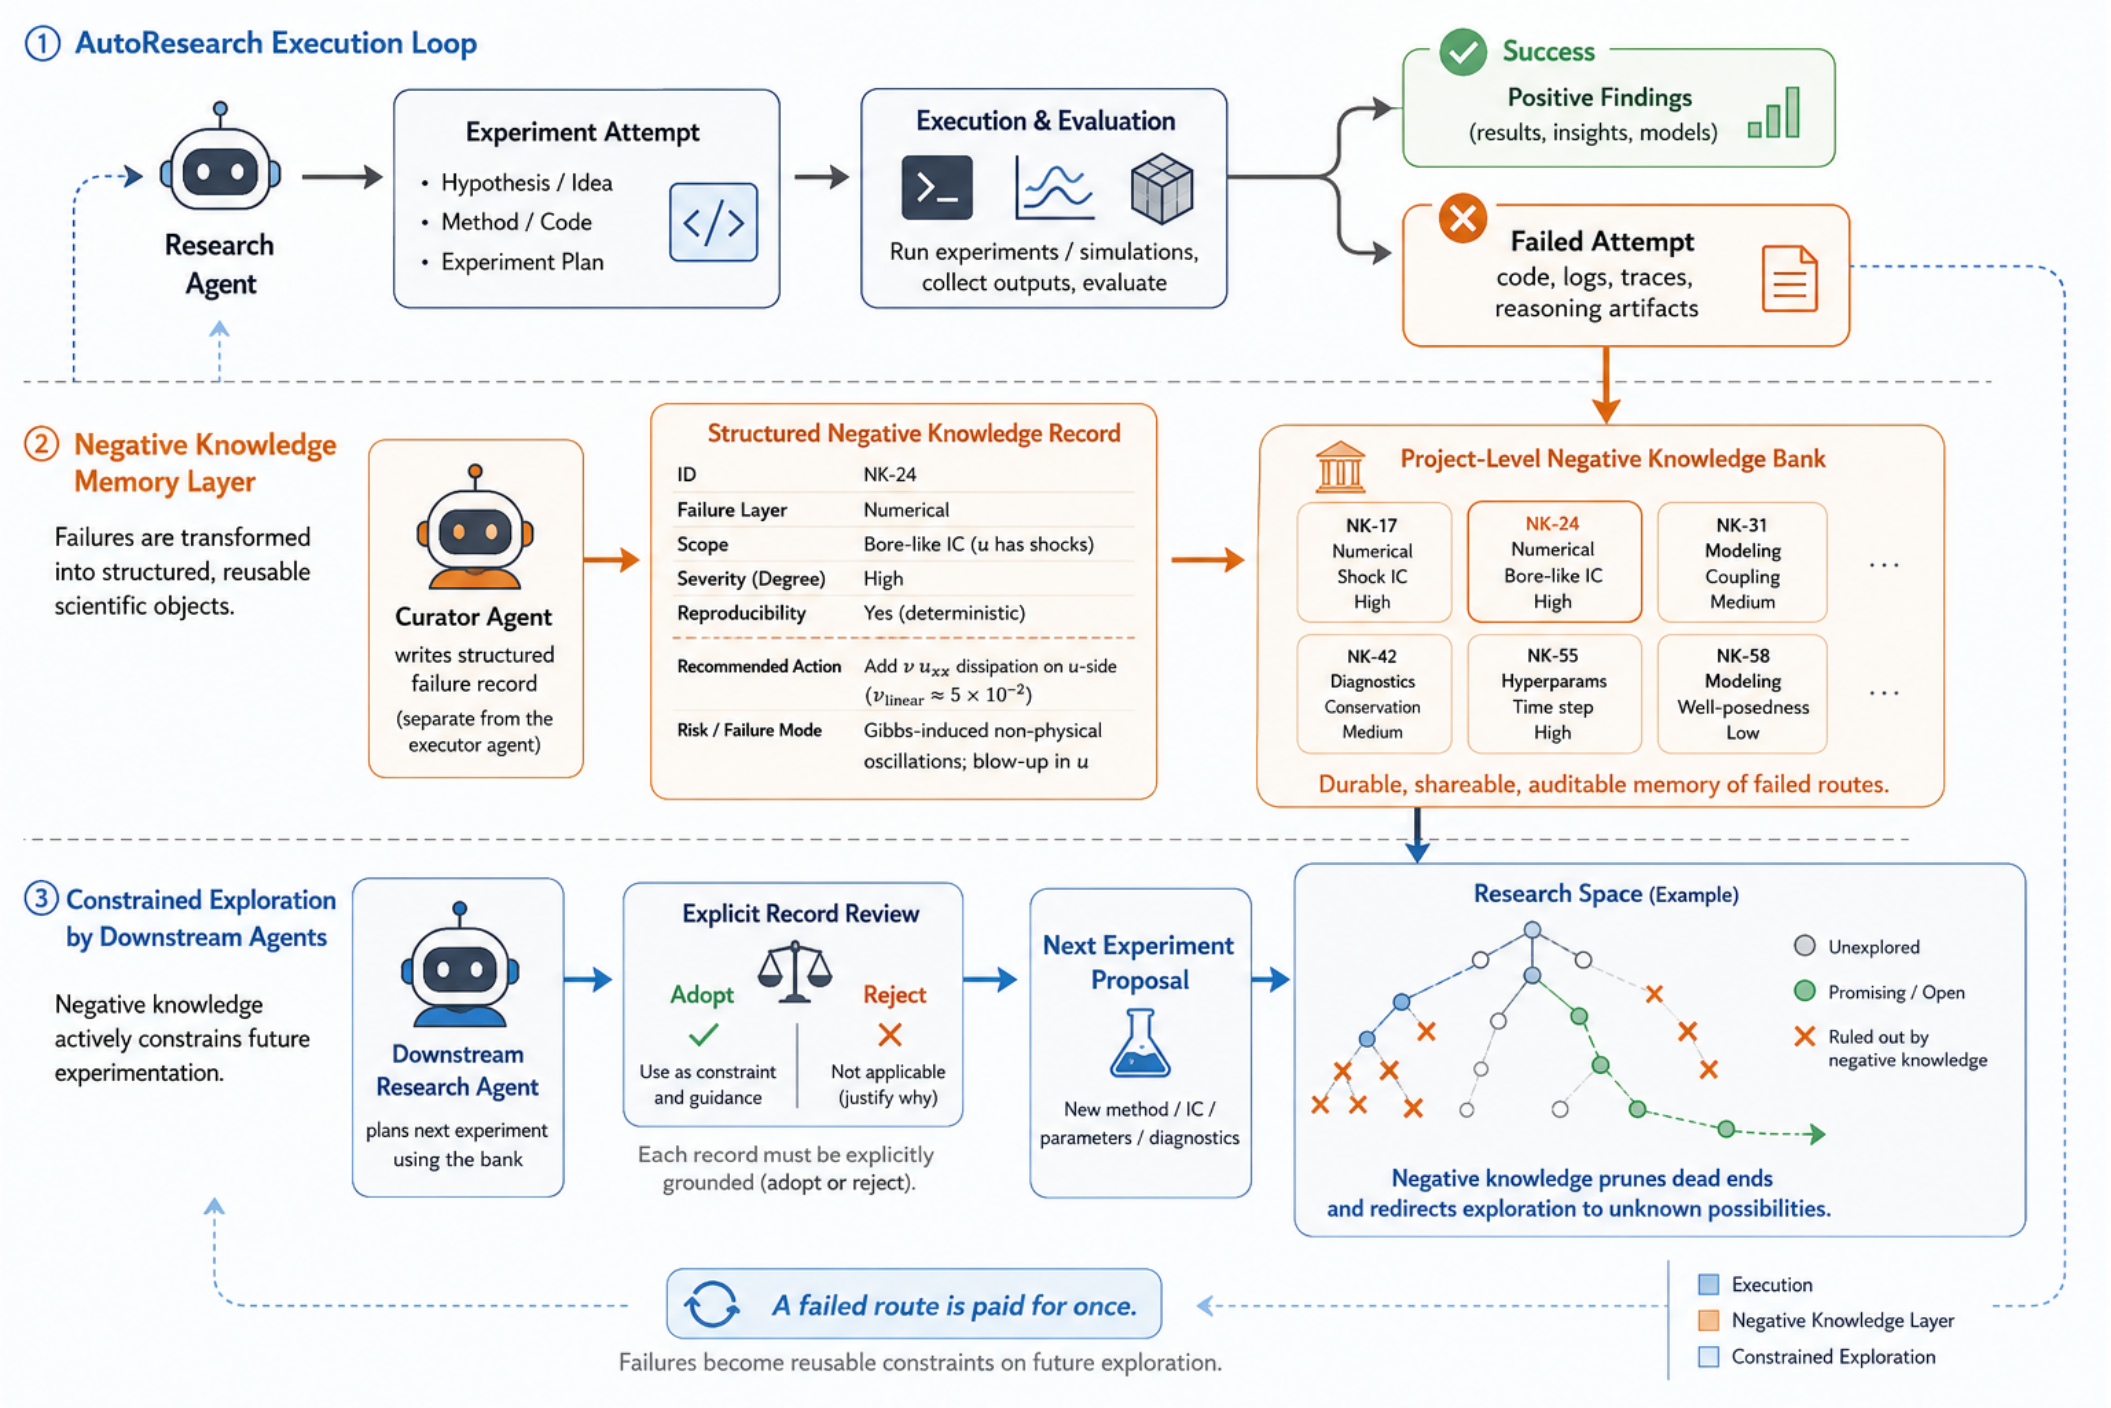
脳波信号の例では、学習を繰り返してCPU予算を使い切った。同じ失敗の型を渡すことで、学習設定の微調整ではなく、閉形式の最小二乗法へ切り替えた。逆に、近い方程式で有効だった数値解法を渡したところ、符号規約の違いにより不安定になった例もある。失敗の知識は、裏付けられた失敗経路を除くものであり、未検証の代替案まで否定するものではない。
会話をすべて残さずに仕事を続ける
もっとも直接的な再利用は、既存の作業環境から続きを行うことである。Humanize MLE Agents(HMA)は、ネイティブなエージェントを交代させ、会話をリセットする。図 7 のOption AとBが共有する課題状態には、作業環境と評価済み候補が残り、コードやキャッシュも交代を越えて引き継がれる (C. Li ほか 2026年)。
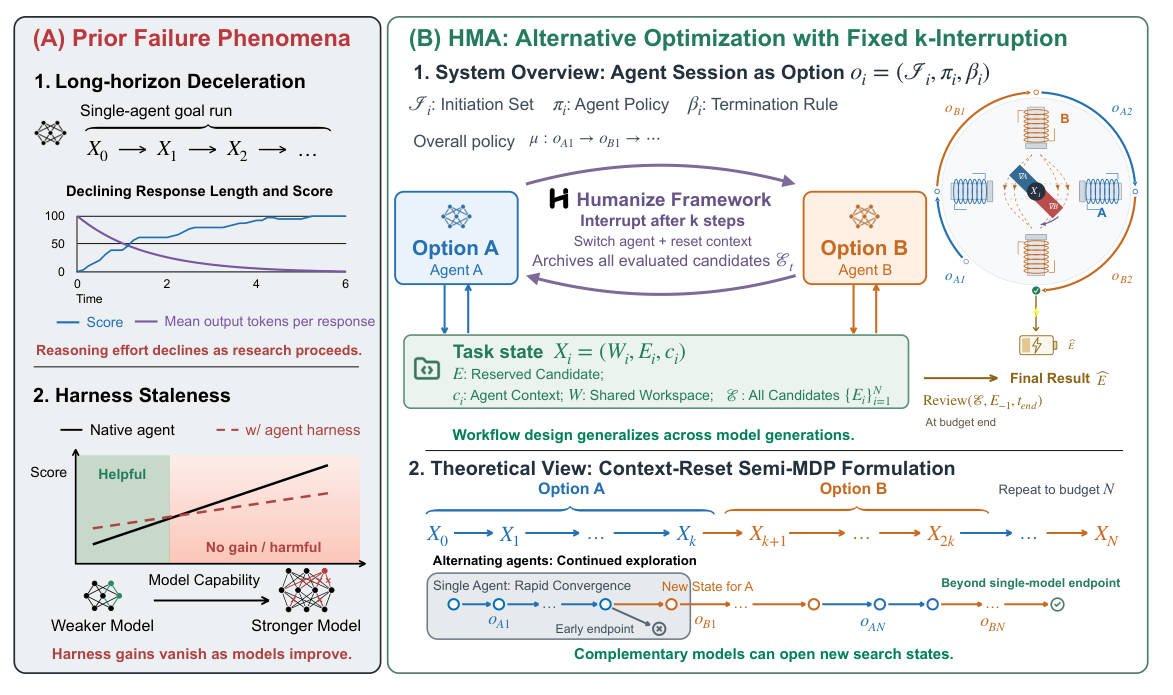
ここでは、次に誰が動くか、どの会話を受け取るか、どの成果物が残るかを分けられる。三つを同時に変えると、引継ぎの効果を解釈しにくい。
The Handoff Taxは、ソフトウェア修正のSWE-bench Verifiedで会話の渡し方を直接調べる。図 8 の四列すべてで編集済みの作業ツリーを残す。変えるのは会話であり、全履歴、前任者または後任者が作る要約、会話なしを比べる (Ganz ほか 2026年)。
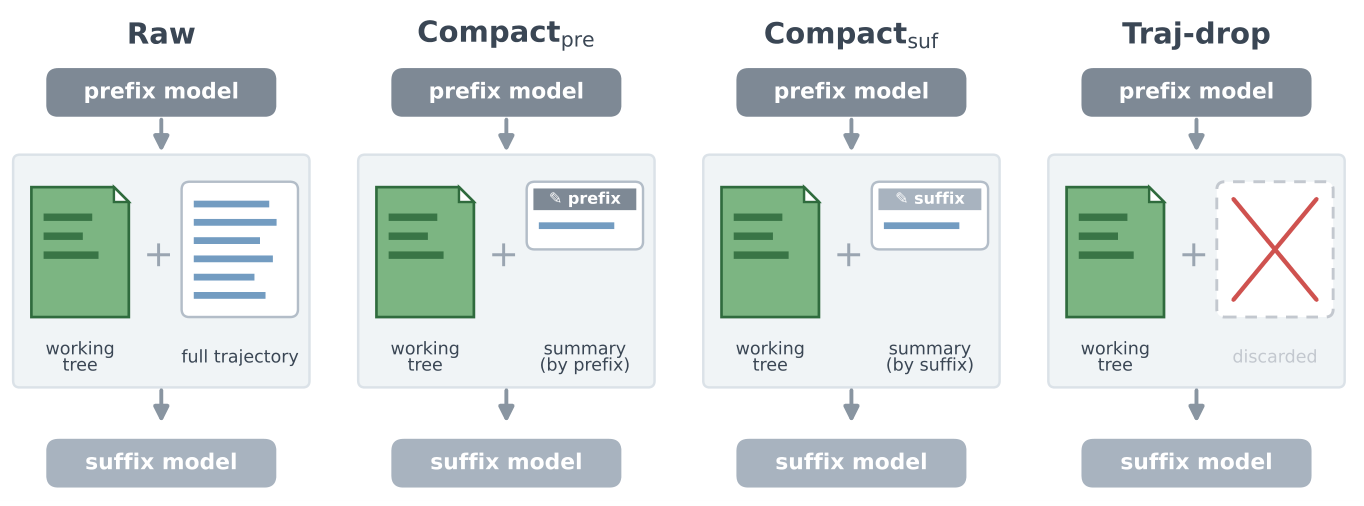
試したモデル対では、弱い前任者の軌跡を捨てる方が強い後任者に有利で、逆向きの引継ぎでは強い前任者の履歴を残す方が有利であった。これはソフトウェア修正での証拠であり、HMAの直接検証ではない。それでも、多くの文脈を渡すことと、多くの使える知識を渡すことの違いを明確にする。
これらの設計をつなぐのは、関連する仕事を取り出し、条件と来歴を保ち、別の場所へ適用する際には新しい証拠を得る、という流れである。実験結果の理解では、その証拠によって次の判断を支える説明をどう改めるかを扱う。
図の出典・利用条件
- 出典: (S. Li ほか 2026年) Figure 2(CC BY 4.0、原図のPNG変換)。
- 出典: (Chen ほか 2026年) Figure 2(CC BY 4.0、PNG変換・余白除去)。
- 出典: (Du ほか 2026年) Figure 2(原図を引用、PNG変換・余白除去)。
- 出典: (Peng ほか 2026年) Figure 2(原図領域を引用、PNG変換)。
- 出典: (Wang 2026年) Figure 1(CC BY 4.0、原図のPNG変換)。
- 出典: (Schmidgall と Moor 2025年) Figure 3(CC BY 4.0、原図領域の切り出し・PNG変換)。
- 出典: (C. Li ほか 2026年) Figure 1(CC BY 4.0、原図領域の切り出し・PNG変換)。
- 出典: (Ganz ほか 2026年) Figure 2(原図領域を引用、PNG変換)。