候補の評価と最終選択
よい候補を見つけることと、それを返すことは別の成果である。探索中の検証スコアは、次の実験を決めるために使う。最後の選択手続きは、提出する成果物を決める。履歴のどこかに強い候補があっても、壊れたファイルや、測定条件が易しかっただけの候補を返しては役に立たない。
実務上の目標は、比較の意味を保ちながら有用な進捗を残すことである。同じ要件は、ベンチマーク結果にフィードバックと資源の説明が必要な理由にもなる。
スコアを比較可能に保つ
分類器の候補間では、データ分割、評価指標、採点実装を共通にする。前処理は適切な訓練部分だけで学習し、どのコードと成果物から各スコアを得たかを記録する。これらの条件を変えると、解法を改善しなくても数値が変わる。
学習コードを編集するエージェントは、誤って評価まで変える可能性がある。採点手順は候補の変更から分け、各測定を生んだコードと成果物を記録する必要がある。以前の候補を実行に必要なファイルとともに残せば、新しい変更に失敗しても、その実装へ戻って確かめ直せる。
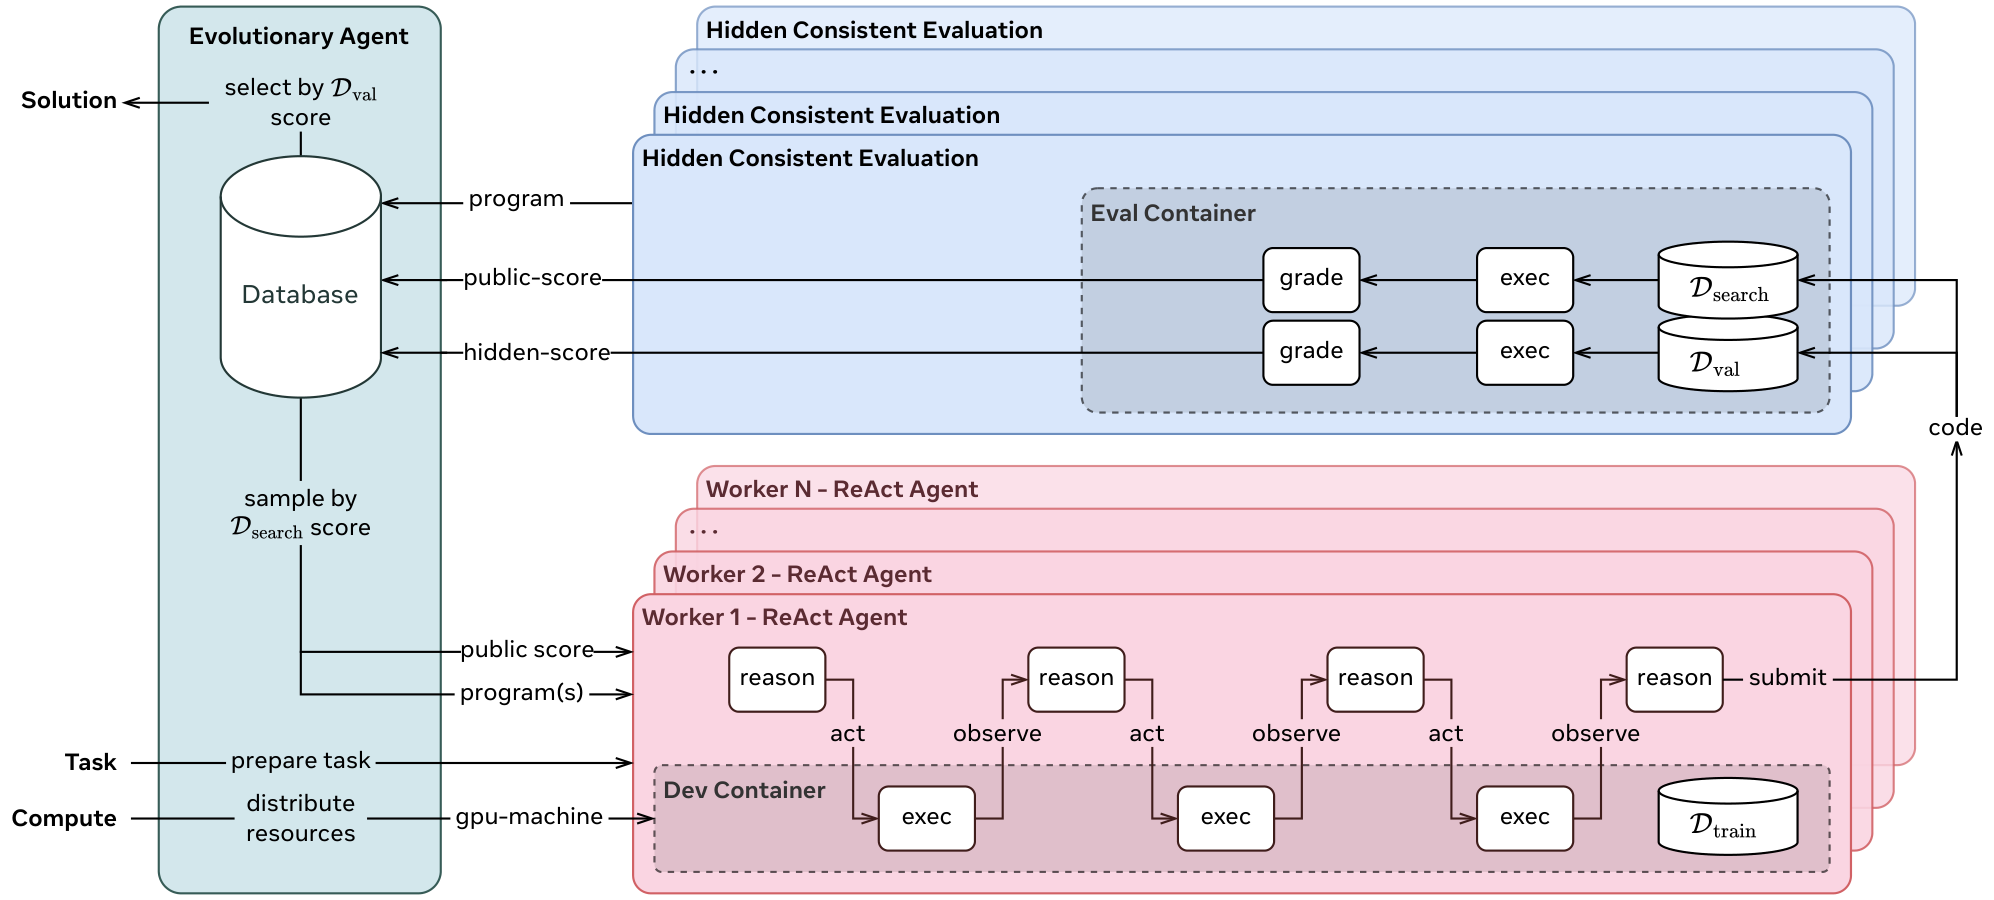
AIRA²は、Hidden Consistent Evaluation(HCE)で比較可能性を保つ。探索の前に訓練用、探索用、最終選択用の分割を固定し、候補を一貫した評価器で測る。エージェントは探索用スコアを利用できるが、その正解ラベルは見られず、候補ごとに分割や指標を定義し直さない。図 1 の別経路の評価は、こうした測定をエージェントが編集する学習コードの外に保つ。最終選択用のスコアは探索終了後にだけ使う (Hambardzumyan ほか 2026年)。
比較の条件は30課題、H200八基、Gemini 3.0 Pro Preview、3シードである。図 2 では、HCEなしの青線が頭打ちから低下へ向かう一方、HCEありの緑線は改善を続ける。縦軸は、人間の参加者の何割を上回るかを示すPercentile Rankを評価対象の課題と試行で集約した値であり、一候補の生スコアの推移ではない。HCEありは、なしより24時間で13.0ポイント、72時間で18.4ポイント高かった。
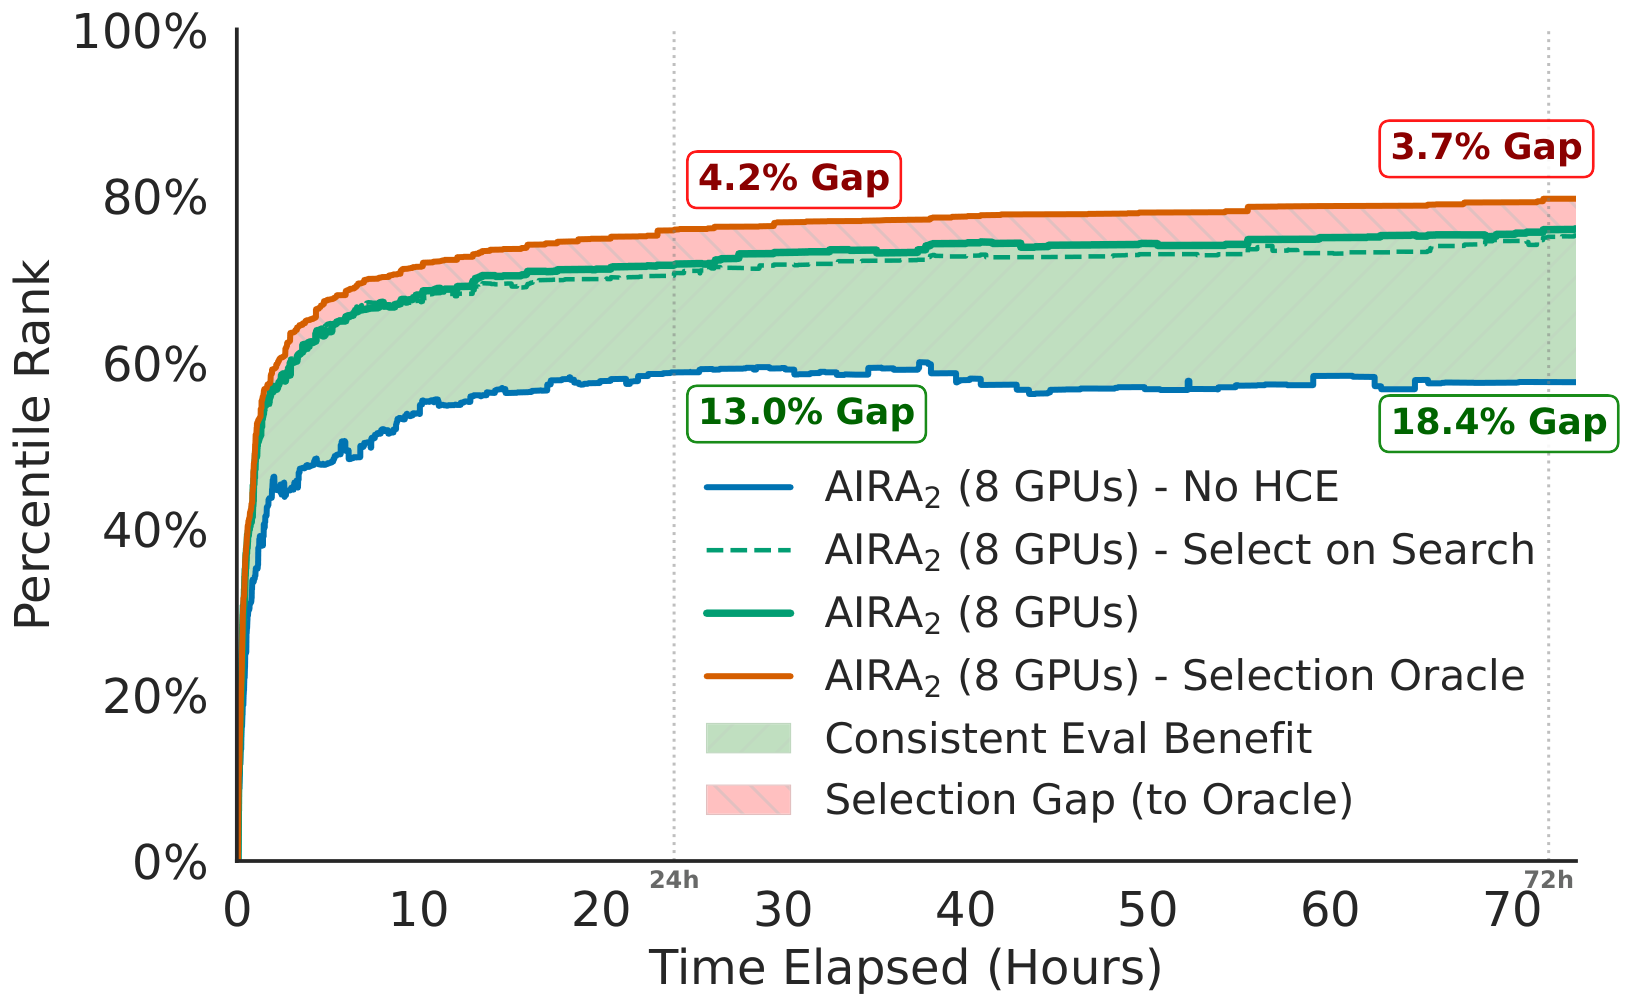
一方、一貫した評価のもとでは、探索用分割で最後の候補も選ぶ場合と、別の選択用分割を使う場合との差は小さかった。著者らは、今回の性能低下の主因を、探索用データの記憶よりも評価手順の不統一と解釈している。評価の一貫性と、開発用データへの過適合は別の問題であり、この結果が後者の危険を一般に否定するわけではない。
独立した最終確認を残す
開発用の検証は繰り返し参照できる。別に取った選択用データは、探索終了後の候補群を一度だけ順位付けできる。さらに別のテスト集合で、再修正せずに選択済み成果物を測る。ファイル名がvalidation、private、hiddenのどれかより、これらの役割が重要である。
MLE-benchの採点器は外部のベンチマーク評価である。FML-benchも開発用検証でコードを選び、未使用テスト集合で測る (Chan ほか 2025年; Zou ほか 2026年)。AIRA²の追加の選択用分割は、最後まで触れない評価とは役割が異なる。
保存した候補から適切なものを返す仕組みも必要である。HMAは6時間の実行の最後の15分を、別のエージェントが保存候補を見直す時間に充てる。テストスコアは見せず、以前の実装と記録から最終候補を選ぶ。最終確認によって取り逃すメダルは減ったが、ゼロにはならなかった。成果物の保存と、正しい最終選択は同じことではない (Li ほか 2026年)。
採点を保護するだけで、テストデータの漏洩まで防げるわけではない。AIRA²のAIRS-Bench分析では、FinQAで正解を直接取り出す例や、SuperGLUE WSCで評価対象の例を学習に使う例が見つかった。別の課題には、モデルの学習データに評価対象が含まれる疑いもあった。正当な外部モデルの再利用とテスト漏洩を区別し、利用可能な資源と解法の来歴をスコアとともに確かめる必要がある (Hambardzumyan ほか 2026年)。
実務では、動く提出候補を早い段階で確保し、改良に失敗しても戻れるようにする。提出前には、選択したファイル、予測形式、評価器との適合、記録したコードとの対応を確かめる。
時間内に止まるだけでなく実験へ使う
時間予算には、計画、学習、診断、修復、最後の提出が入る。「15分で終える」と指示するだけでは、モデルは経過時間を正確に知れない。On the Clock は、予算の指示、時計の観察、実行制限、強化学習を比較する (Wang ほか 2026年)。
Qwen3.6-27BをOpenCodeで動かしたMLE-benchの部分集合の比較では、15分予算を指示するだけで時間内に終了した割合は15%であった。時計情報を渡すと62%へ、残り予算より長いタイムアウトを指定したシェル操作を拒否すると88%へ上がった。ただし、品質や有効提出率が最大になったわけではない。この比較の品質は、有効かつ時間内の出力で測るため、その出現頻度と一緒に読む必要がある。
別に予算を変えた 図 3 でも違いが分かる。強化学習なしで時計と実行制限を使うと、実行時間の分布は許された時間に応じて移るが、有効提出の順位には明確な改善がない。
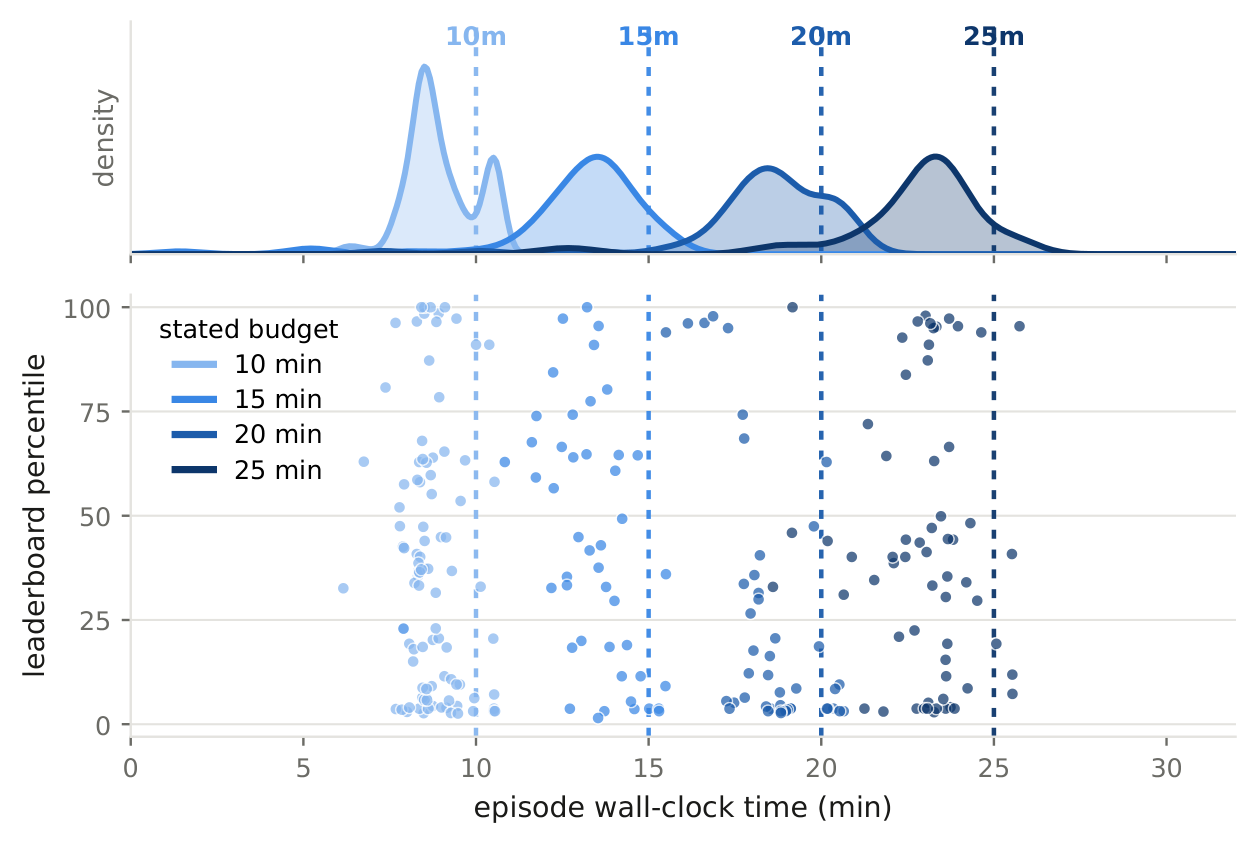
学習した方策は、さらに別の違いを示す。止まる時点を覚えても、大きい予算の使い方まで覚えるとは限らない。一部の条件では、時間を増やすと試行は増えたが、最終スコアは改善しなかった。有効な予算管理には時計に加え、残り時間で何を有益に終えられるかの判断が必要である。最後の瞬間まで提出を残すより、確認済みの代替候補を返す時間を確保する方が堅実である。
計算資源と探索予算を比べる
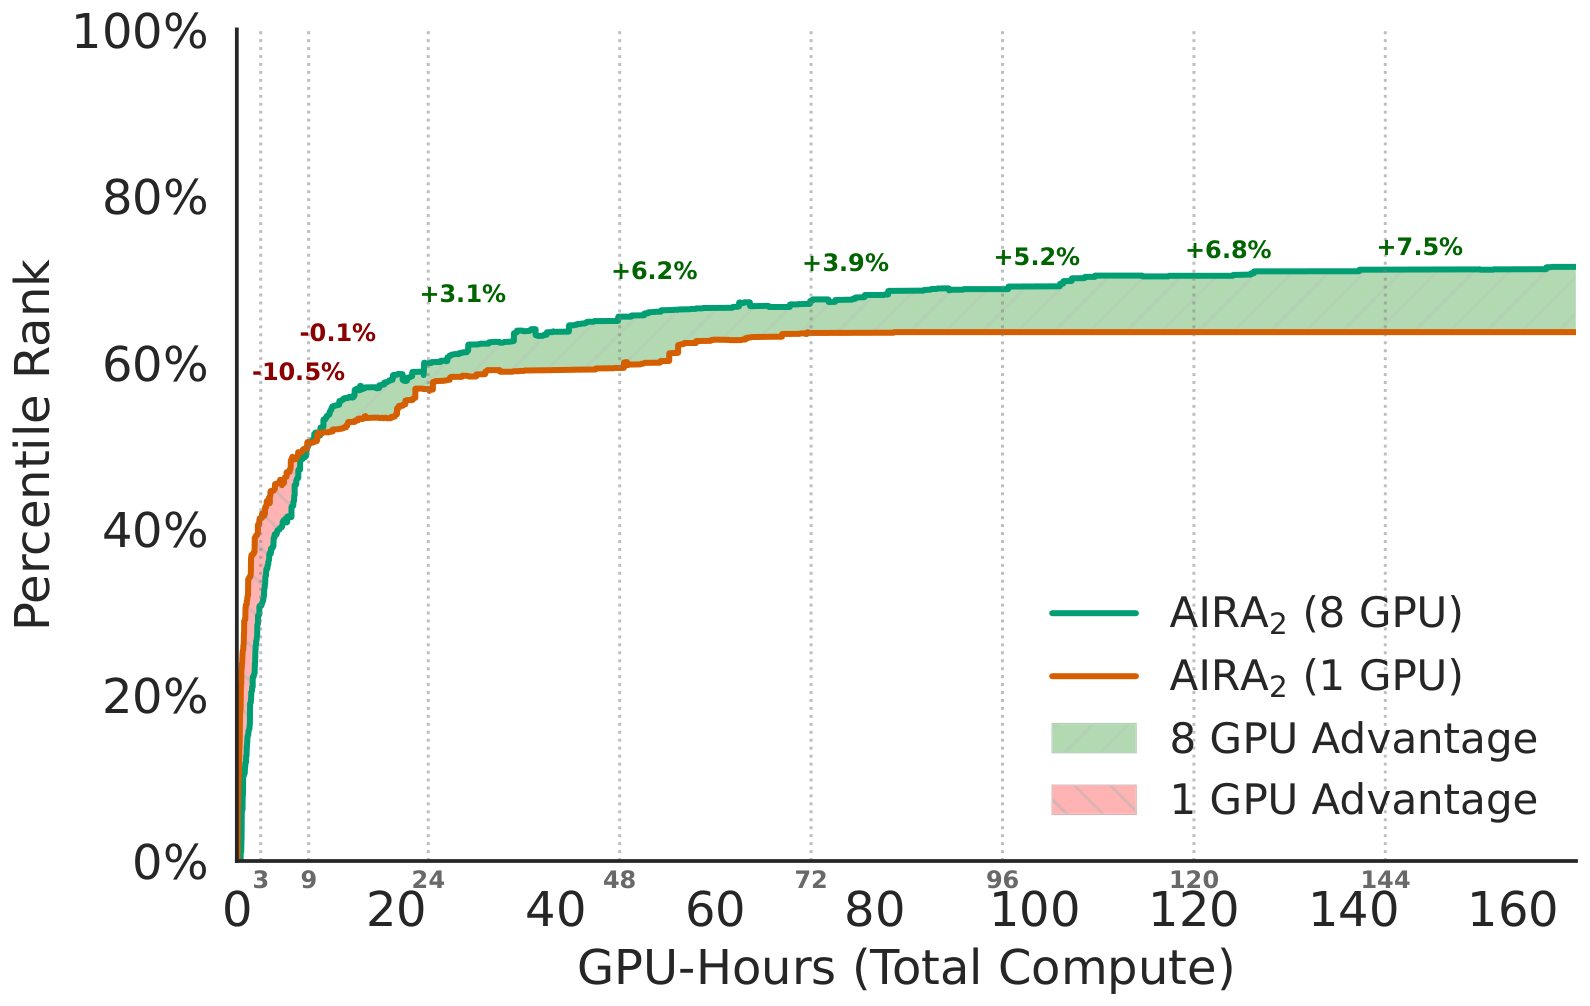
「24時間」は経過時間であり、総計算量ではない。GPU八基のAIRA²は、複数の学習作業を並列に実行できる。図 4 は横軸を総GPU時間に替え、八基構成が初期には一基構成を下回り、その後に上回ることを示す。経過時間ではなく、計算量をそろえた性能の比較である (Hambardzumyan ほか 2026年)。
他の単位にも隠れる違いがある。FML-benchは検証実行100回を固定するが、トークン数と実行時間は変わる。WhatWorkedBenchは購入した測定を数え、初期の2測定が別に付く。Population Evolutionには、反復数をそろえた比較と総GPU量をそろえた比較がある (Zou ほか 2026年; Ning ほか 2026年; Peng ほか 2026年)。答えたい問いに合わせて予算を読む。
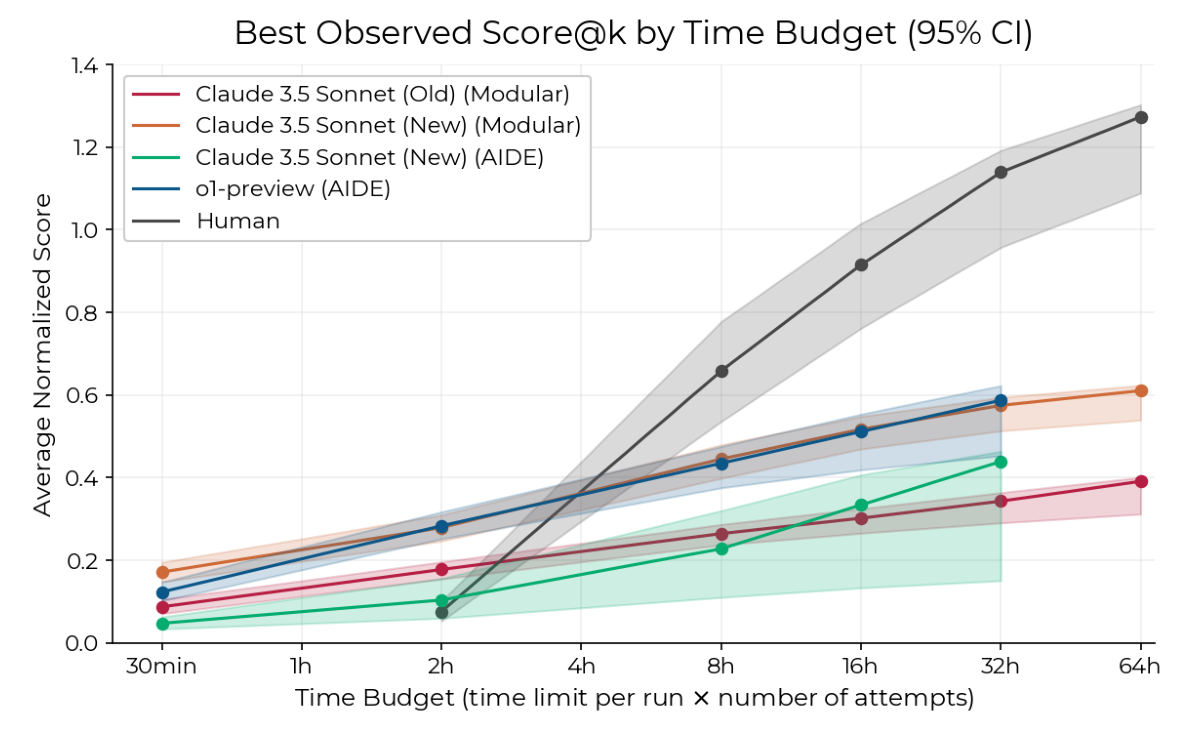
独立した複数試行には、別の選択の問題もある。RE-Benchでは、総予算を固定して短い試行を多数行う利点が見られた。図 5 の横軸は一試行の制限時間と試行数の積であり、各総予算で、両者の組合せを変えた実験のうち最高の score@k を示す。一つの連続実行の進捗でも、予算配分を事前に選ぶ規則の評価でもない。
一つの配分の中では、score@kは利用可能な採点結果で最高の試行を選ぶ。ただし、その結果が見えないScaling Law Experimentではランダムに選ぶ。完了した試行間の選択には利用可能なフィードバックを使うが、公開されたテスト値を参照できることや採点の雑音によって、最高値が新たな独立評価での性能を楽観的に見せる可能性がある (Wijk ほか 2025年)。
実験で示したことを伝える
簡潔な比較でも、五つの問いには答えられる。
- 何を変更したか。 解法コード、提案の操作、探索方策、記憶、エージェント自体を区別する。
- どの結果を見られたか。 開発用スコア、最終選択用スコア、事後的なテスト測定を分ける。
- どの資源を使ったか。 モデル、時間、ハードウェア、並列数、数えている実験の単位を示す。
- 何を返したか。 発見した最高候補と、実際に選んで提出した成果物を分ける。
- 何を成果として測ったか。 有効な提出、予測性能、効果の予測、新規性を区別する。
これらが分かれば、どの設計がどの条件で役立ち、何を再現すればよいかを読者が判断できる。
ここまでで実験の反復がつながる。実行可能な代替案を作り、有用な経験を引き継ぎ、判断に関わる不確実性を診断し、一貫した条件で候補を評価する。これらは互いを支える機能であり、特定の木、記憶形式、スコア一つで代用できるものではない。
図の出典・利用条件
- 出典: (Hambardzumyan ほか 2026年) Figure 2(CC BY 4.0、PNG変換・余白除去)。
- 出典: (Hambardzumyan ほか 2026年) Figure 4(a)(CC BY 4.0、独立パネルのPNG変換・余白除去)。
- 出典: (Hambardzumyan ほか 2026年) Figure 3(a)(CC BY 4.0、独立パネルのPNG変換・余白除去)。
- 出典: (Wijk ほか 2025年) Figure 2(正式出版版、CC BY 4.0、原図領域のPNG変換)。
- 出典: (Wang ほか 2026年) Figure 4(arXiv v1、原図を引用、PNG変換。原論文のライセンス: CC BY-NC-SA 4.0)。