実験結果の理解
スコアの上昇は、ある評価条件で候補がよくなったことを示す。しかし、それだけでは理由は分からない。実験は、考えられる原因を区別し、次に試すことを変えられると、より多くの情報をもたらす。
分類器で符号化とモデルを同時に替えて改善しても、説明は一つに決まらない。モデルが効いたのか、符号化が効いたのか、両者の組合せが重要なのかもしれない。有用な診断は、成功したコードにもっともらしい説明を添えるのではなく、答えによって次の行動が変わる問いを立てる。
学習し直す前に原因を調べる
Irisは、歴史的な日本語の文字と位置を検出するKuzushiji認識の具体例を示す。通常の調整で、適合率と再現率をまとめるF1は0.629から0.661へ上がった後、停滞した。当時の説明はモデルの能力不足であった。ところが推論コードを調べると、検出数に既定の100件という上限があった。密なページでは、認識できる文字も出力時に捨てられていた。上限を外すだけで、再学習せずにF1は0.817へ上がった (Fu ほか 2026年)。
次の診断では、意図した高解像度学習が内部の縮小処理によって効いていないと分かった。この問題への対応後、0.923に達した。図 1 の二つの菱形は、それぞれ対応するスコア上昇の前にある。最初の診断は学習を避け、次の診断は学習が有効になる場所を特定した。
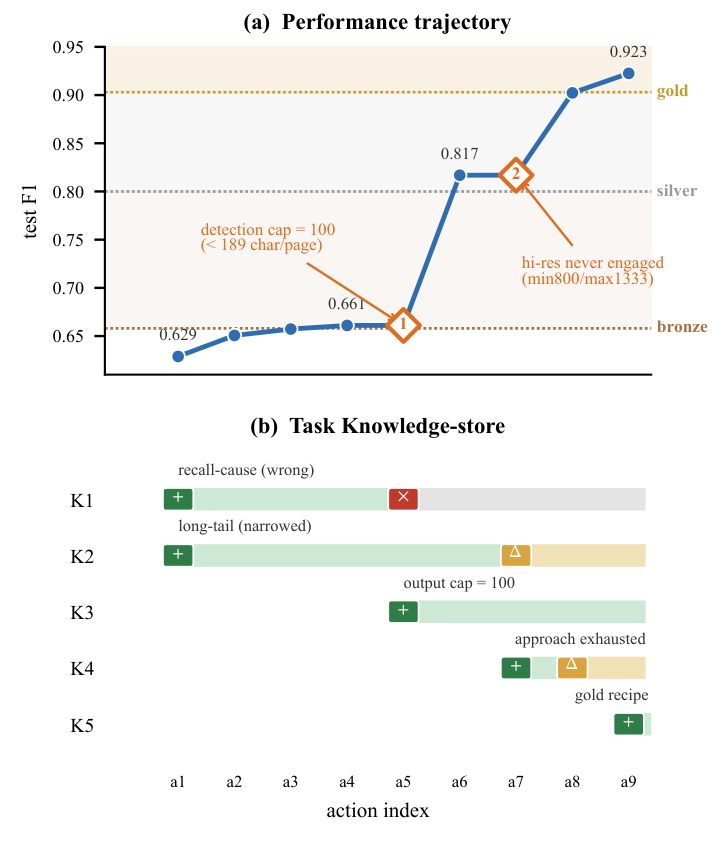
Irisは、解法を変える行動と、保持する解法を置き換えず証拠を得る認識のための行動を区別する。誤り分析、プロファイリング、検証の確認は後者になり得る。問うべきは、診断で直ちにスコアが上がるかではなく、その答えによって次の介入を選び分けられるかである。
説明を蓄積するだけでなく修正する
Irisは、生の証拠、行動の要約、課題についての主張を分けて保持する。主張には適用範囲、支持・反証の証拠、有効・条件付き・無効という状態を記録する (Fu ほか 2026年)。
出力上限の発見は、再現率が低い理由についての最初の説明を無効にした。後の証拠は希少文字についての主張を狭め、ある方法をやり尽くしたという判断を改めた。退けた説明が、その後も当然の前提として残ることを防ぐ仕組みである。
毎回の編集前に診断する必要はない。既存の証拠から次の介入が明らかなら、そのまま進む。論文はMLE-bench全体で12時間予算のメダル率64.9%を報告する。部品別のアブレーションはより狭く、少量データの15課題で各構成一度ずつである。認識のための行動を除くとメダル率は66.7%から60.0%へ、情報管理を除くと53.3%へ下がった。軌跡は仕組みがどう働くかを説明し、アブレーションは平均的な寄与について限定的な証拠を与える。
条件を変えたときの効果を予測する
WhatWorkedBenchは、まだ測っていない結果を予測できるかという別の理解を調べる。小さな実験空間には4個または6個の二値の選択肢がある。エージェントは全オフと全オンの測定を受け取り、予算内で別の構成を測定して、全構成の効用値を提出する。効用値は、大きいほどよい向きにそろえた課題の性能値である。採点側は全組合せの実測値を持ち、予測を確かめる (Ning ほか 2026年)。
条件付き効果は、他の選択肢を固定して一つだけ切り替えたときの効用差である。その差が別の選択肢によって変われば、相互作用がある。図 2 のSciFactの例では、TFの対数変換がオフなら出現回数の二値化が改善をもたらし、オンなら悪化させる。二値化した側の結果は同じでも、比較元の生の出現回数を使う側の結果が変わる。
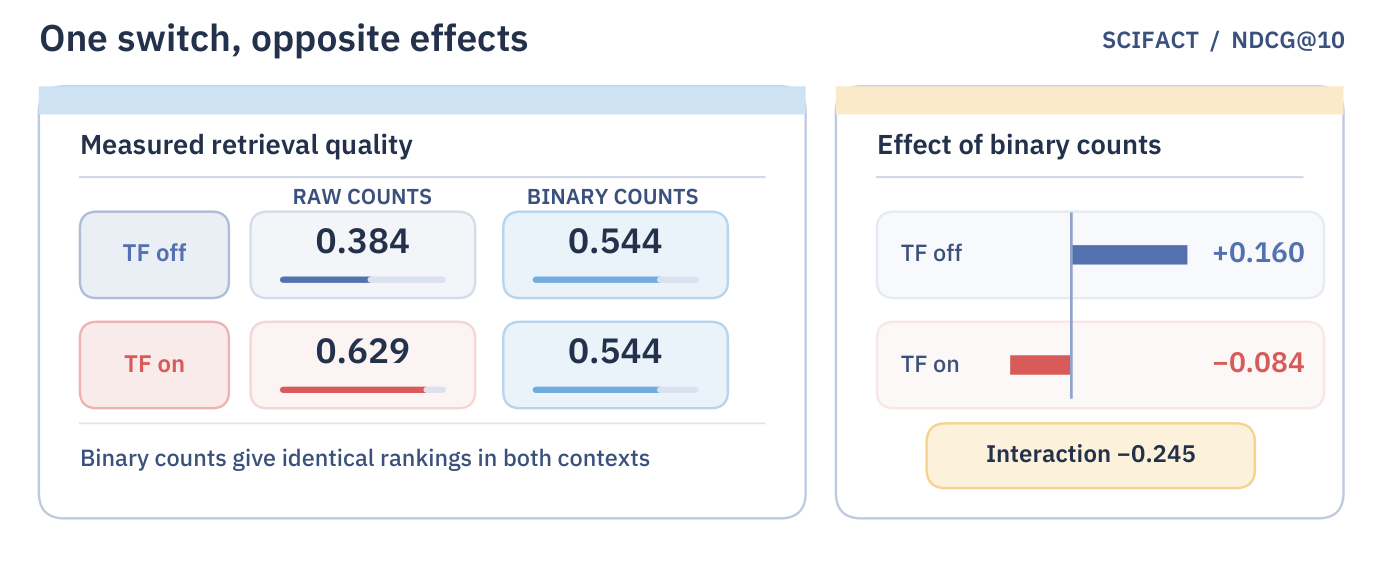
これにより、勝者の発見と効果の復元を直接分けられる。4因子の22ソースで、初期2測定に加えて8測定を行うと、二因子の相互作用を含むリッジ推定は15例で最適構成を選んだ。だが、その15例中13例には、効用範囲の10%を超える条件付き効果の予測誤差があった。最適構成を正しく選べても、実験空間全体の条件付き効果の少なくとも一つは大きく予測を誤っていた (Ning ほか 2026年)。
よい提出物には、それ自体の価値がある。追加の検査は、得た測定が他の構成についての判断も支えられるかを問う。変更を転用するときや、なぜ効いたかを説明するときに必要になる能力である。
同じ測定から多くの情報を得る
予測が悪い理由には、測定不足と、観測値から未測定値を復元する方法の不適切さがある。WhatWorkedBenchは両方を比べる。真の効果がすべて0ではない課題の復元度は、条件付き効果の平均絶対誤差を、真の効果の絶対値の平均で割り、1から引いて下限を0にした値である。1は完全な復元、0は誤差が真の効果の平均的な大きさ以上であることを示す。
図 3 はこの値を課題群で集約したもので、同じ測定予算でも復元方法によって差があり、特に6因子のパネルで差が開く。同じ観測からでも推定器によって予測は変わり、どの構成を測る方策がよいかという順位も、推定器との組合せによって変わる (Ning ほか 2026年)。
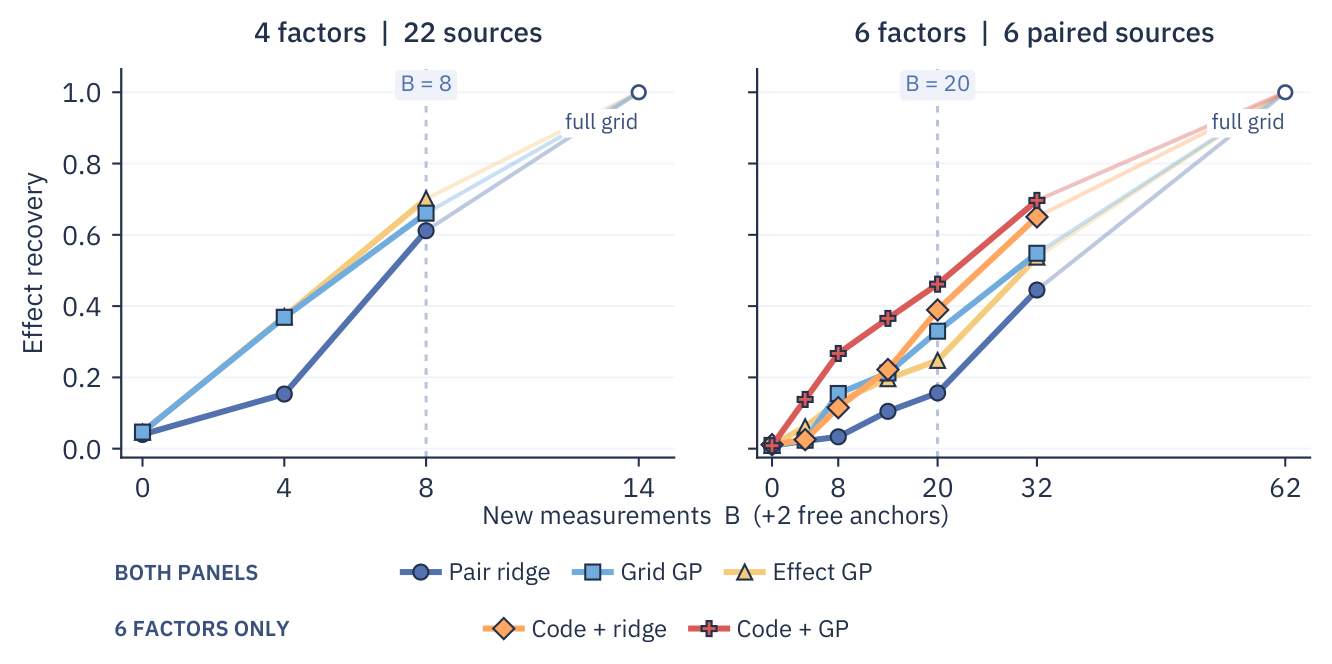
一部のエージェント実験では、渡されたリッジ復元をガウス過程へ替えるだけで、追加測定なしに予測が改善した。後の12ソースの実験では、数値表の直接提出に加え、名前を指定して推定器を呼ぶ方法も用意した。DeepSeek Flashは全12ソースで数値表を提出し、同じ観測を使うガウス過程を上回った一方、Proの全試行を含む比較では同じ利得はなかった。測定の窓口と復元方法も課題の一部であり、エージェントの普遍的な失敗や優越を示す結果ではない。
評価の範囲は意図的に限定されている。指定した二値空間の数値的効果を調べるのであり、自由な説明文が新しい科学的機構を発見したかを測るものではない。
比較を計画し、新規性を判断する
効果を測る前には、情報を得られる比較を計画する必要がある。AblationBenchは、著者が実施した実験や査読者が求めた追加実験を、提案したアブレーションが再現できるかを評価する。図 4 では、表示されたすべての計画器で、除去案のRecall@5が変更案より高い。新たな学習実験を動かすのではなく、提案と参照計画の意味的な対応を採点している (Abramovich と Chechik 2026年)。
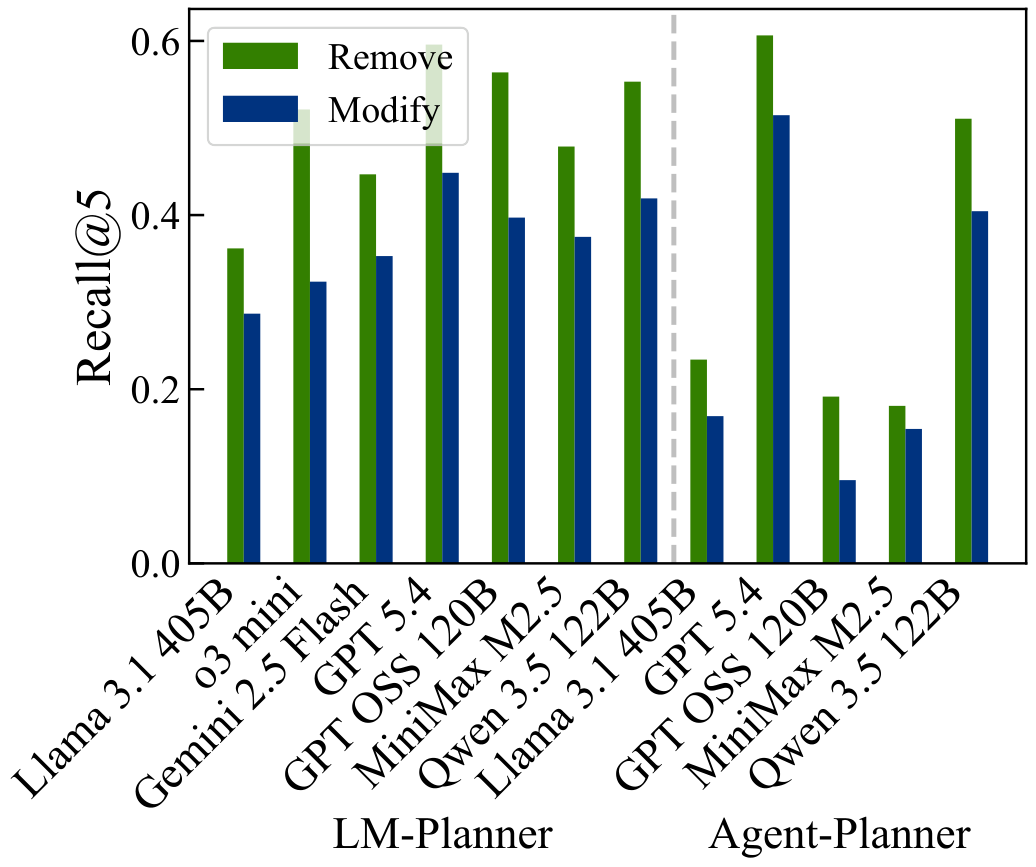
部品の除去と置換は、違う問いに答える。除去は現在のシステムがその部品へどう依存するかを調べ、置換は特定の実装であることが重要かを調べる。参照計画との一致は計画能力の評価になるが、有用な未掲載案は低く評価され得るし、実行後に得られる情報は測っていない。
新規性は、さらに別の性質である。Can LLM Agents Discover? は、同じ試行内の過去の案に対する新規性をP-creativity、公開された人間の解法に対する新規性をH-creativityと呼ぶ。実行できるか、課題の性能に役立つかは別に測る。
有用性の指標であるImpactは、サンプル提出の基準スコアからの改善を、その基準と人間の首位スコアとの差で正規化した値である。0が基準、1が人間の首位に対応する。図 5 のキャッサバ分類の試行では、Episode 3のH-creativityが最高でも、ImpactはEpisode 4がわずかに高い (Bhushan ほか 2026年)。
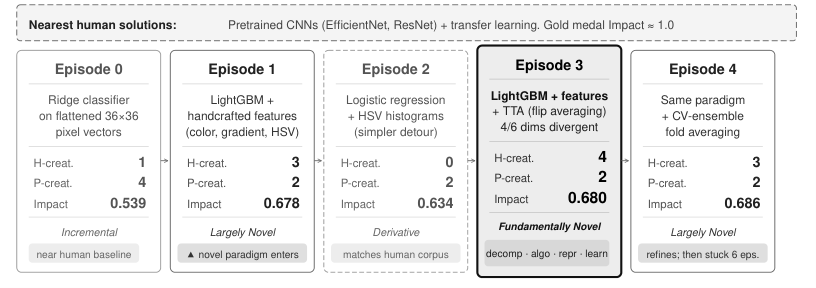
広い軌跡分析では、過去の案に対する新規性が下がっても、スコアは改善し得た。図 6 の小規模な方策比較では、左に有用性、右にP-creativityがある。貪欲探索とMCTSは概して新規性を失うが、進化的探索は終盤に新規性を上げても、有用性で一貫した優位を示さない。両方を一貫して改善する探索方策はなかった。
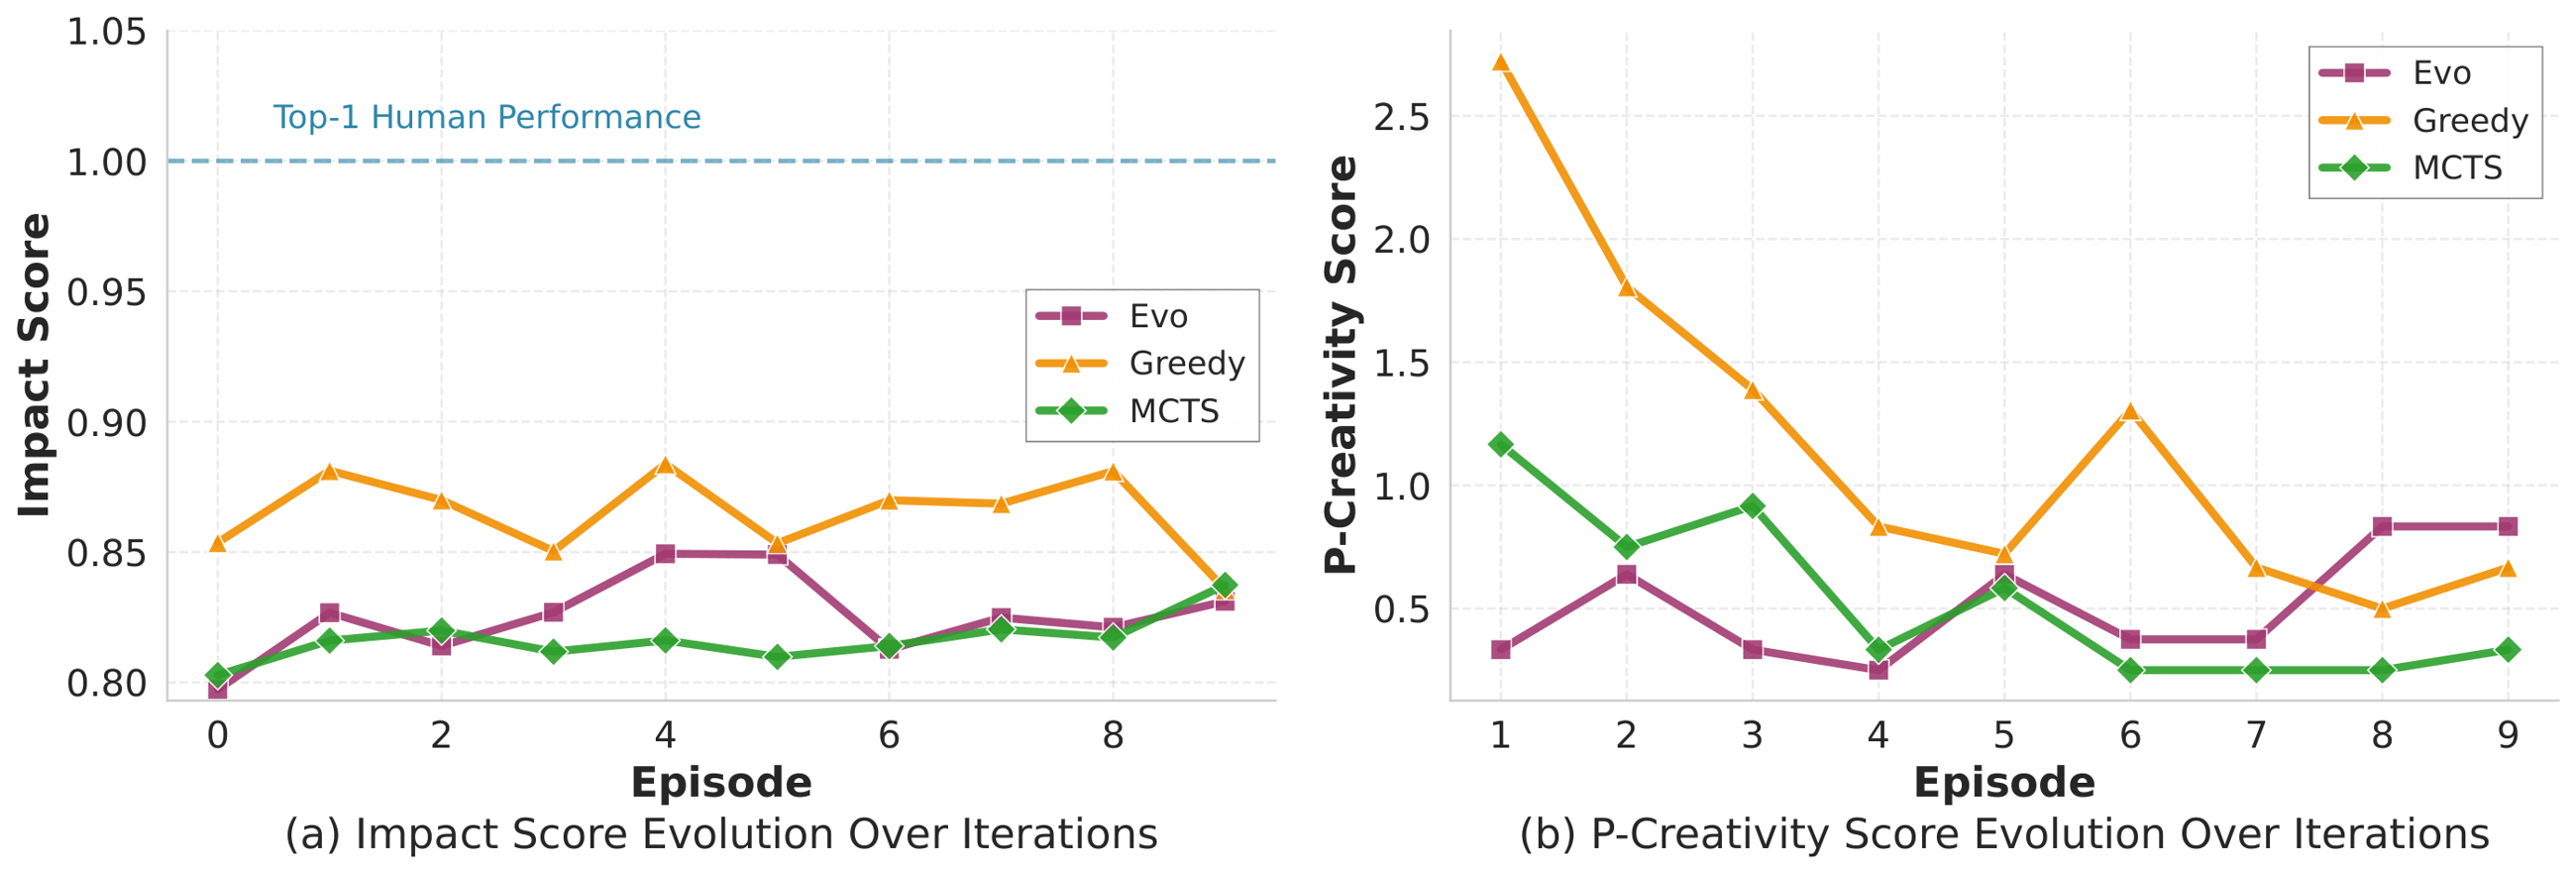
新規性を測る範囲は、参照コーパスと判定器で決まる。非公開の仕事や科学全体に対する新規性を確立するものではない。
実験の反復では、強い候補を見つけること、変更の効果を予測すること、有益な比較を計画すること、有用で新しい案を作ることを区別する。次章では、もう一つ必要な仕事である最後に強い候補を選ぶことを扱う。
図の出典・利用条件
- 出典: (Fu ほか 2026年) Figure 4(原図を引用、PNG変換)。
- 出典: (Ning ほか 2026年) Figure 2(原図を引用、PNG変換)。
- 出典: (Ning ほか 2026年) Figure 4(原図を引用、PNG変換)。
- 出典: (Abramovich と Chechik 2026年) Figure 3(CC BY 4.0、原図のPNG変換)。
- 出典: (Bhushan ほか 2026年) Figure 5(CC BY 4.0、原図のPNG変換)。
- 出典: (Bhushan ほか 2026年) Figure 3(CC BY 4.0、原図のPNG変換)。