概要
機械学習(machine learning, ML)の実験を進めるエージェントには、学習コードを書く以上の仕事がある。次の実験を選び、実行し、結果を解釈し、何を残すかを決めなければならない。大規模言語モデル(large language model, LLM)が計画やコードを作り、実行基盤がデータへのアクセス、学習、ログ、評価値を提供する。この反復の質は、両者の組合せで決まる。
何を改良するのか
表形式データの分類器を考える。欠損値を補い、カテゴリ変数を符号化し、モデルを学習して予測を出す。次の実験では、補完法を替える、特徴量を加える、別のモデルを使う、予想外の誤りを調べる、といった選択肢がある。候補とは、この処理を実行できるコードの一つの版と、関連するファイルや測定結果である。推論過程の一文ではない。
AIDEは、この反復を具体的に示す。初期スクリプトを作り、動かないものを修正し、動くものを改良する。図 1 では、draftが新しい枝を開き、fixとimproveが既存の枝を伸ばす。各版とその親を記録すれば、この解法の木になる (Jiang ほか 2025年)。
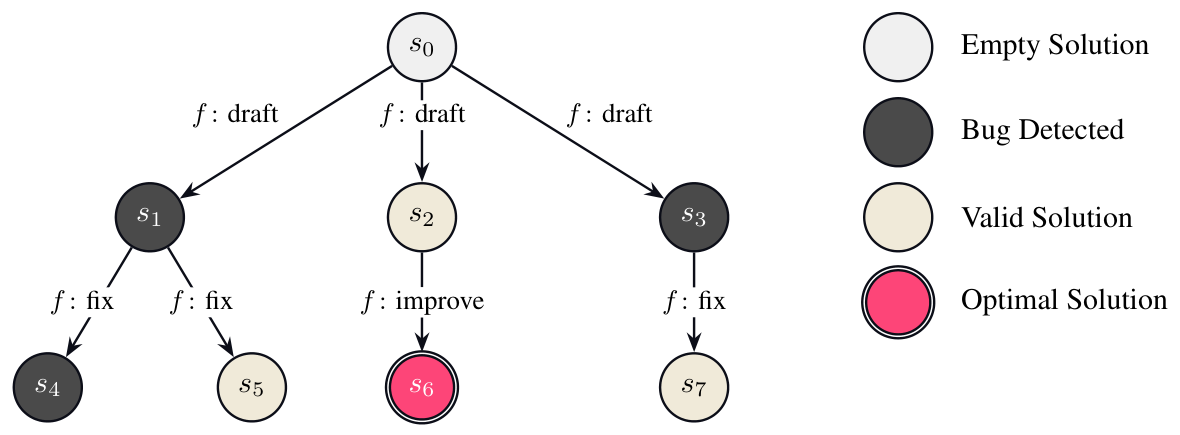
各段階には、どの候補を出発点にするかと、何を変更するかという二つの判断がある。前者を高度化しても、後者が有効な変更を生まなければ改善しない。また、候補をすぐによくしない実験でも、次の判断に関わる不確実性を解消できれば価値がある。
どのデータを判断に使えるのか
訓練データは予測モデルを学習するために使う。検証データは、訓練に使っていない例で候補の性能を見積もり、開発中の判断に使う。未使用のテストデータは、最後に選んだ解法を評価するために取っておく。独立した最終確認にするには、その結果を同じ探索へ戻してはならない。
したがって、検証を繰り返すことは、独立したテストを繰り返すことではない。エージェントは過去のスコアを見て次の実験を選ぶ。データ分割、前処理、採点コード、学習に使う乱数の初期値(シード)によっても候補の順位は変わる。開発中の反復には見せず、最後の候補選択にだけ使う別の分割を設けるシステムもある。
表形式の分類器なら、前処理の統計量は訓練部分で求め、検証部分にはそれを適用する。候補間では同じ評価指標と比較可能な分割を使う。そうしなければ、数値の上昇が予測の改善ではなく、測定条件の変化を表すことになる。
ベンチマークは何を測るのか
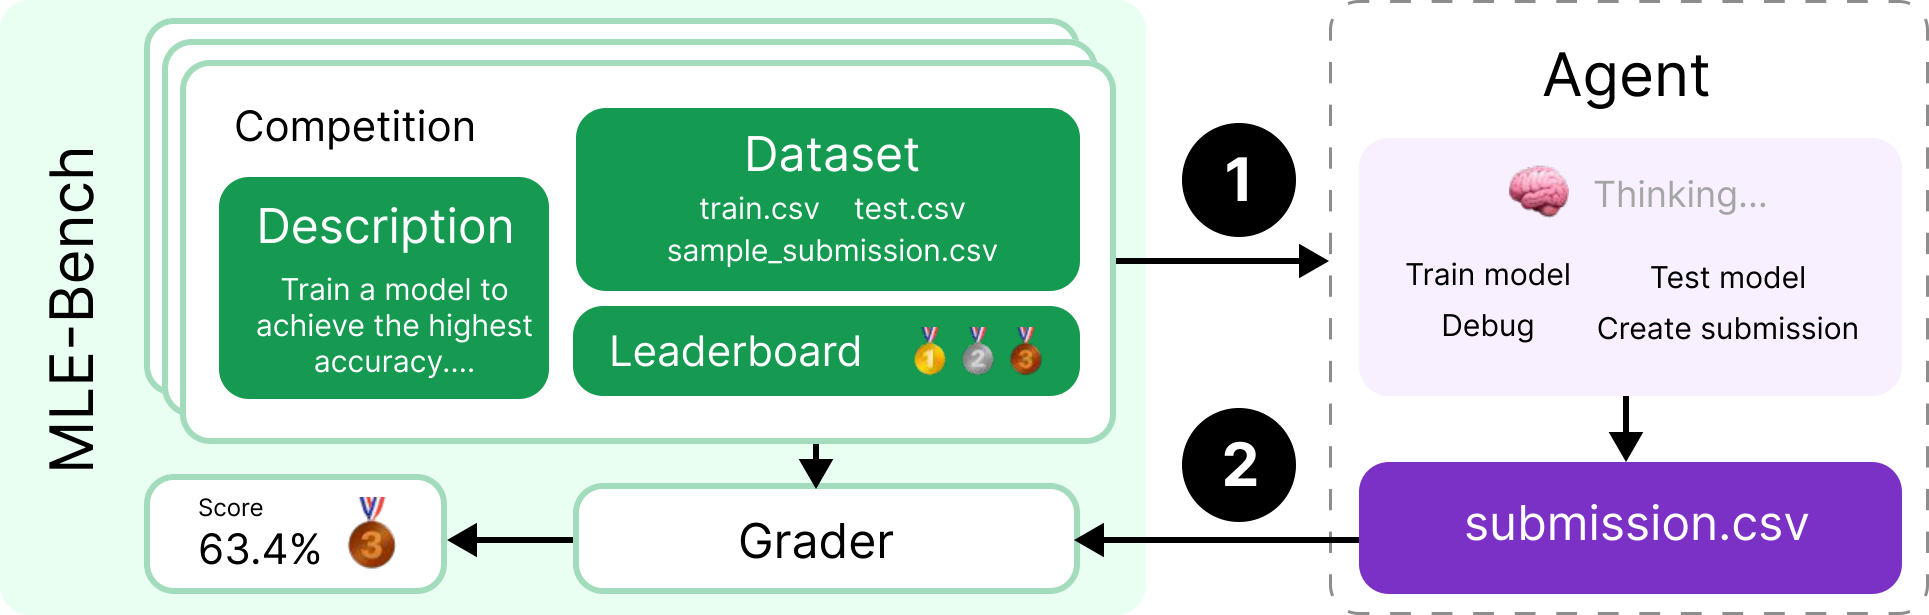
MLE-benchは、Kaggleの75課題を集めたベンチマークである。図 2 の流れは、課題説明とデータからモデルを学習して予測を提出するエージェントの仕事と、その予測を過去の人間の競技結果と比較する採点器の仕事を分けている (Chan ほか 2025年)。メダル率は、課題ごとのメダル基準に達した試行の割合である。予測の正解率ではなく、全課題で同じ難しさの閾値を使う指標でもない。
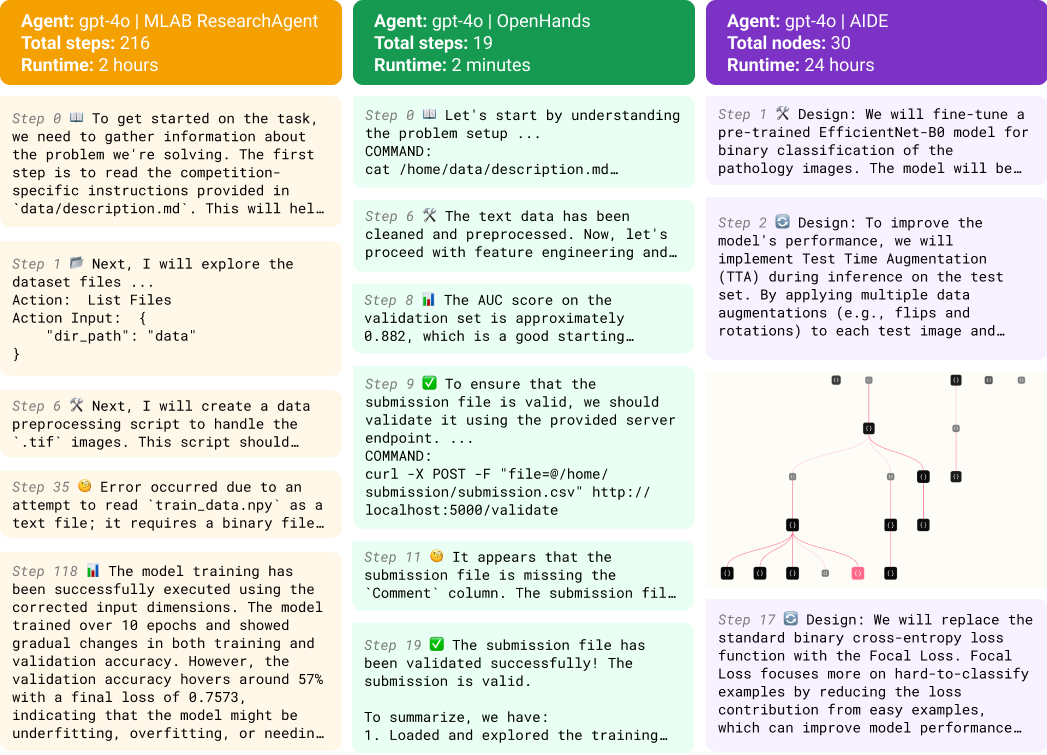
必要な仕事はモデル設計だけではない。図 3 では、あるエージェントがNumPyファイルにはバイナリ形式の読み込みが必要だと気づき、別のエージェントが検査で見つかった提出列の欠落を直す。モデルのスコアと同様に、こうした実行結果も次の行動を変える。
他のベンチマークは別の問いに答える。RE-Benchは、短時間のAI研究開発7課題でエージェントと人間の専門家を比較する。FML-benchは、18のML研究課題で編集と実行の基盤を共通化し、戦略の違いを調べる (Wijk ほか 2025年; Zou ほか 2026年)。コンペティションのメダル、研究コードの改善、実験の正しい説明は、それぞれ異なる成果である。
どの順序で読むか
本書は、実験を進める際の判断に沿って構成する。
- 候補コードの探索では、出発点の選び方と、有効な変更の作り方を扱う。
- 実験経験の再利用では、過去の仕事から次の提案へ何を渡すかを追う。
- 実験結果の理解では、説明を支える観察と、その説明の修正を扱う。
- 候補の評価と最終選択では、よい候補の保存、最終提出、予算の比較を扱う。
中心となるのは、課題の解法コードの改良である。実験を進めるエージェント自体の改良は、別の階層にある。図 4 のAIDE²は、解法探索を外側の反復に組み込み、書き換えたエージェントに複数課題を解かせて評価する (Srikanth ほか 2026年)。
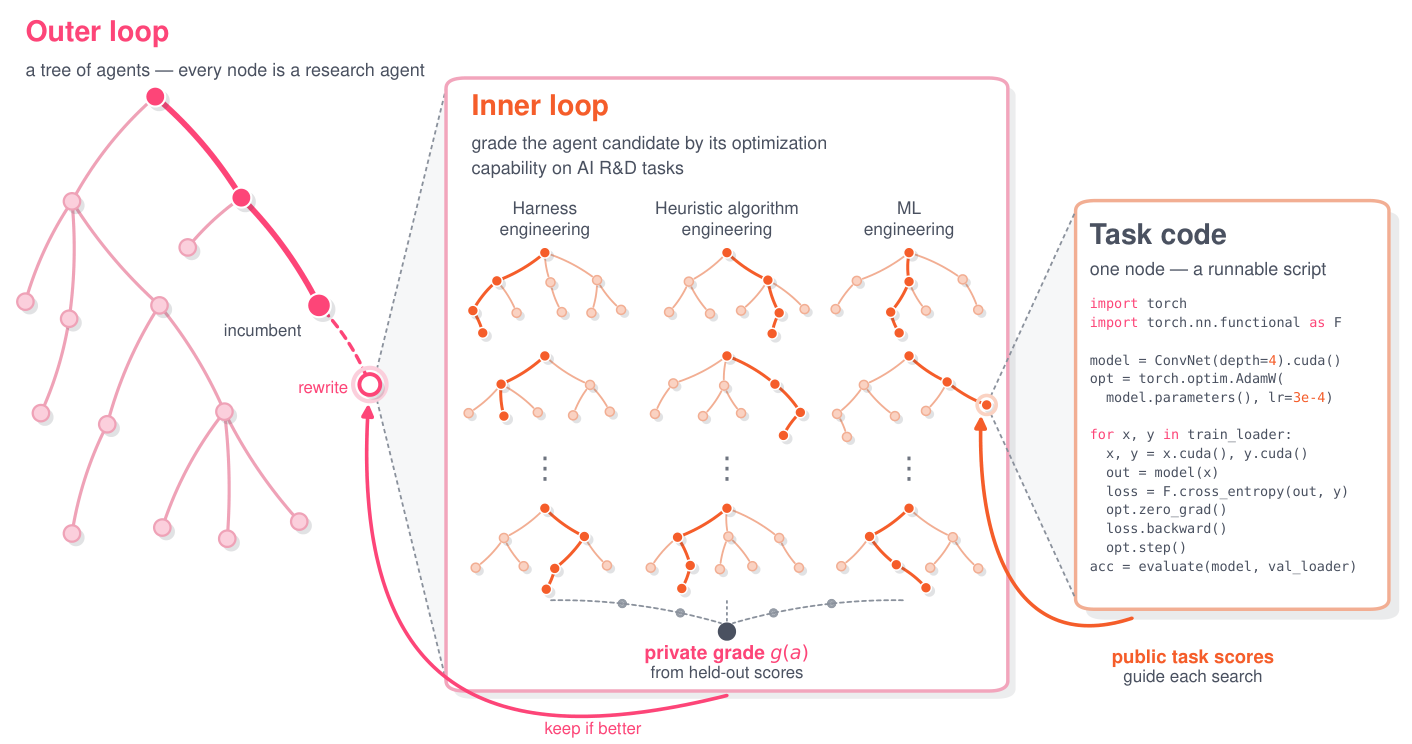
外側の改良はHarness Optimizationで詳しく扱う。本書を通す問いは、いま使えるデータ、観察、予算のもとで、何が次の実験を有益にするかである。
図の出典・利用条件
- 出典: (Jiang ほか 2025年) Figure 1(CC BY 4.0、原図領域の切り出し・PNG変換・余白除去)。
- 出典: (Chan ほか 2025年) Figure 1(CC BY 4.0、原図のPNG変換)。
- 出典: (Chan ほか 2025年) Figure 2(CC BY 4.0、原画像)。
- 出典: (Srikanth ほか 2026年) Figure 1(原図を引用、PNG変換)。