エージェントコードの進化
ファイルを書き換えるたびに全文を生成するエージェントでは、小さな修正にも長い出力が必要となり、変更しない部分まで壊すおそれがある。この問題に「正確に編集せよ」という指示を足すだけでなく、一意に一致する文字列だけを置換する編集関数へ変えられないだろうか。本章が扱うのは、このようにエージェントが使う関数や、エージェント自体の実装を、実行評価に基づいて更新する方法である。更新後のコードは一問への回答ではなく、後続の問題にも使われる。
ただし、コードを書き換えられることと、書き換えによって能力が向上したことは別である。何を変更できるのか、過去のどの候補を次の出発点とするのか、変更後のどの実装を何で評価したのかを分けて読む必要がある。関数集合を更新する AgentOptimizer、エージェントをコードで設計する Automated Design of Agentic Systems(ADAS)、自己改変と候補の系譜を扱う Darwin Gödel Machine(DGM)を軸に、その違いを見ていく。これらはそれぞれ ICML 2024、ICLR 2025、ICLR 2026 の採択論文である。(S. Zhang ほか 2024年; Hu ほか 2025年; J. Zhang ほか 2026年)
指示の変更では直せない部分をコードで変える
変更対象を具体的にするため、DGM が実際に生成した編集機能を見よう。初期エージェントの編集ツールは、既存ファイルを与えられた全文で上書きするものであった。論文付録 F.1 に掲載された最終最良候補への差分では、これを str_replace に置き換え、検索文字列と置換文字列を引数として受け取る。次は追加された関数本体からの短い抜粋である。例示用に作った修正ではない。(J. Zhang ほか 2026年, Appendix F.1, pp. 42–43)
content = read_file(path)
occurrences = content.count(old_str)

if occurrences == 0:
    return f"Error: Could not find the exact text to replace in {path}"
elif occurrences > 1:
    return f"Error: Found multiple ({occurrences}) occurrences of the text in {path}. Must be unique."
else:
    new_content = content.replace(old_str, new_str)
write_file(path, new_content)ここでは「文字列を置換する」という説明文だけでなく、一致がゼロ件または複数件なら編集しない条件が実装されている。実際の変更はこの抜粋に加え、ツールの引数スキーマ、コマンドの分岐、テストにも及ぶ。したがって評価すべき対象は、この数行を単独で取り出したものではなく、それらを組み込んだエージェント全体である。
DGM の結果節と Figure 3 は、行単位の閲覧、文字列置換による編集、文脈長上限での要約、複数の修正案の生成と順位付けなどが探索中に得られたことを示す。ただし、最終的なスコア向上を上の置換条件だけの効果に帰属させることはできない。付録の差分は実在する実装変更の証拠であり、全機能を一つずつ取り除いた因果的な効果測定ではない。(J. Zhang ほか 2026年, Section 4.4 and Appendix G)
この例から、コード最適化の範囲には段階があることが分かる。呼び出し可能な関数を変える方法と、その関数をいつ使い、何回試し、どの結果を採用するかまで変える方法では、探索できるものが異なる。
関数集合からエージェントの実装へ広げる
まず狭い変更範囲でも、モデルの重みを変えずに行動能力を更新できる。AgentOptimizer は、関数をエージェントの学習可能なパラメータに見立てる。入力は現在の関数集合、訓練問題での実行履歴、生成回答と正解、訓練成績である。最適化を担う大規模言語モデル(LLM)は、それらを読み、関数の追加・修正・削除を段階的に行う。更新後に測るのは関数のコード品質そのものではなく、その関数集合を利用するエージェントの問題解決成績である。(S. Zhang ほか 2024年, Section 2)
この方法は、問題ごとに一度だけ便利な関数を生成して捨てる仕組みではない。訓練を通して関数集合を残し、未見の問題で使う。訓練成績を悪化させた変更を取り消し、改善しない更新が続けば終了する仕組みも持つ。しかし、過去の多様な実装を分岐探索の親として保持する DGM 型の候補集合ではない。主な更新対象は関数集合であり、エージェントの制御全体を毎回自由に再設計するわけではない。
実験は MATH、表形式の算数問題である TabMWP、実世界の質問を集めた GAIA の部分集合で行われる。MATH と GAIA では、最適化器と実行エージェントに GPT-4-1106-preview を使う。TabMWP では最適化器は同じ GPT-4、実行側は GPT-3.5-turbo-1106 である。したがって、三つの課題の数値を単一モデルの一様な改善率としてまとめるべきではない。(S. Zhang ほか 2024年, Section 3.1)
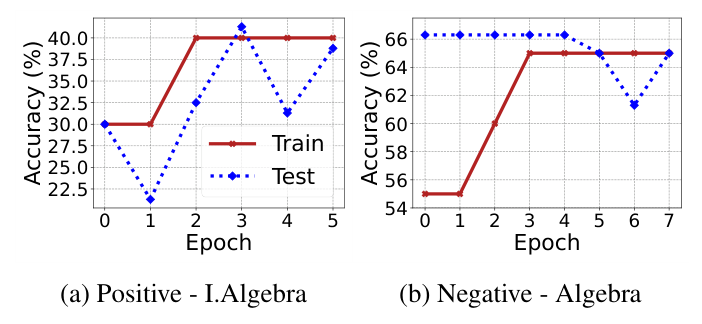
より重要なのは、関数を生成するだけでは十分でないという同一論文内の比較である。MATH の中級代数について、GPT-4+ エージェントの正答率は未訓練で 30.0%、段階的な関数更新を一括生成に置き換えると 28.8%、完全な手法では 38.8% である。変更の取り消しと早期終了をともに外した条件は 36.3% であった。これは限られた部分集合での結果であり、取り消しと早期終了の効果を個別には分離していない。それでも、変更内容だけでなく変更の刻み方と採用基準も性能を左右することを示す比較となっている。(S. Zhang ほか 2024年, Table 3)
図 1 は、訓練成績の改善と未知問題での改善が常に一致しないことを示す。論文が対比のため選んだ中級代数と代数の二例であり、全種類の平均的な学習曲線ではない。最終反復の実装が、テスト上でも最良とは限らない点を読み取れる。
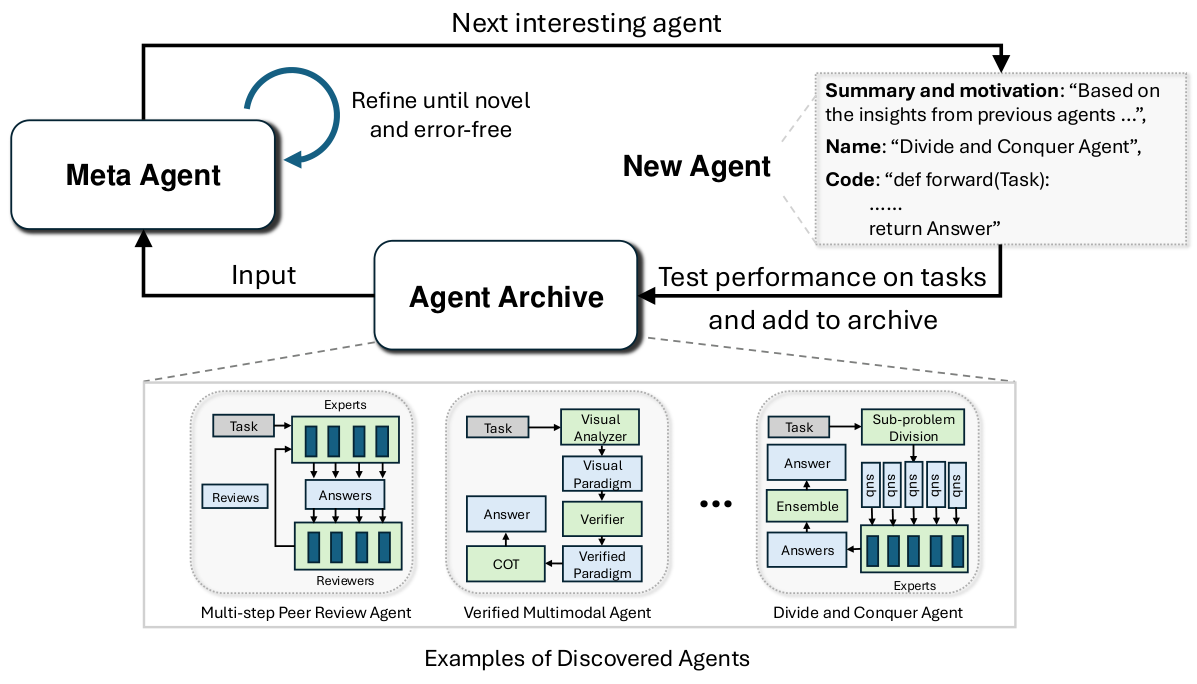
関数集合という枠を外すと、LLM 呼び出し、反省、投票、情報の受け渡しを含む実装も変更できる。ADAS が示した Meta Agent Search は、固定されたメタエージェントが新しいエージェントのコードを書き、評価し、発見済み候補の集合へ加える方法である。各候補の説明、コード、評価結果を次の設計に利用するため、過去の試みが単なる実験ログではなく、次の生成を条件づける情報となる。(Hu ほか 2025年, Section 3)
例えば、複数の推論結果を作り、それぞれを批評・修正してから統合する構成を、実行関数の内部に記述できる。ただし、論文がコードを汎用的な表現と位置づけることと、実験であらゆる実装を探索したことは同じではない。実験では提供された LLM 呼び出しや評価の枠組みを使い、その中で新しい制御を記述する。発見された実装を付録で確認できることが、単なる設計案の生成との違いである。
図 2 では、次の実装を書くのは左のメタエージェントであり、実行する新候補と区別されている。下部の三つは論文が発見した構成例である。アーカイブにある候補のコードをメタエージェントが参照することと、候補自身が自己改変することは同じではない。
ADAS の ARC 実験では、5×5 以下の格子を持つ問題から探索用 20 問とテスト用 60 問を分け、GPT-4 のメタエージェントで 25 反復を行う。実行エージェントと比較手法には GPT-3.5 を使い、確率的な変動を減らすため各評価を 5 回行う。Figure 3 の曲線は、この条件の未使用テスト問題での成績である。さらに MGSM から別の数学課題や非数学課題への移行、ARC 上での実行モデルの変更を別に調べている。探索中の評価、同じ課題の未使用問題、別課題への移行という三つを混同しないことが重要である。(Hu ほか 2025年, Sections 4.1 and 4.3)
低い成績の候補を次の改善につなぐ
新しい候補を作る際、現在最良の実装だけを出発点にすればよいとは限らない。ある変更が直後には成績を下げても、後から別の変更を組み合わせるための土台になることがある。ここで必要なのが、過去の実装を残す候補集合、すなわちアーカイブと、どの候補から次に分岐するかを決める親選択である。
DGM は、この二つを自己改変に組み合わせる。選ばれた親エージェントは自分の評価ログから次に実装する機能を提案し、自分自身のコードベースを編集する。生成された子エージェントをコーディング課題で評価し、コンパイルと基本的な編集能力を保った候補を候補集合へ加える。ADAS の固定メタエージェントによる設計とは異なり、改良された実行エージェント自身を、その後の自己改変にも使う点が中心である。ただし、実験でモデルの重みは更新せず、候補集合の管理や親選択の外側の仕組みも自己改変の対象ではない。(J. Zhang ほか 2026年, Section 3)
親選択は、おおむね候補の成績が高いほど、また基本的な編集能力を持つ子が少ないほど選びやすい。高得点の実装を活用しつつ、既に何度も試した系譜への集中を避ける設計である。候補集合内の親にはゼロでない選択確率を残す。これにより、直前の最良候補とは異なる地点からも改善を試せる。
図 3 の左側では、節点がエージェント、辺が自己改変による親子関係を表す。節点内部の色は SWE-bench の成績、外周色は評価した問題数である。赤い外周は基本機能を保てなかった試行を含むため、図に描かれたすべての節点が後続の親として利用できたわけではない。右側の黒い線は、探索中の最良値の推移ではなく、最終最良エージェントに至った祖先の成績である。途中に二度の低下があり、一時的な悪化を含む系譜から最終候補が得られたことが分かる。(J. Zhang ほか 2026年, Figure 3)
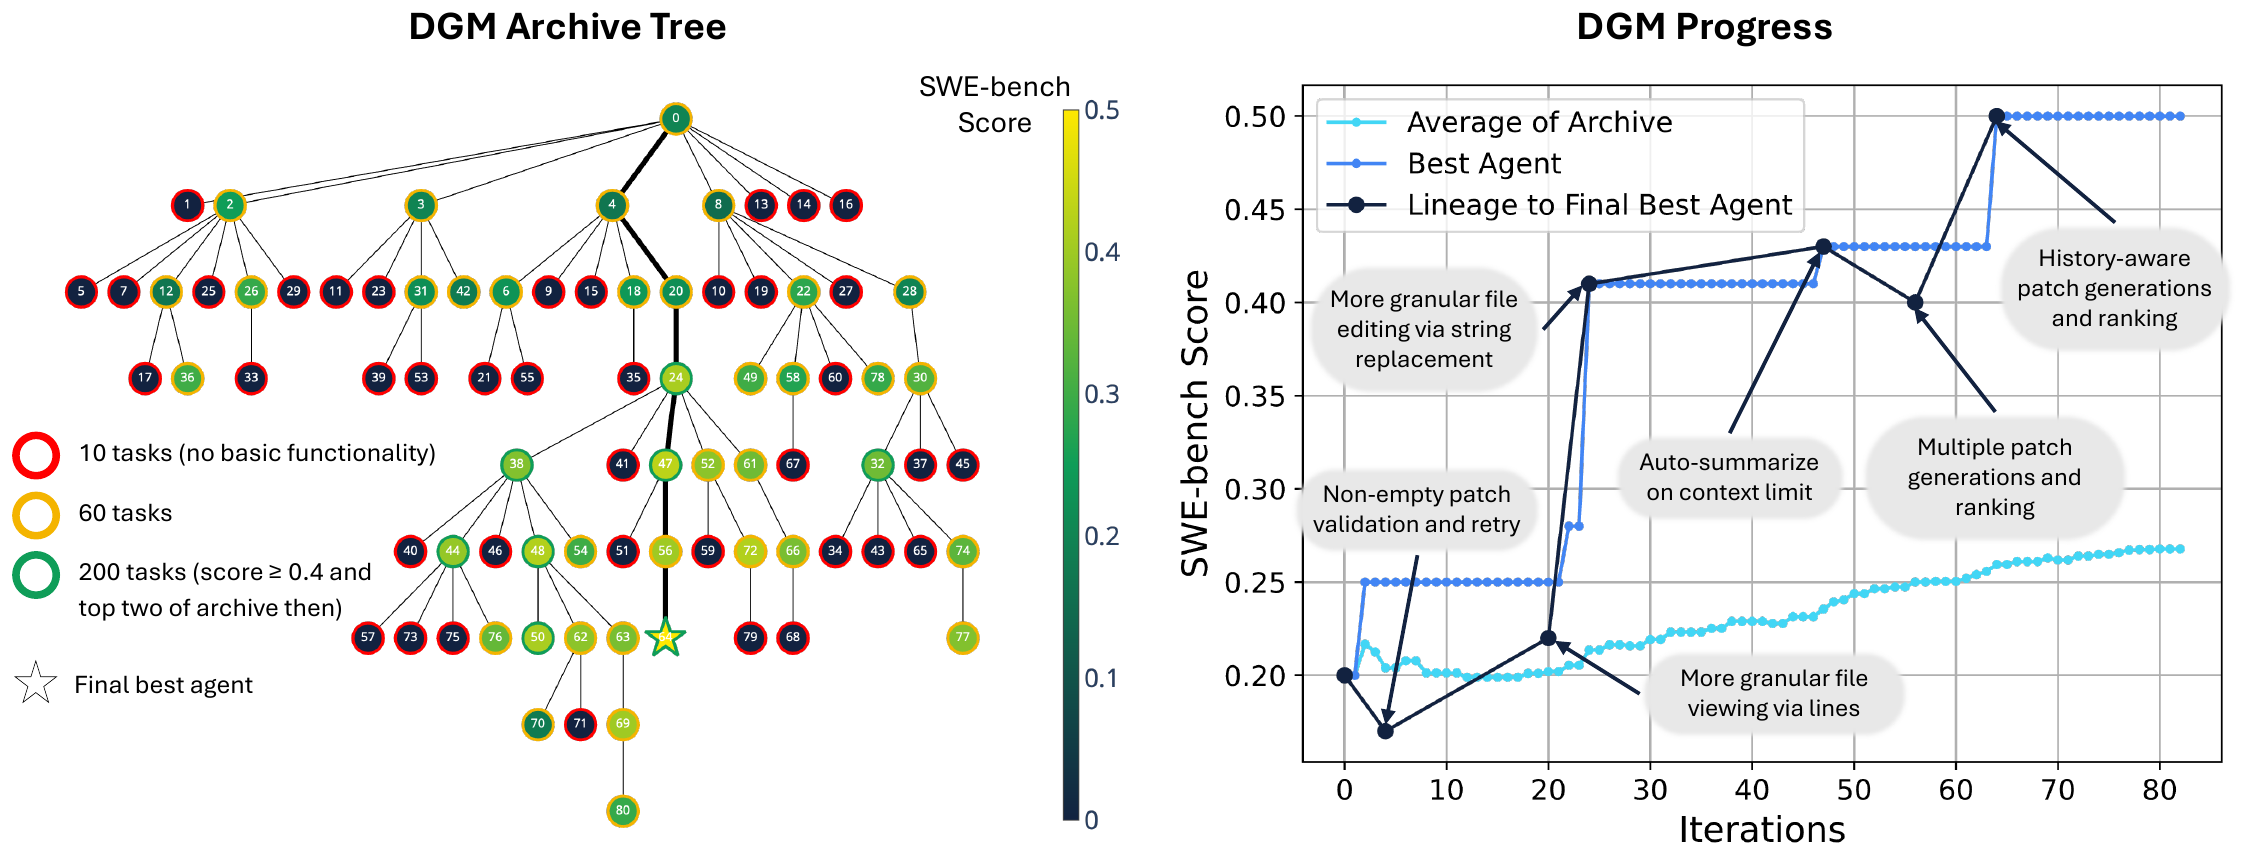
この実験は 80 反復であり、自己改変には Claude 3.5 Sonnet(New)を使う。評価時は SWE-bench では同モデル、Polyglot では o3-mini を使う。評価費用を抑えるため、基本機能を確かめる少数問題から始め、有望な候補へ追加評価を配分する。SWE-bench の高成績候補は 200 問まで評価する一方、Polyglot の探索曲線は 50 問の部分集合に基づく。(J. Zhang ほか 2026年, Sections 4.1–4.2)
数値の母集団にも注意が必要である。Polyglot の探索用 50 問では初期 14.0% から最良 38.0% へ上がるが、同じ初期候補と選ばれた最良候補を全問題で評価した結果は 14.2% と 30.7% である。全問題での評価にも探索に使った問題が含まれるため、それ自体を完全に独立した未使用テストと呼ぶことはできない。また、論文の評価は正解テストの結果を途中で見せない pass@1 であり、正解テストから一度フィードバックを得る Aider の pass@2 と同条件ではない。(J. Zhang ほか 2026年, Sections 4.2 and 4.4)
探索機構を調べる対照条件もある。初期エージェントを固定して変更案を作り続ける条件は、改善したエージェントを次の改変に使う効果を外す。最新の実装だけから次へ進む条件は、候補集合から別の系譜へ分岐する効果を外す。完全な DGM はこれらより良い探索曲線を示した。これは自己改変の再利用と候補集合の有用性を支持するが、異なるモデル・初期実装・予算の手法を並べた普遍的な順位ではない。(J. Zhang ほか 2026年, Sections 4.3–4.4)
親の現在の成績と子孫を生む能力を分ける
候補を残せても、親選択が現在の得点だけに依存すれば、将来有望な系譜を十分に試せない。現在の問題解決能力と、良い子孫を生み出す能力は一致するのか。この問いを正面から扱うのが、ICLR 2026 採択の Huxley-Gödel Machine(HGM)である。(Wang ほか 2026年)
HGM は、ある候補とその子孫からなる系統群を clade と呼び、その系統からどれだけ良い後続候補を得られるかを clade-level metaproductivity(CMP)として扱う。実際の探索では、未来のすべての子孫の成績を知ることはできない。そこで、既に得た子孫の成功・失敗を系統ごとに集約して推定を更新し、その不確実性も含めた Thompson sampling によって拡張する親を選ぶ。ここで「学ぶ」のは、新たなニューラルネットワークの重みではなく、観測した評価結果から更新する系統の有望度である。
さらに、候補の生成と候補の評価を切り離す。新しい実装を一つ作るたびに必ず固定数の問題を解かせるのではなく、次に自己改変を試すか、既存候補をもう一問評価するかを選択する。親選択では子孫を含む統計を、評価対象の選択では当該候補の統計を利用する。したがって HGM の新しさは「履歴を残すこと」だけではなく、将来の改善を生む親の推定と、評価予算の逐次配分を組み合わせることにある。(Wang ほか 2026年, Sections 2–3)
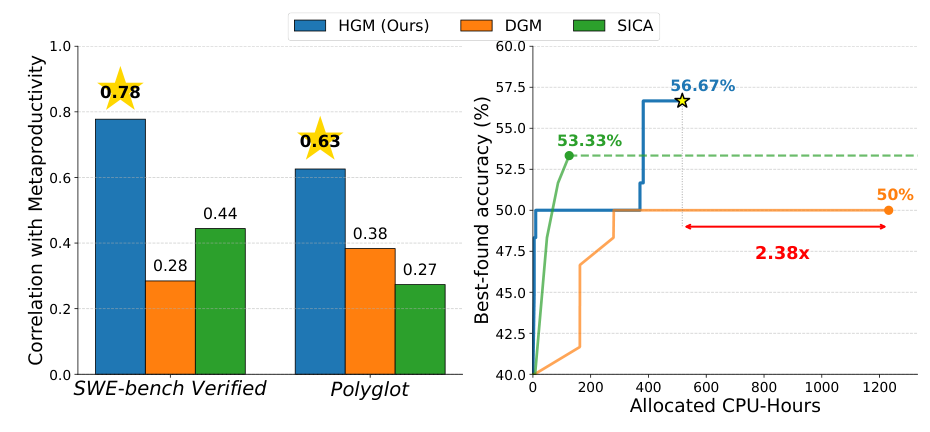
論文内の統制比較では、同じ初期エージェント、最大 800 回の問題単位の評価を使う。SWE-bench Verified の 60 問では、拡張に GPT-5、評価に GPT-5 mini を使用する。この条件で最終選択された候補の正答率は DGM が 53.3%、HGM が 56.7%、800 評価に要した割当 CPU 時間はそれぞれ 1,231 時間と 517 時間である。これは DGM 原論文の 80 反復実験とは別の比較であり、そのスコアを横に接続してはならない。また、HGM は推定法だけでなく非同期実行と評価配分も変えるため、この差を CMP 推定だけの効果とは読めない。(Wang ほか 2026年, Section 4.2 and Table 2)
図 4 の左では、現在の成績に基づく従来の指標より、HGMの指標のほうが長期的な改善能力と強く相関している。ただし、これは親選択の代理指標を検討する相関であり、個々の改変の因果効果ではない。右は原図で「Best-found accuracy」と記された曲線である。DGMとSICAの終点は上記のTable 2の値と一致しないため、両者を同一系列として数値比較しない。この違いの理由は本文から確認できない。
別の実験では、SWE-bench Verified 全体で探索した候補を SWE-bench Lite へ移す。Lite の 300 問には Verified と重なる 93 問があるため、論文は通常の集合と重複を除いた集合を分ける。GPT-5 mini での HGM の成績はそれぞれ 49.0% と 40.1% である。探索中の成績向上とは異なり、後者は未使用問題への移行を調べる結果である。両方を示すことで、候補の選び方と候補の汎化能力を別の問いとして扱える。(Wang ほか 2026年, Section 4.3.2 and Table 3)
一つの実装を進化させる代わりに役割の組を探す
コードやプロンプトを改良しても、一つのエージェントが位置特定、編集、検証の全履歴を持ち続ければ、不要な文脈が推論を妨げうる。別の方向は、仕事を専門的な副エージェントへ委任し、それらを統括するエージェントと組み合わせることである。ここでは「誰を親にするか」よりも、「誰と組ませたときに役立つか」という評価が必要になる。
ICLR 2026 採択の Bandit Optimization for Agent Design(BOAD)は、この階層を探索する。副エージェントを呼び出し可能なツールとして提示し、役割、入出力の説明、使用する指示を含む候補を生成する。各試行では候補集合から複数の副エージェントを選び、それらに合わせた統括役を構成してソフトウェア修正課題を実行する。評価される最終対象は副エージェント単体でなく、統括役と選ばれた副エージェントの組である。(Xu ほか 2026年, Section 4)
選択には多腕バンディットの Upper Confidence Bound(UCB)を使う。実測の有用度が高い候補を活用しつつ、まだ十分に試していない候補にも評価を割り当てる。また、候補集合は探索中にも拡張する。これは DGM の親子系譜に沿って実装を改変する探索とは異なり、再利用する副エージェントの集合と、その組合せを探す方法である。
チーム全体の成否だけを全員の得点にすると、役立たない候補が強い同僚に便乗して高得点になりうる。BOAD は実行軌跡を LLM の判定器に渡し、副エージェントが問題解決を前進させたかという二値の有用度を与える。最終的に失敗した軌跡でも、有用な中間成果には得点を与えられる。一方、この値は正解テストによる成功率ではなく、判定器が与える貢献の推定である。(Xu ほか 2026年, Section 4.2)
その区別を検証するのが 表 1 である。設計用には SWE-bench Verified の 12 問を使い、表の評価は SWE-bench Live の 300 問、実行モデルは Seed-OSS-36B-Instruct で行う。副エージェントなしの条件も 10 反復のプロンプト最適化を行っており、単なる未調整の初期値との比較ではない。(Xu ほか 2026年, Sections 5.1 and 5.3)
| 比べる要因 | 対照条件 | BOAD の条件 |
|---|---|---|
| 副エージェントの利用 | プロンプト最適化のみ: 16.3% | 副エージェントあり: 20.0% |
| 同じ副エージェントへの統括役の適合 | 汎用の統括指示: 16.7% | 候補に合わせた統括指示: 20.0% |
| 候補集合の拡張 | 固定集合: 17.0% | 探索中に拡張: 20.0% |
| 上位 2 候補を選ぶ指標 | チームの成功率: 15.3% | 軌跡上の有用度: 20.0% |
副エージェントを増やせばよいわけでもない。同じ論文では有用度上位 2 候補で 20.0% である一方、上位 5 候補では 13.7% となる。階層化の利点は人数ではなく、役割と統括の適合に依存する。ただし、これらは一つの設計設定から得た結果であり、あらゆるモデルで最適人数が 2 になることを意味しない。(Xu ほか 2026年, Table 3)
ハーネスの履歴参照・行動制約・局所修正
近年は、エージェントの周辺コードをまとめてハーネスと呼び、その編集を前面に出す研究もある。ここでは Meta-Harness、AutoHarness、Self-Harness を、採択済み研究を補うプレプリントとして扱う。共通するのはモデルの重みを更新せず、モデルと環境の間に置くコードを変える点であるが、編集の入口は異なる。
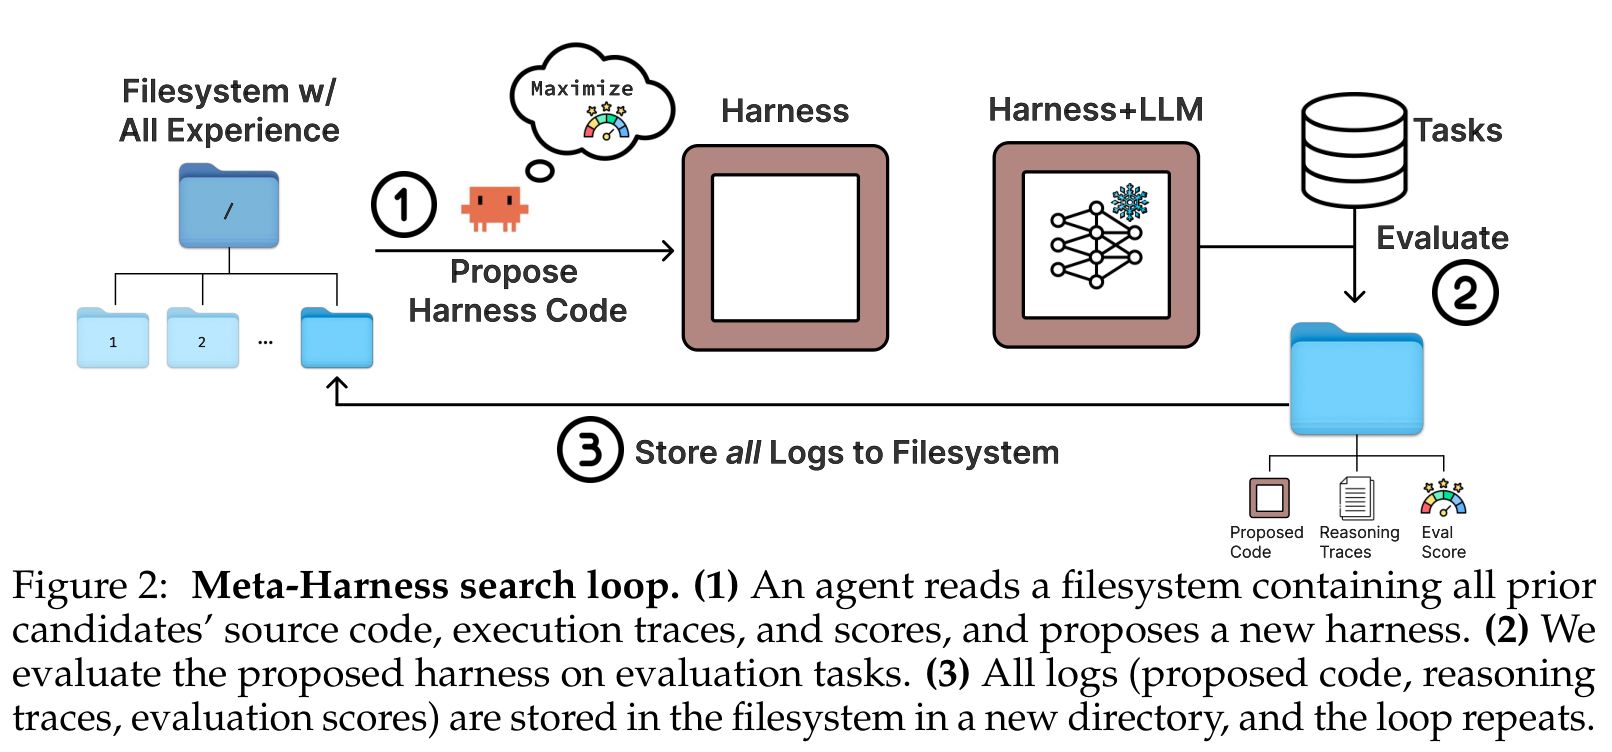
Meta-Harness では、提案エージェントがファイルシステムを通じて過去候補のソースコード、スコア、実行軌跡を参照する。過去の経験を短い反省文だけに圧縮せず、必要な記録を調べて次の変更を作る点が特徴である。ADAS の候補集合との比較では、過去候補を残すか否かだけでなく、どれだけ詳細な証拠へ、どのようにアクセスできるかが比較軸になる。(Lee ほか 2026年)
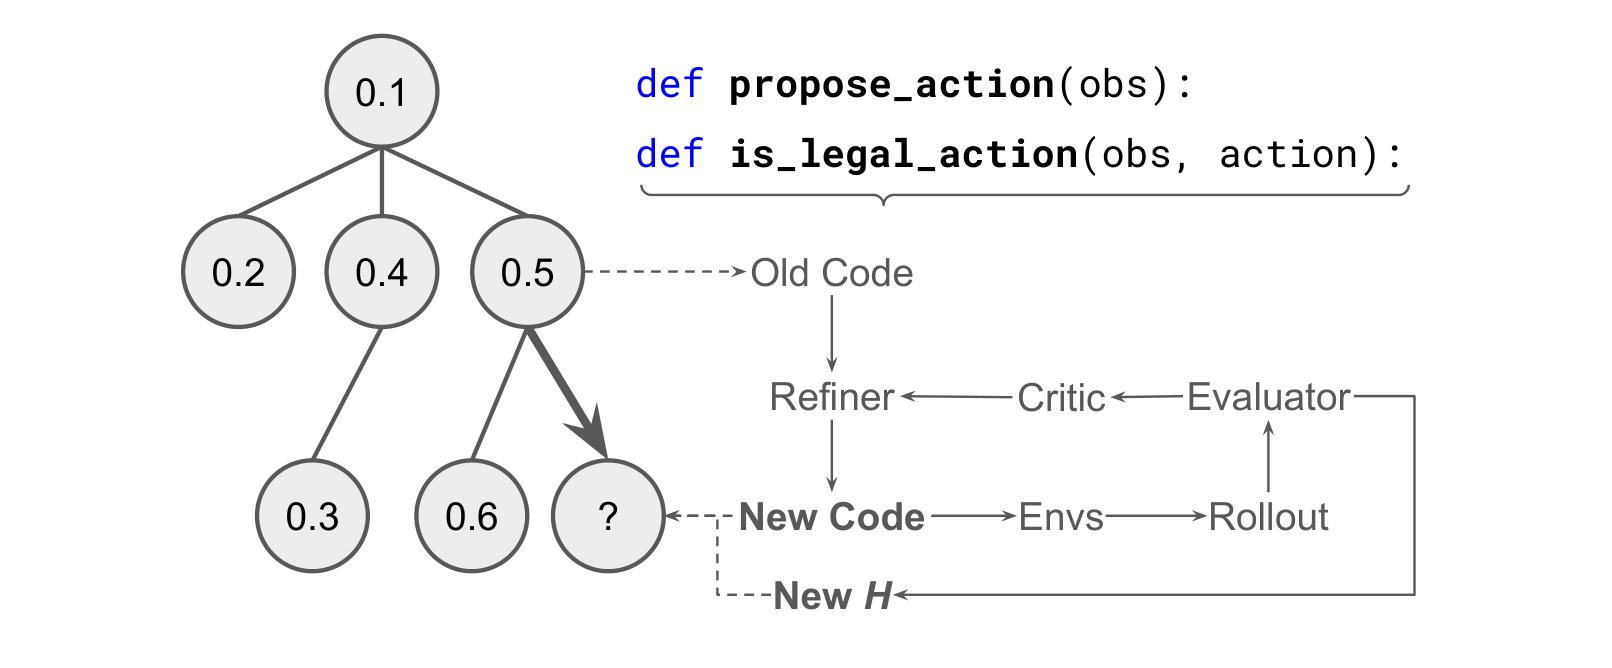
AutoHarness は、ゲーム環境からのフィードバックを使い、禁止された行動を防ぐコードを合成する。さらに、補助的な検査だけでなく行動方策全体をコード化する設定も扱う。前者は LLM が出す行動を周辺コードで制約するが、後者では意思決定時に LLM を呼ばなくなる。どちらもコード生成ではあるものの、同じ「LLM エージェントの実装改善」として一括するより、実行時に残る LLM の役割まで区別すべきである。(Lou ほか 2026年)
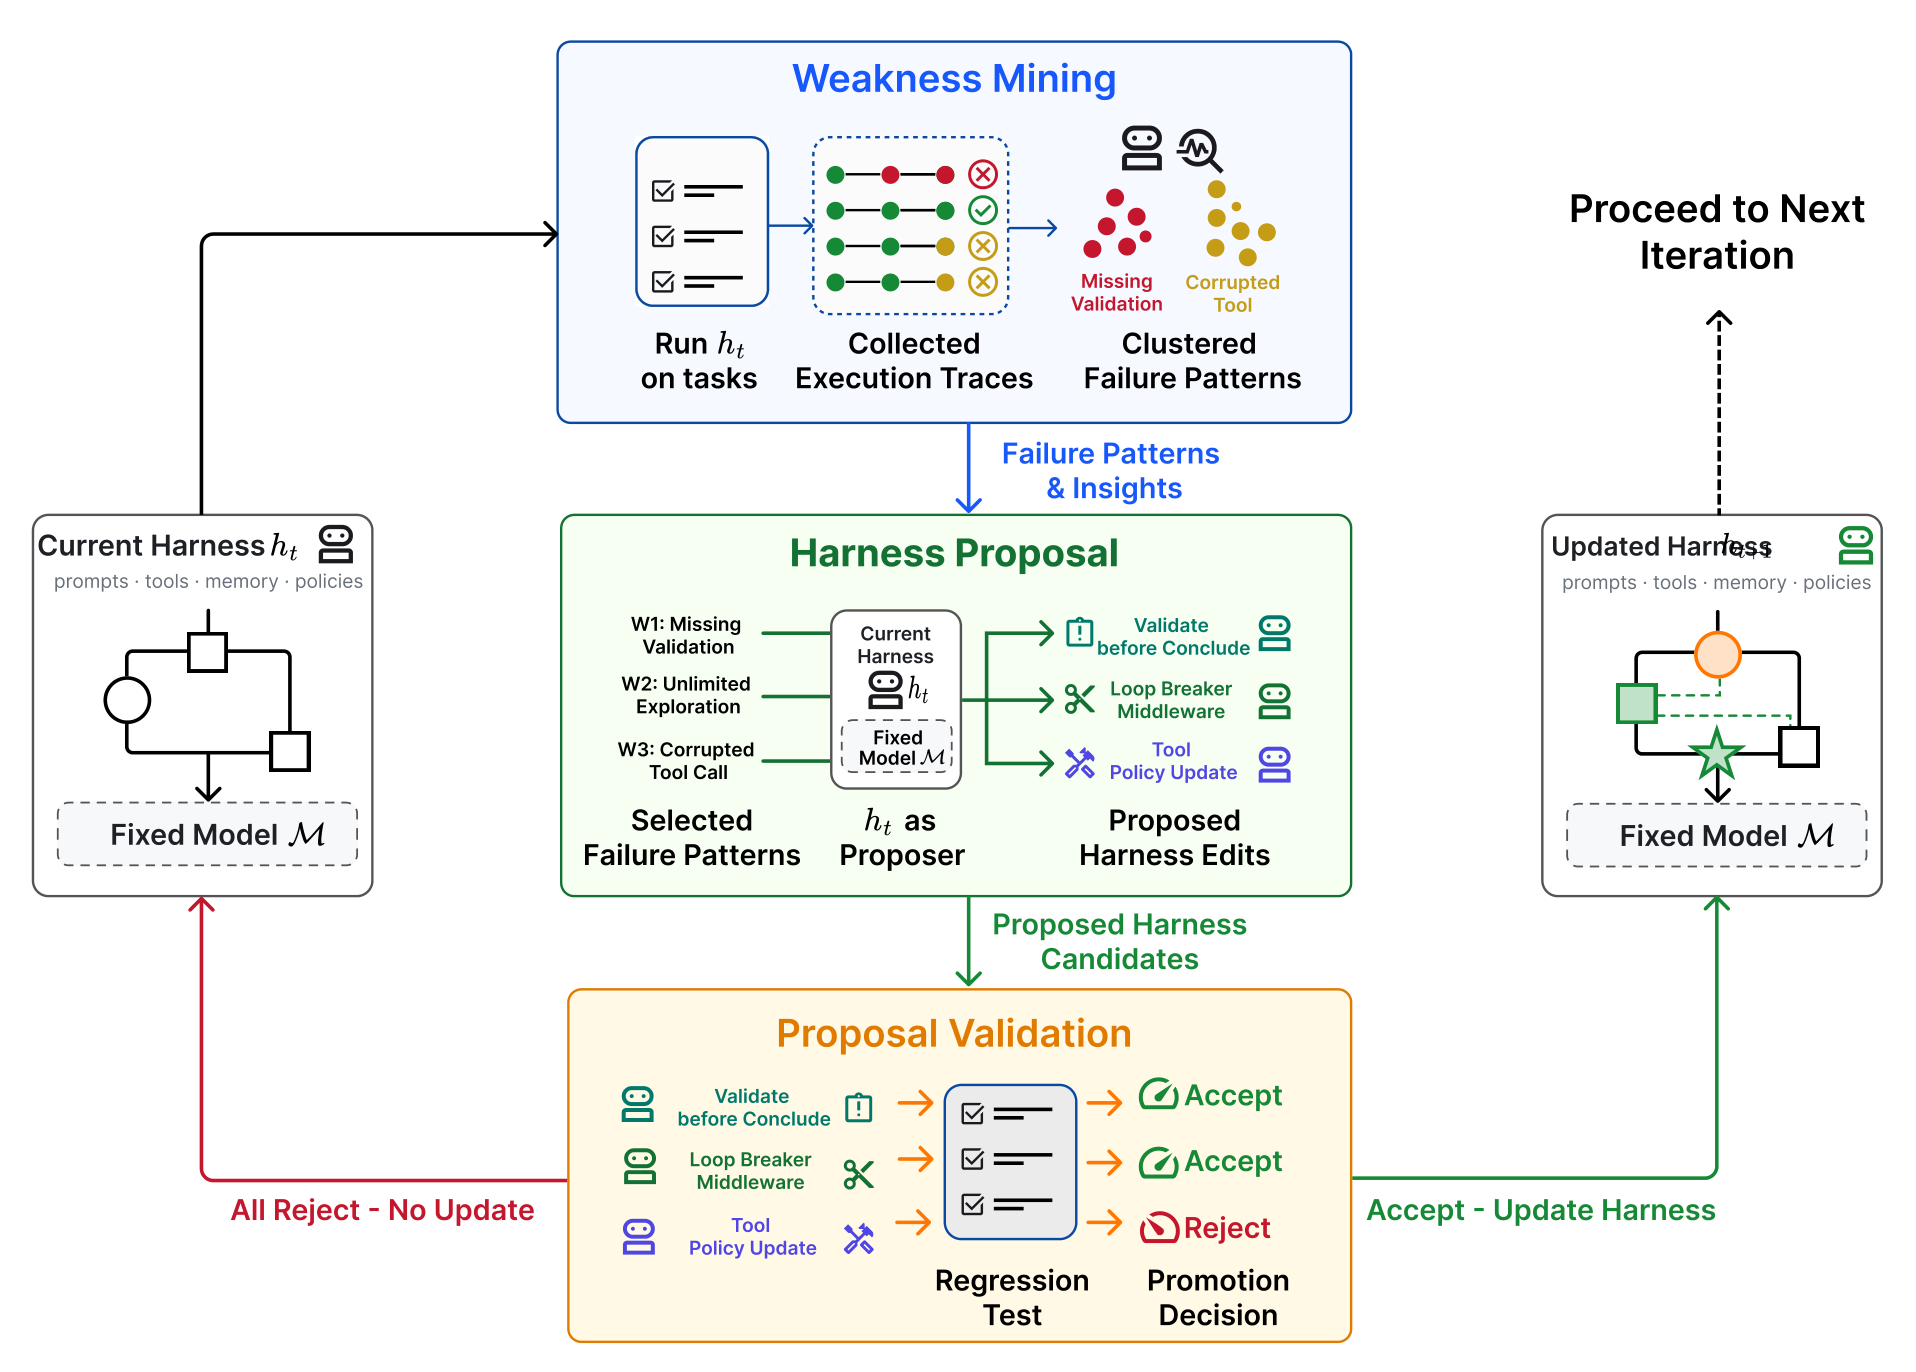
Self-Harness は、実行軌跡からモデル固有の弱点を抽出し、その弱点に対応する小さな変更案を生成し、回帰試験で検証する。外部のより強い設計エージェントを必須とせず、対象エージェント自身が周辺実装を改善する点を重視する。これは DGM の広い実装探索と接点を持つが、失敗パターンと最小限の変更を対応づける編集の単位を明示している。(H. Zhang ほか 2026年)
これらの結果を、異なるベンチマークの最大改善率で並べても、どの探索法が優れるかは分からない。ハーネスと最適化器の評価で扱うように、同じ編集権限と予算での比較、候補選択に使わない評価、探索費用と実行費用の分離が必要になる。
本章の研究が残す中心的な問いは、今よく解ける実装を選ぶことと、将来よい実装を生む出発点を選ぶことを、どう両立させるかである。関数の段階的更新、過去の実装を残す候補集合、子孫の有望度の推定、役割ごとの貢献評価は、この問いに対する異なる答えである。変更範囲を広げるだけでなく、その範囲に合った探索単位と評価単位を設けることが、コードの自動生成を検証可能な改善へ変える。
図版クレジット
Figure 2: (S. Zhang ほか 2024年)。原図公刊版、Figure 2。© 著者。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 1: (Hu ほか 2025年)。原図公刊版、Figure 1。© 著者。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 3: (J. Zhang ほか 2026年)。原図公刊版、Figure 3。CC BY 4.0。原図の二つのパネルを結合・ラスタライズし、余白を切り抜き。
Figure 1: (Wang ほか 2026年)。原図公刊版、Figure 1。© 著者。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (Lee ほか 2026年)。原図プレプリント、Figure 2(arXiv 2603.28052v1)。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 1: (Lou ほか 2026年)。原図プレプリント、Figure 1(arXiv 2603.03329v1)。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (H. Zhang ほか 2026年)。原図プレプリント、Figure 2(arXiv 2606.09498v3)。CC BY 4.0。原図を切り抜き・ラスタライズ。