ハーネスと最適化器の評価
候補の得点が上がったという結果だけでは、最適化器が改善の理由を理解したのか、多くの候補を試して当たりを引いたのかは分からない。また、実行エラーを修正しても、正解数が増えるとは限らない。本章では、具体的な比較を通じて、ハーネス最適化の実験が何を測っているかを整理する。
エラーを減らすことと、課題を解くこと
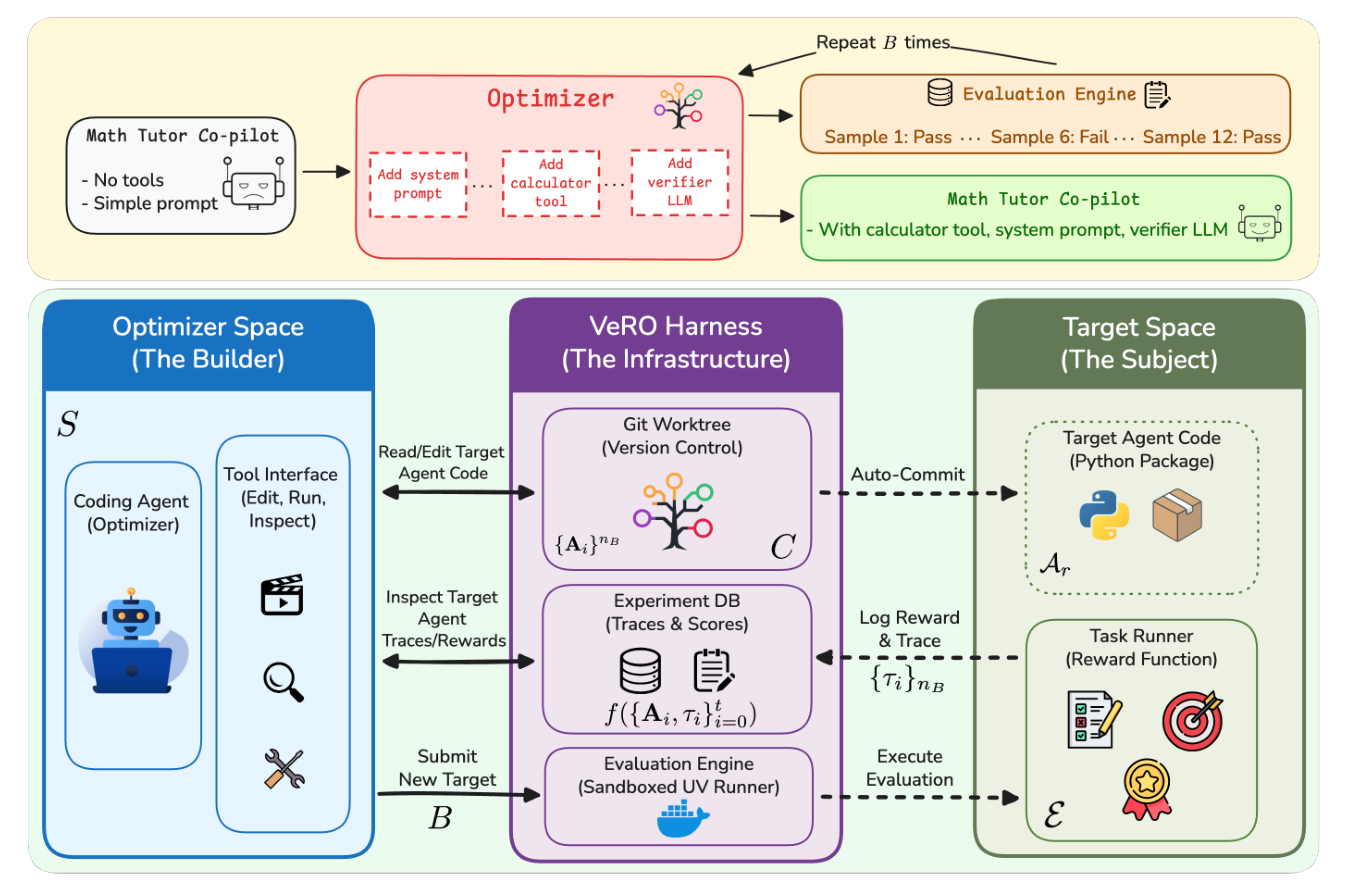
VeROは、コーディングエージェントが別のエージェントの実装を変更する能力を評価する枠組みである。対象エージェントの版、評価予算、実行記録を管理する外側のハーネスと、複数の課題を含むVeRO-Benchを提供する。ICML 2026の採択論文であり、特定の最適化アルゴリズム一つを提案する研究ではない (Ursekar, Shanker, Chatrath, ほか 2026年)。
図 1 の左は変更を作るエージェント、右は変更される対象、中央は実行と記録を管理する仕組みである。上段の例では、計算機や検証器を追加する候補を試す。候補生成器の出力だけでなく、それを測る実行環境まで含めて最適化器を比較する必要がある。
同論文は、Terminus-KIRAとClaude Haiku 4.5を使う対象エージェントを、Claude CodeのSonnet 4.5で改善する事例を報告する。TerminalBench-2の89課題すべてを最適化に用い、同じ89課題の成績を測る。したがって、これは未知課題への汎化ではなく、観測済み課題でどのような改善が起きるかを調べる事例である (Ursekar, Shanker, Chatrath, ほか 2026年, sec. 4.4, Table 4)。
| 設定 | 課題実行予算の上限 | 実際の使用回数 | 成功率 | クラッシュ・タイムアウト率 |
|---|---|---|---|---|
| 初期エージェント | - | - | 30.3% | 46.1% |
| 専用ツールから記録を読む | 89 | 89 | 33.7% | 36.0% |
| ファイルから記録を読む | 178 | 178 | 30.3% | 30.3% |
| 専用ツールから記録を読む | 178 | 129 | 37.1% | 33.7% |
数値は著者報告である。予算の上限はこの事例で許される対象課題の実行回数であり、一般の全API呼び出し数ではない。同じ上限178でも実際の使用回数は異なるため、消費した評価量を一致させた比較ではない (Ursekar, Shanker, Chatrath, ほか 2026年, Appendix A.4, Table 15)。非成功には、エラーで終了する場合と、実行は完了したが正解判定に通らない場合がある。
注目すべきなのは、ファイルを使う設定である。クラッシュ等は減るが、成功率は初期値と同じである。専用ツールを使う予算89の実行と、このファイルを使う実行は、型判定の不具合をそれぞれ発見した。一方、予算178の専用ツール実行は、その修正を採用せず、トークン圧縮など別の変更で最高の成功率に達した。この実行群では、その不具合の修正だけで成功率が高まるとは限らず、別の変更からも改善が得られた (Ursekar, Shanker, Chatrath, ほか 2026年, sec. 5.4)。
さらに、各設定は一回の最適化実行である。インターフェースだけの効果を同定する対照実験ではなく、「ツール経由ならファイル経由より優れる」という結論にはできない。ここで確かめられるのは、成功率と実行エラーが異なる変化を捉えること、異なる修正の組合せで同じ総合得点になり得ることである。
探索で見た入力と、見ていない入力
VeROの主実験は、上の89課題の事例とは別に、編集範囲を揃えた最適化器比較を含む。対象はGPT-4.1 mini、最適化器はSonnet 4.5で、5課題それぞれについて予算B=8、最適化実行N=3回である。同じ部品を変更できるGEPAとResources Onlyの集約された平均最良得点は、ともに0.54だった。Defaultは0.61だが、より広い範囲の変更を許すため、この差を探索アルゴリズムだけの効果とは解釈できない。この予算設定は、前節の89回・178回の課題実行上限とは区別する必要がある (Ursekar, Shanker, Chatrath, ほか 2026年, sec. 4.1, §5.1, Table 2)。
VeROの主たるベンチマーク実験には、訓練・検証・テストを分ける課題もある。一方、GAIAでは公開の検証集合を保留評価に使い、GPQAでは訓練集合上で版を選んだうえで別のテスト集合を評価する。すべての課題が同一の三分割ではない。表の列名だけでなく、候補生成と選択が何を見たかを読む必要がある (Ursekar, Shanker, Chatrath, ほか 2026年, Table 1, Appendix A.2.1)。
たとえば、候補の生成に使わなかった問題でも、毎回その成績を読んで次の候補を選んでいれば、探索に使っている。一般的なモデル選択と同じく、多くの候補から最大値を選ぶと、偶然の高得点も選びやすくなる。CawleyとTalbotは、モデル選択段階での過適合が比較評価を歪める問題を論じている。Ladderは、繰り返し提出される順位表の情報公開を制御する別の対処法である (Cawley と Talbot 2010年; Blum と Hardt 2015年)。
ここで区別すべきなのは、同じ入力を見て適応すること、同じ分布の別入力で評価すること、別の課題系統へ転用することである。同じベンチマーク分布の訓練データを使うだけで、直ちにテストを見たことにはならない。逆に、対象モデルを変えても問題が同じなら、未知課題への汎化を測ったことにはならない。
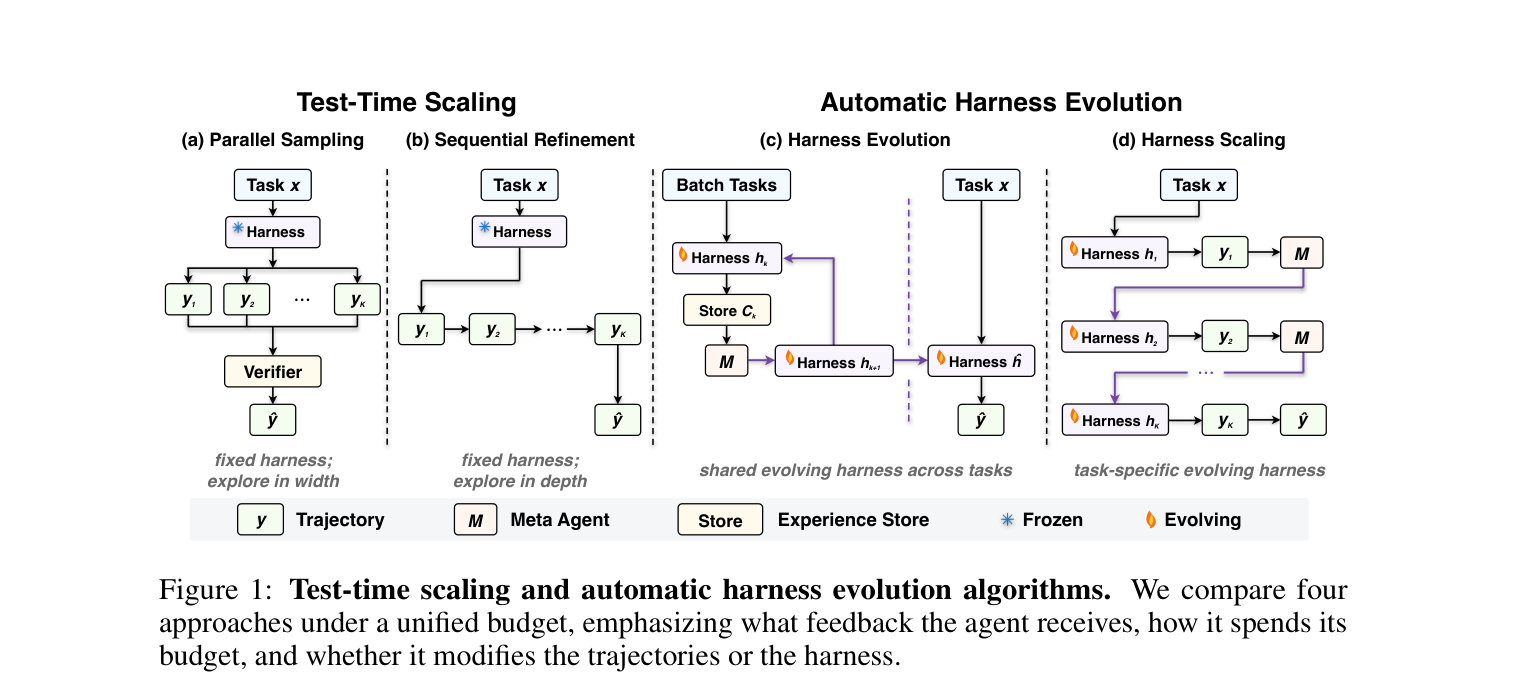
2026年のプレプリントRethinking the Evaluation of Harness Evolutionは、ハーネス探索と、各課題に推論予算を追加する単純な探索を、フィードバックと予算を合わせて比較する。Terminal-Bench 2.1では後者を上回らず汎化も限定的だった一方、長期ゲームではハーネス探索が有利な設定を報告する。これはハーネス最適化全体を否定する結果ではない。比較対象と課題の性質によって、外側の探索に予算を使う価値が変わることを示す研究として読む (Y. Wang ほか 2026年)。
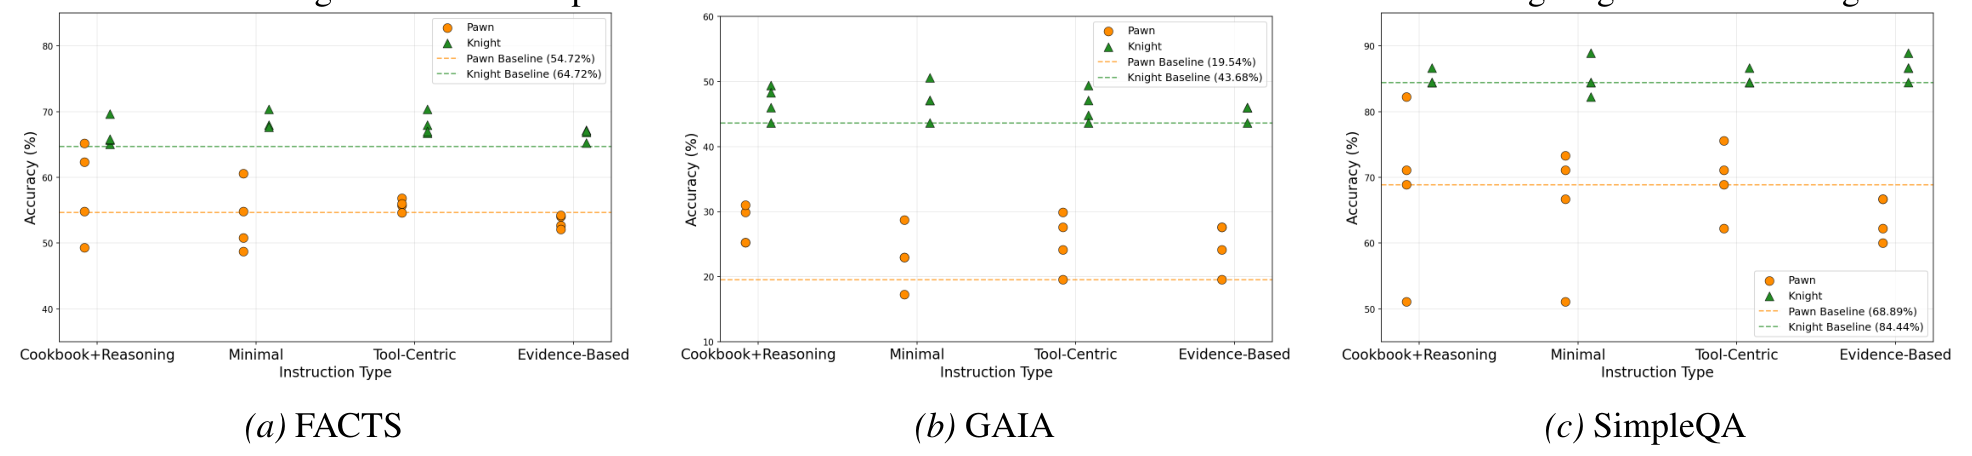
VeROの対象モデルを変更する実験でも、同系列のモデルへ残る改善と、別系列で失われる改善がある。また、初期エージェントの機能が少ない場合と既に充実している場合で、有効な最適化器向け指示が異なる。対象モデル名だけでなく、初期ハーネスが残す改善余地も比較条件である (Ursekar, Shanker, Chatrath, ほか 2026年, sec. 5.2–5.3, Table 3)。
候補を作る能力と、選ぶ能力
最適化器全体の結果は、候補の質だけで決まらない。よい候補が生成されても、評価の雑音や代理指標によって捨てられることがある。反対に、単純な生成器でも、多くの候補から適切に選べば高い成績に達し得る。
Agentic Predictorは、すべてのワークフロー候補を実行する代わりに、コード、プロンプト、相互作用グラフ、課題の表現から性能を予測する。ICLR 2026の論文で、予測器を使って高価な評価を減らす問題を扱う (Trirat ほか 2026年)。
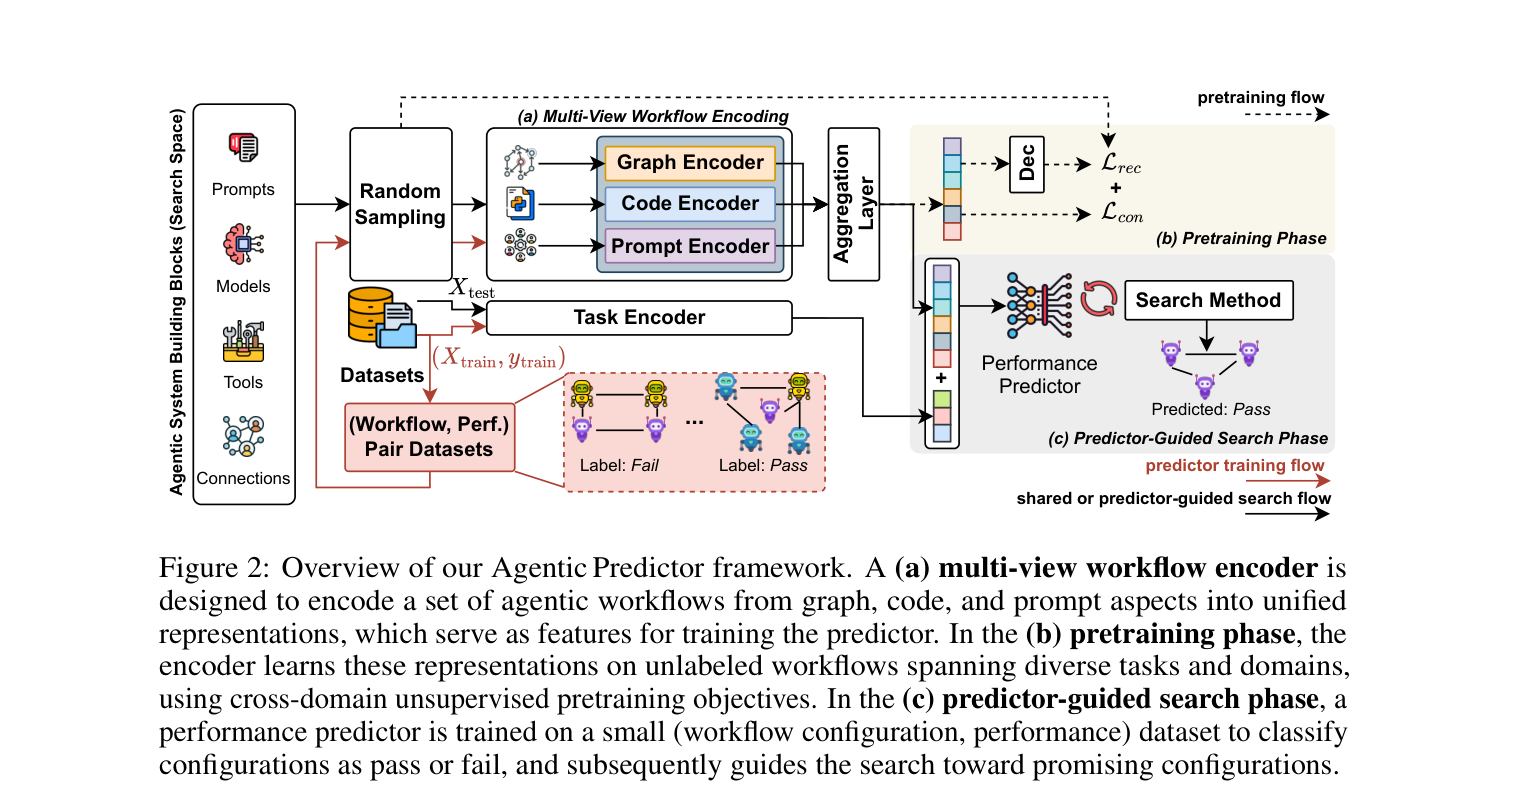
同論文のTable 3は、成功・失敗の予測精度と、実際の上位候補をどの程度選び出せるかを別々に測る。後者のutilityは、予測した上位\(k\)候補と真の上位\(k\)候補の集合の重なりである。全体の平均値79.97と76.33は、それぞれ異なる指標であり、どちらもエージェントが利用者の課題を解いた成功率そのものではない (Trirat ほか 2026年, sec. 4.1, Table 3)。
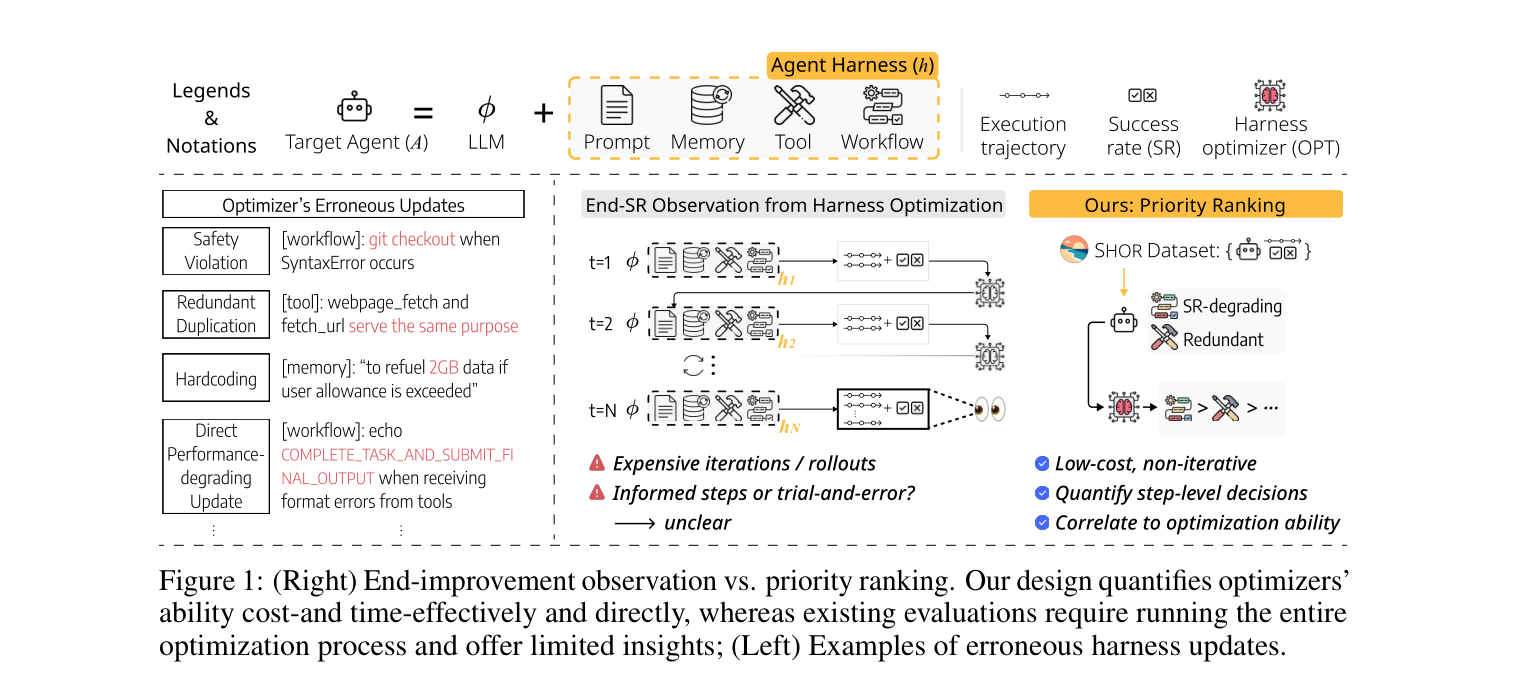
評価する対象がさらに異なるのがPriority Rankingである。改善・悪化を引き起こしそうな構成要素を順位付けさせ、182件の人手確認済みシナリオから、どこを変更すべきかの判断を測る。著者は実際の多段階最適化能力との相関を報告する。ただし、順位付けがよいことだけで、正しいコードを書けることや探索予算を効率よく使えることは保証されない。著者はNeurIPS 2026本会議採択を報告しているが、ここでは公式掲載先による確認とは区別する (Ong ほか 2026年)。
図 5 の対比は、構成要素の順位付けが途中の判断を診断する一方、完成したエージェントの評価を代替しないことを示す。
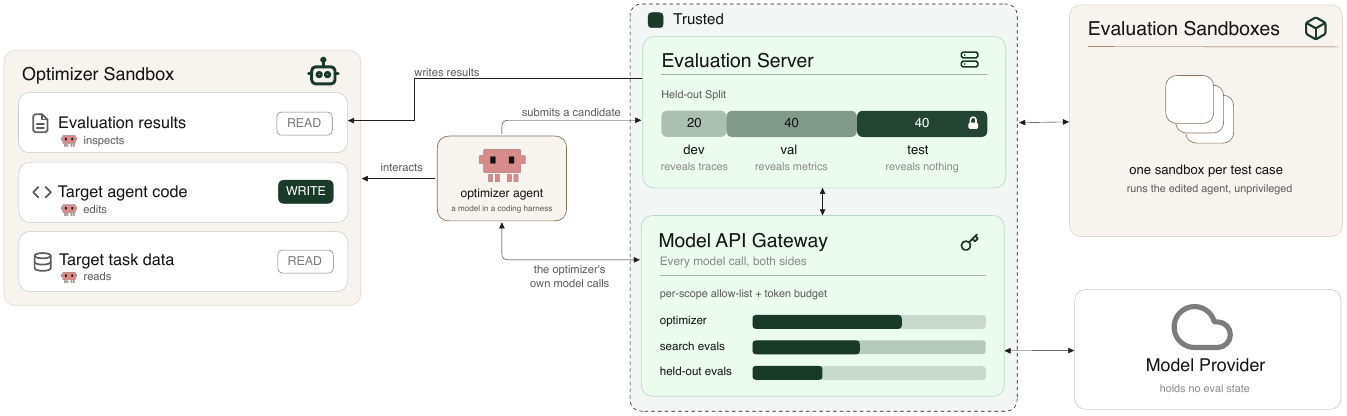
HarnessOpt-Benchは、対象エージェントのコードを編集する最適化器を、別に保持された隠しテストと制御された予算で測る2026年のプレプリントである。Priority Rankingが途中の判断を安く診断するのに対し、こちらは生成・評価・選択を含む最終的な改善を測る。どちらか一方で他方を置き換えるのではなく、全体成績と段階別の診断は異なる問いに答える (Ursekar, Shanker, Maurya, ほか 2026年)。
一度の改善は、次の改善につながるか
保存したハーネスが、別の入力や別のモデルでも使えることは、さらに改善を繰り返せることと同じではない。新しい課題を加えたとき、最初の改善が残るか、二回目の探索に追加の価値があるかが問題になる。
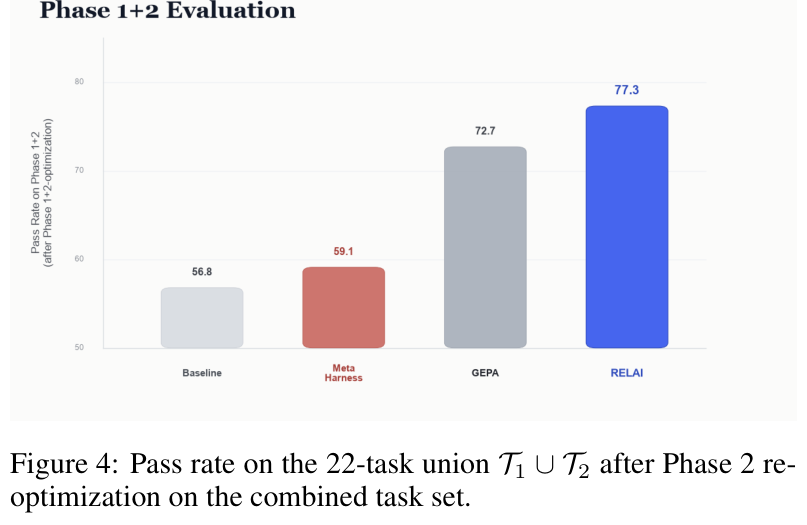
Do Agent Optimizers Compound?は、Terminal-Bench 2.0の二段階の課題導入でGEPA、Meta-Harness、RELAI-VCLを比較する技術報告である。初回だけならいずれも改善するが、新しい課題への転用と二回目の改善では結果が分かれると報告する。これはRELAIによる自社方式を含む比較であり、査読済みの独立追試や一般的な順位とは区別する。重要なのは、単発の改善と継続的な改善が異なる評価対象になっている点である (W. Wang ほか 2026年)。
図 7 の最終値は二回目の最適化後を測るもので、再最適化前の転用だけの評価ではないため、段階別の分析と併せて読む必要がある。
Harness Updating Is Not Harness Benefitは、更新を作るモデルと、その更新を使って課題を解くモデルを分けて評価するプレプリントである。高性能な対象モデルほど、よい更新を作るとも、その更新から大きく利益を得るとも限らないと報告する。更新されたスキルを呼び出せない場合と、呼び出しても従えない場合を分ける点は、単一の最終得点では見えない (Lin ほか 2026年)。
図 8 の別々のパネルは更新を作る能力と利用して利益を得る能力を分け、失敗図は読込み自体の失敗と読込み後の誤実行を区別する。
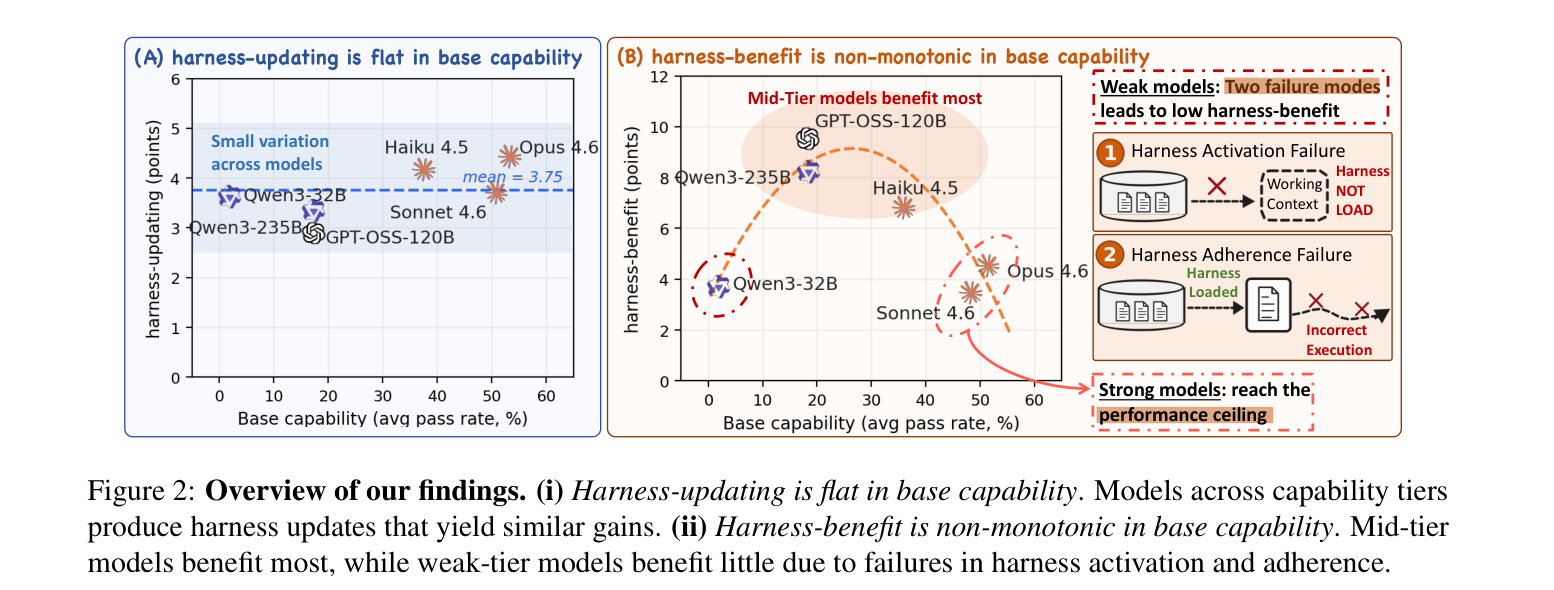
これらの結果は、最適化器のモデル規模だけで能力を並べることの限界を示す。最適化器、生成されたハーネス、それを使う対象モデルの三者を分ける必要がある。ただし、最近のプレプリントで見られた傾向を、異なる課題や実装まで一律に一般化することはできない。
費用と環境の変化を含めて測る
探索中の費用と、完成したハーネスを使う費用は異なる。数百回の探索を経て短い指示を一つ得る場合、利用時の追加費用は小さくても、作成費用は残る。逆に、複雑な投票や検証を組み込む候補では、探索が終わっても毎回の呼び出しが増える。同じロールアウト数でも、途中のモデル呼び出し、ツール、トークン数は等しくない。
さらに、実行環境が変われば、良い指示があっても同じ性能にはならない。ResiliBenchは、30種類のAPIをモデル化した5,040課題で、ツールの確率的失敗とワークフロー指示の誤りを制御するICLR 2026のベンチマークである。著者が報告する平均の完全成功率は、MDPから導いたワークフロー指示で62.1%、Chain-of-Thought指示で50.8%、誤りを注入したワークフロー指示で54.3%である (Ao ほか 2026年, Tables 2–3)。
図 9 の順序の誤りは、不適切な指示からの回復を具体化し、初期計画の品質だけでなく実行と再計画を測る理由を示す。
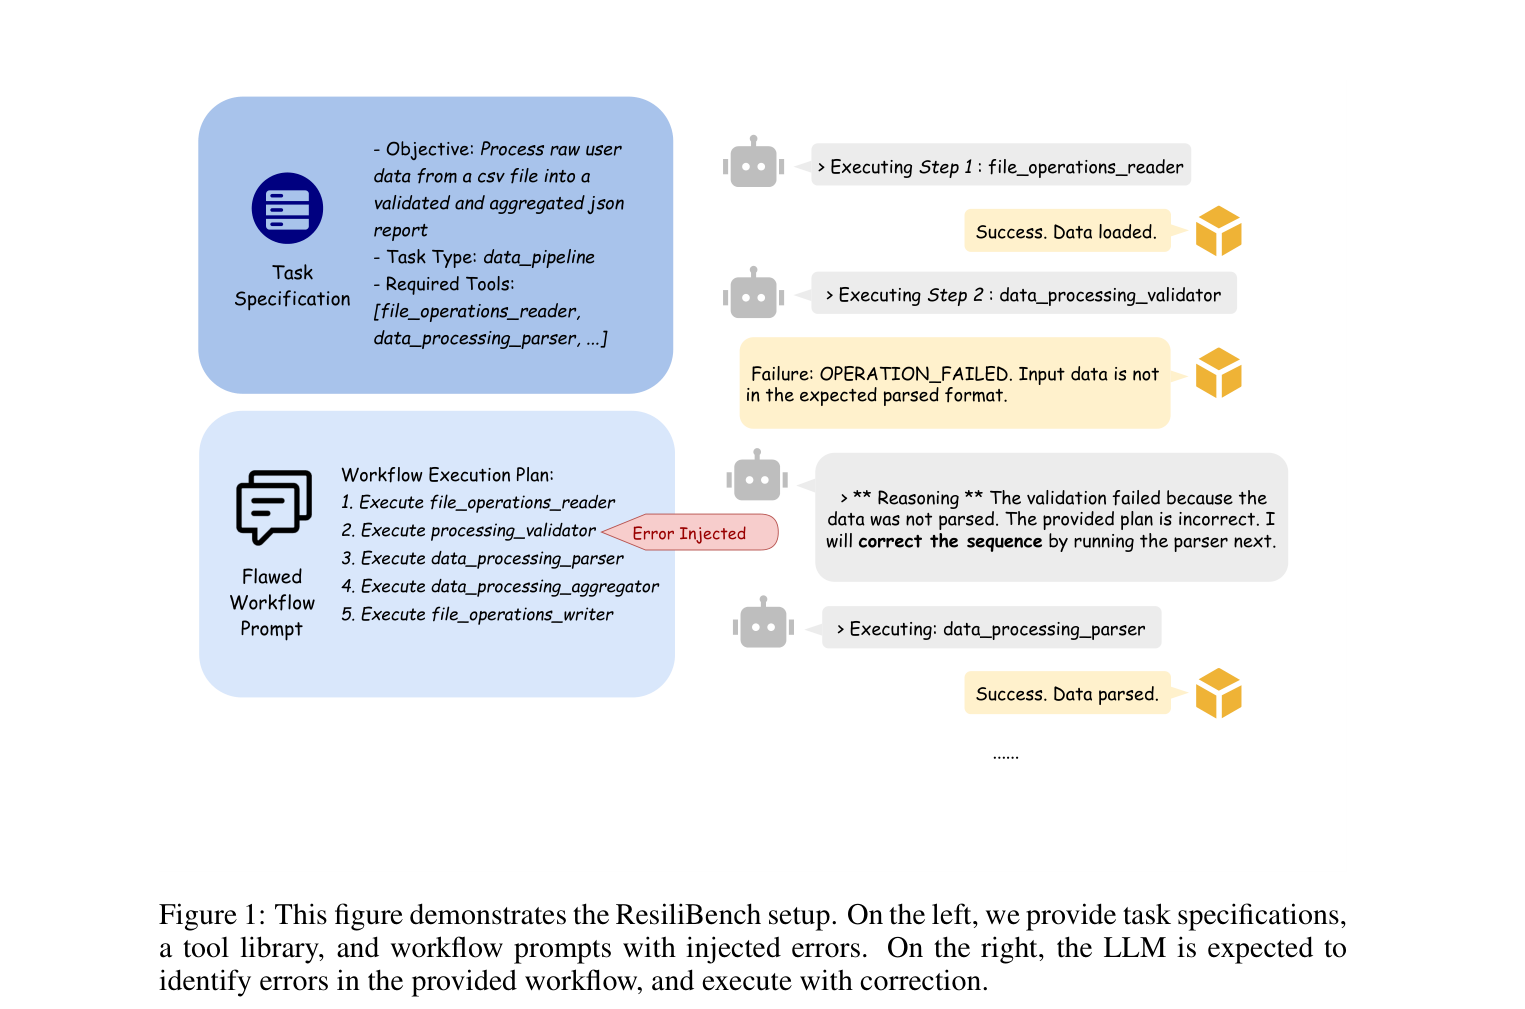
MDPは、状態と行動によって次の状態と報酬が決まる確率モデルである。ここで比較に使うのは、著者がMDP-optimalと呼ぶPPO学習方策の参照構成である。Transformer方策を近接方策最適化(Proximal Policy Optimization, PPO)とカリキュラム学習で訓練しており、モデル化したMDP内でも大域的最適性の証明は示されていない。「最適」は参照構成の名称として読み、実世界の任意のツールや、任意のハーネス最適化器に対する上限とは解釈しない (Ao ほか 2026年, sec. 3.3)。また、ResiliBenchは主としてワークフローを実行・修正する能力を測り、すべての候補生成器を直接比較した研究ではない。
入力表現や評価器も、測定する環境の一部である。Sclarらはプロンプトの意味を保った書式の違いでも性能が変わることを分析する。PanicksseryらはLLM評価器が自分の生成物を識別し好む傾向を報告する。最適化によって評価器への適合が進む可能性は、報酬モデルの過剰最適化を論じた研究とも関係するが、それだけで特定のハーネスの改善が不正だと示したことにはならない (Sclar ほか 2024年; Panickssery ほか 2024年; Gao ほか 2023年)。
安全性も成功率から自動的には分からない。AgentDojoは、外部のツール出力に含まれる悪意ある指示によって、エージェントが課題から逸脱するかを測る。コードを隔離環境で動かすことと、プロンプト注入に従わないことは異なる性質である。ハーネスの変更が一方を改善しても、もう一方まで保証するわけではない (Debenedetti ほか 2024年)。
改善の根拠と最適化機構の追加価値
指示、構造、コード、経験のいずれについても、評価に基づく変更が有効な設定はある。一方、その改善の意味は、何を見て選んだか、何を固定したか、何を未使用にしたかによって変わる。
現時点で強い根拠になるのは、同じ条件の中で機構の一部を変える比較と、具体的な変更に対応する実行結果である。完成したエージェントの高得点だけから、候補生成、選択、汎化、継続的改善のすべてが優れているとは言えない。今後の課題は、一律の配備手順を決めることではなく、どの課題・対象モデル・予算で、どの最適化機構に追加の価値があるかを分離して示すことである。
図版クレジット
Figure 1: (Ursekar, Shanker, Chatrath, ほか 2026年)。原図公刊版、Figure 1。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 1: (Y. Wang ほか 2026年)。原図プレプリント、Figure 1(arXiv 2607.12227v4)。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (Ursekar, Shanker, Chatrath, ほか 2026年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (Trirat ほか 2026年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 1: (Ursekar, Shanker, Maurya, ほか 2026年)。原図プレプリント、Figure 1。CC BY 4.0。原図をラスタライズ。
Figure 1: (Ong ほか 2026年). 原図: 出典PDF、Figure 1。図の内容を変更せず図領域をラスタライズ。 CC BY-NC-ND 4.0.
Figure 4: (W. Wang ほか 2026年). 原図: 出典PDF、Figure 4。図の内容を変更せず図領域をラスタライズ。
Figure 2: (Lin ほか 2026年). 原図: 出典PDF、Figure 2。図の内容を変更せず図領域をラスタライズ。
Figure 1: (Ao ほか 2026年). 原図: 出典PDF、Figure 1。図の内容を変更せず図領域をラスタライズ。