プロンプト最適化
算数の文章題を解くモデルに、どの一文を添えるべきであろうか。OPRO の実験では、事前学習版 PaLM 2-L に対する「Let’s think step by step.」の GSM8K テスト正解率は 71.8% であった。これに対し、PaLM 2-L-IT を最適化器として探索した「Take a deep breath and work on this problem step-by-step.」では 80.2% であった。変わったのはモデルの重みではなく、回答の冒頭に与える指示である。この差は著者らが同じ課題モデルで測定したものである (Yang ほか 2024年, Table 1)。
この比較から「深呼吸」という語だけの効果を取り出すことはできない。探索では多数の候補を生成し、実際に問題を解かせ、得点を見て次の候補を作っている。読みやすい修正文を一つ提案することと、未知の問題にも有効なプロンプトを選ぶことは別である。本章では、何を候補として作り、どの情報で修正し、どこに評価予算を配るかという観点から、プロンプト探索の仕組みを比較する。
候補を作るだけでは最適化にならない
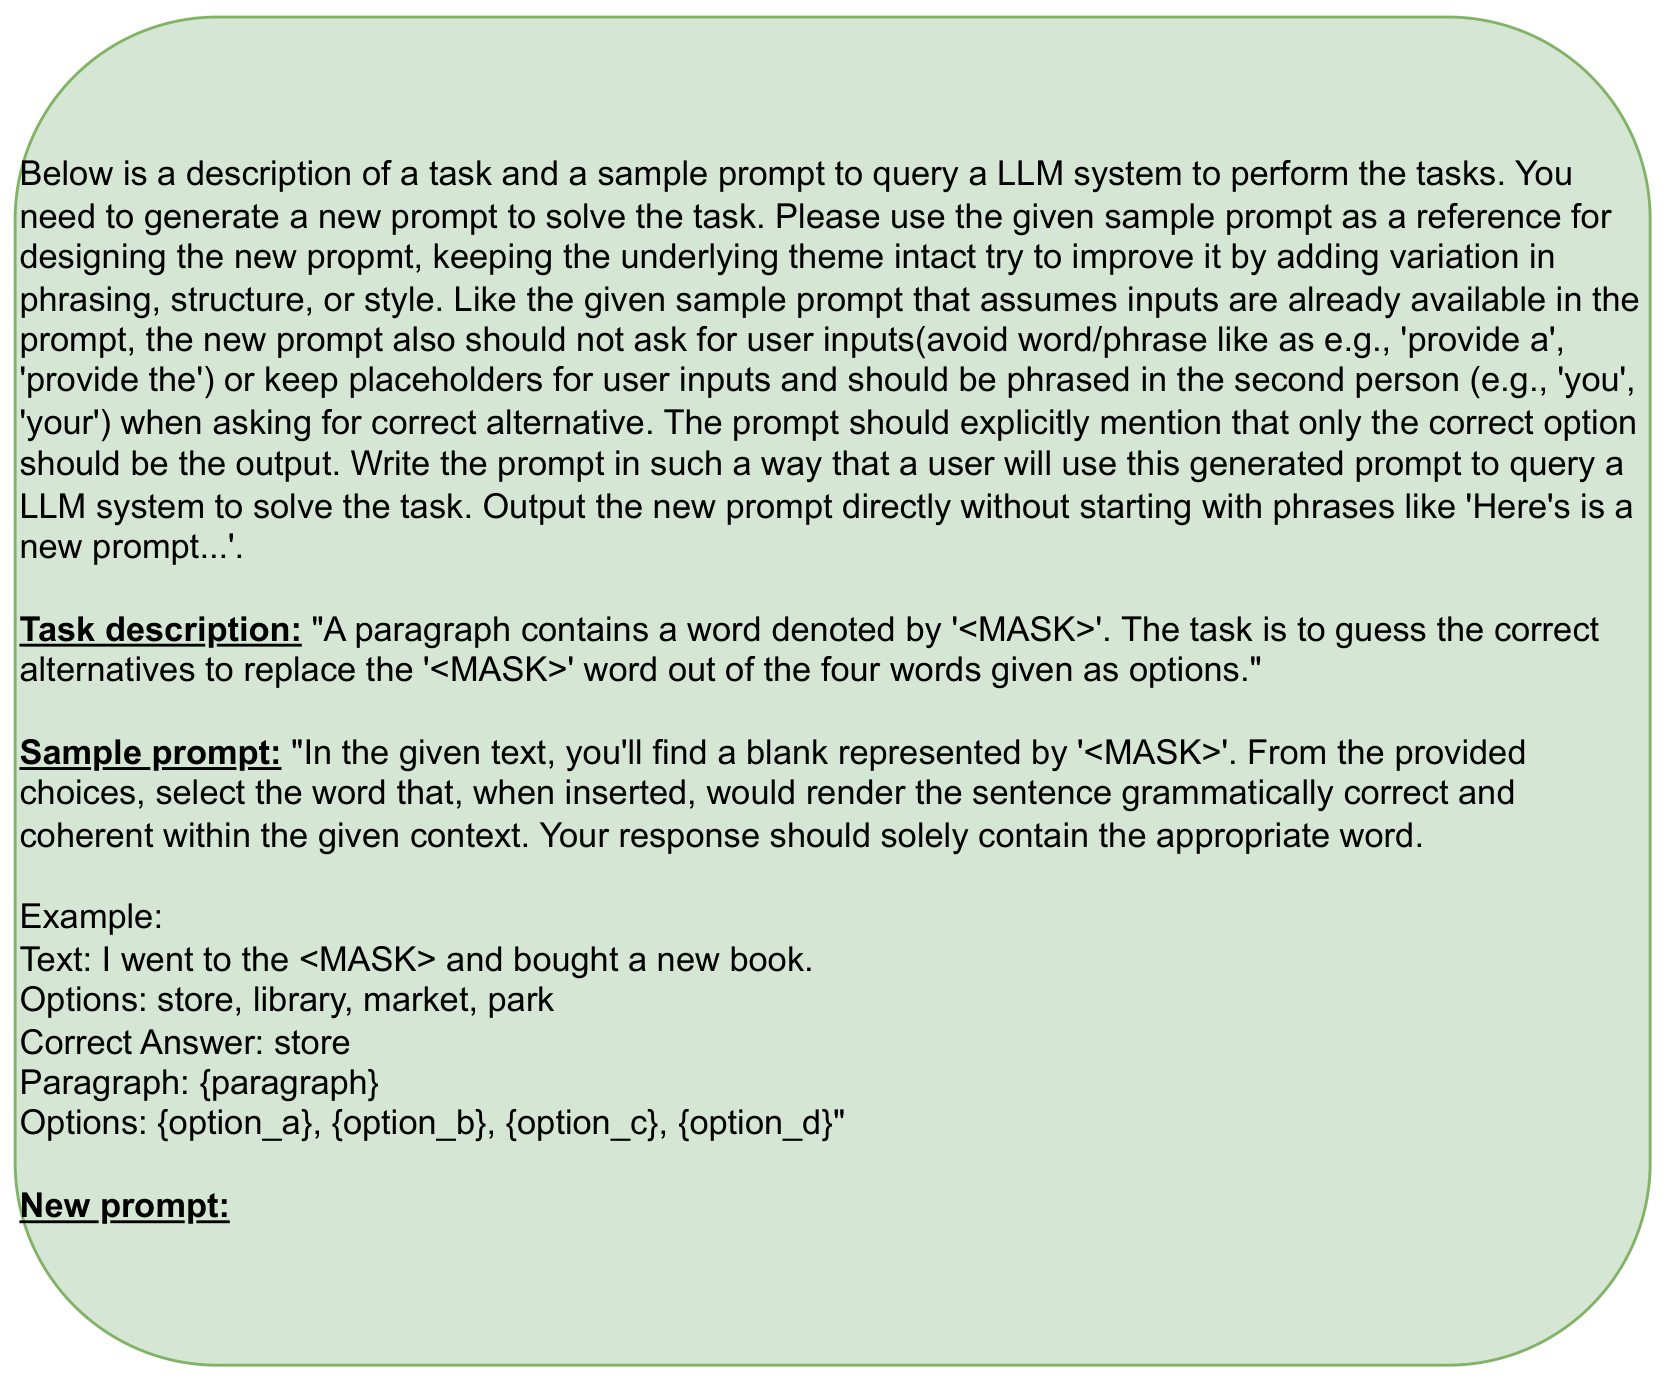
プロンプト最適化とは、固定した課題モデルに与える指示や例示を変え、評価結果に基づいて候補を選ぶ処理である。大規模言語モデル(Large Language Model, LLM)が文章を書き換える場合でも、生成器は最適化器の一部にすぎない。候補を測る評価器、探索履歴を保持する仕組み、候補を残す選択規則が必要になる。
OPRO(Optimization by PROmpting)は、過去の指示と得点を最適化用のプロンプトに並べ、それらを参考に新しい指示を生成させる。標準設定では、各段階で 8 候補を生成し、履歴から上位 20 指示と、訓練データから無作為に選んだ 3 問を提示する。GSM8K では訓練集合の 3.5% を固定して候補を評価し、最後にテスト集合全体で測る。生成には多様性を持たせ、候補の採点時には貪欲復号を使う。冒頭の一文は、この履歴を用いる探索から得られた候補である (Yang ほか 2024年, Sections 4–5)。
図 1 では、過去の指示と得点を課題例とは別に与えるため、履歴から次の候補を提案する仕組みが分かる。
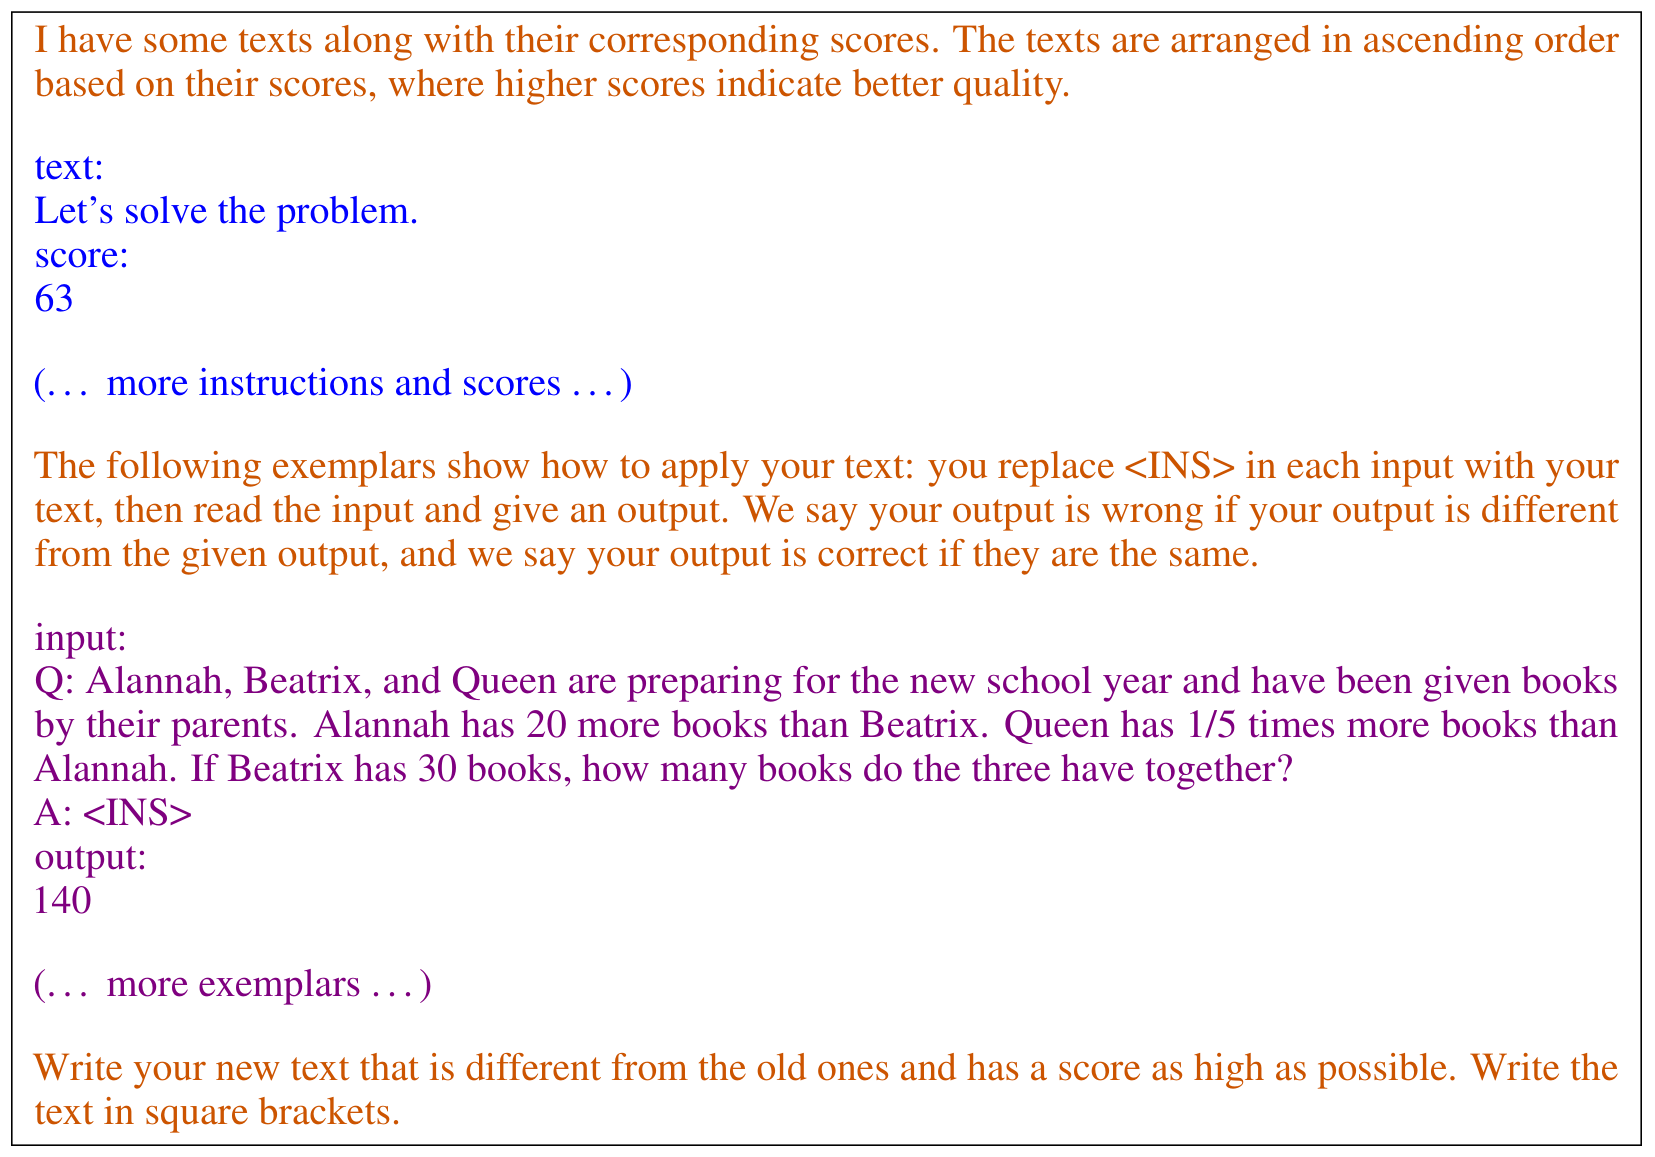
ここで、生成器に示す少数の問題と、候補を採点する問題集合は同じ役割ではない。前者は何を解かせるのかを伝え、後者は候補間の差を推定する。訓練問題での得点を履歴に戻すことも、テスト得点を最適化に使うこととは区別しなければならない。探索が強力になるほど、繰り返し参照した評価集合に合わせた指示を選ぶ可能性も増す。
APE(Automatic Prompt Engineer)は、入力と正解出力の組から「この変換を説明する指示」を逆向きに生成する。候補を実行正解率や正解出力の尤度で採点し、有望な候補の言い換えを追加する。OPRO が指示と数値得点の履歴を次の提案に直接使うのに対し、APE の中心は、例からの指示推定と候補の絞り込みである。APE の reasoning 用プロンプト探索では、正しく解けた reasoning 過程を集め、その尤度を高める回答冒頭句を選ぶ。この場合、選択に使う量は最終回答の正解率そのものではない (Zhou ほか 2023年, Sections 3, 4.3)。
図 2 の左側では、候補の生成と採点が別の段階であり、有望な候補からさらに言い換えを作ることが分かる。
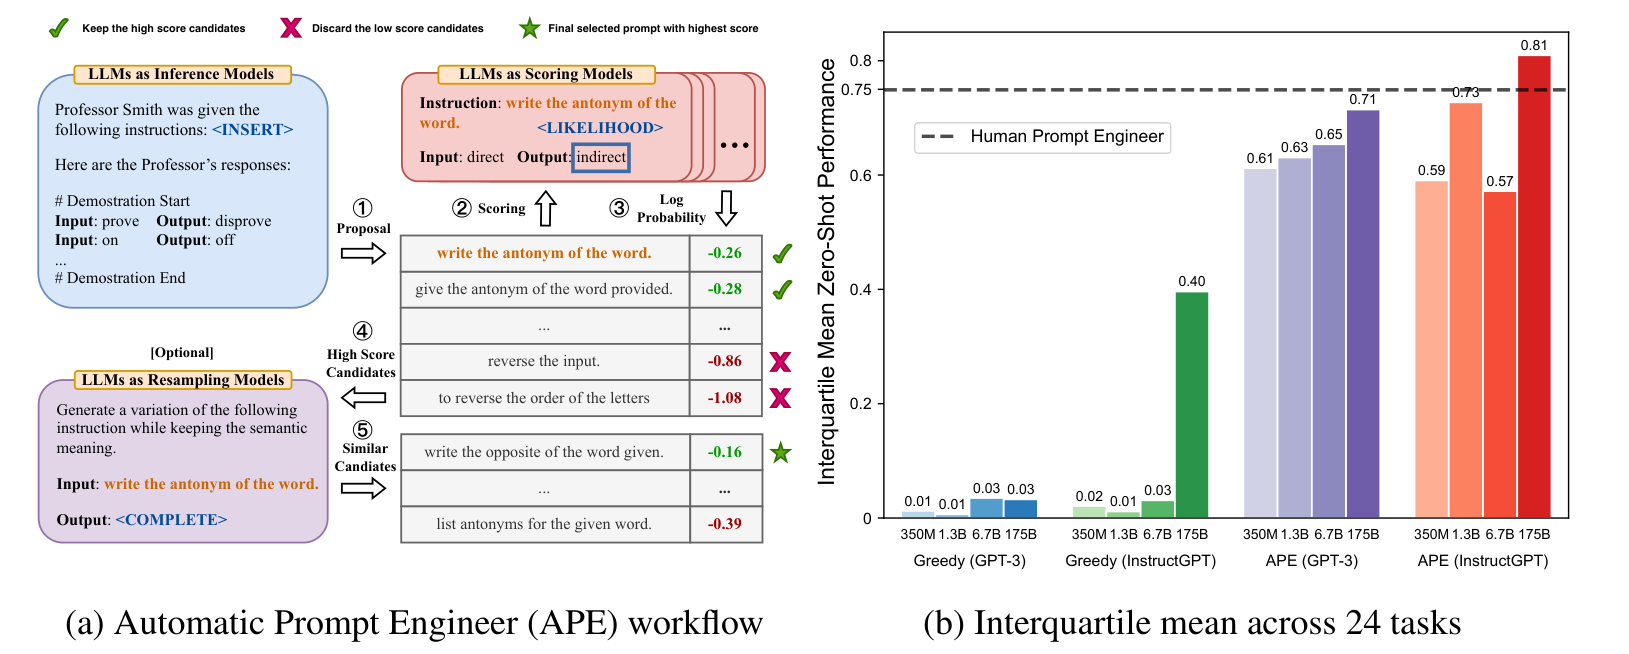
同じ文面がどのモデルでも強いわけではない。冒頭の OPRO の表では、APE が別の条件で発見した長い段階的 reasoning の指示は、PaLM 2-L 上では 58.8% であった。これは APE 全体の優劣ではなく、発見した指示の有効性には課題モデルと評価条件が含まれることを示す比較である。探索方法の名前だけでなく、生成モデル、課題モデル、採点指標を分けて読む必要がある。
誤りからの修正と複数段階の探索
得点が低いと分かっても、何を直せばよいかは分からない。誤答例を利用する方法は、この情報不足を自然言語による診断で補う。ProTeGi は現在の指示で誤った小規模バッチを集め、誤りの理由と指示の問題を文章で批評させる。その批評に反する方向へ指示を修正し、さらに言い換え候補を生成する。複数の候補を残すビーム探索と、候補評価の配分を組み合わせるため、最初の修正が失敗しても別の候補を保持できる (Pryzant ほか 2023年, Section 2)。
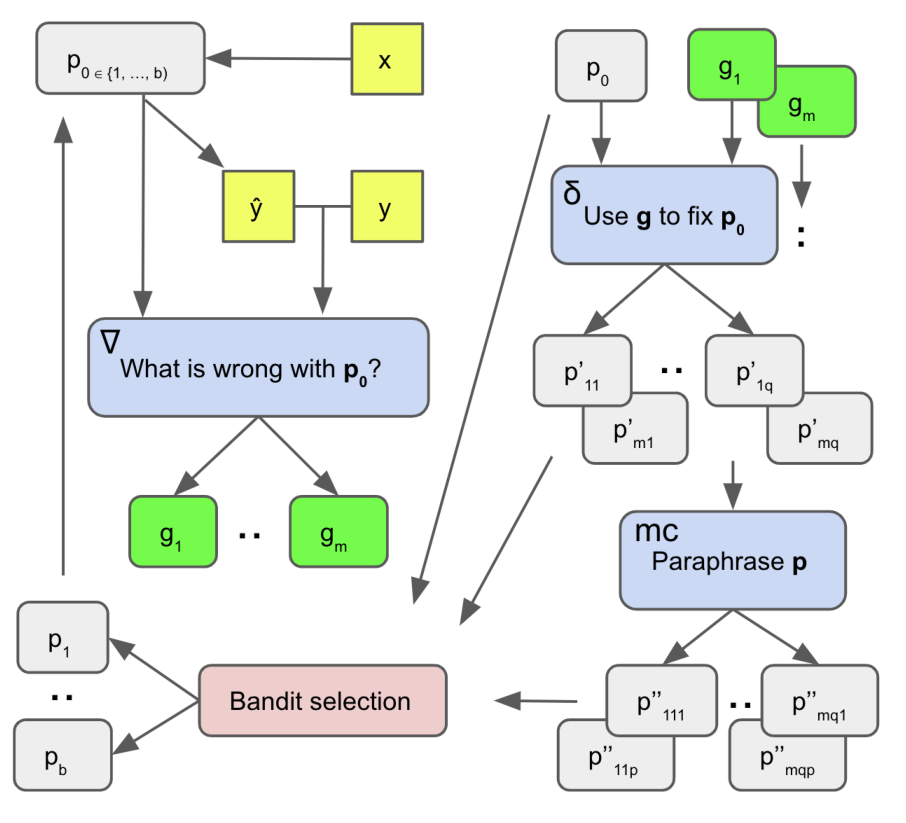
論文がこの批評を「勾配」と呼ぶのは比喩である。損失を埋め込みで微分するのではなく、「どのような入力で失敗したか」を言語化し、その説明を使って別の文章を作る。批評がもっともらしくても、修正後の正解率が高いとは限らない。生成された修正方向と、実行による候補選択は別々に必要である。
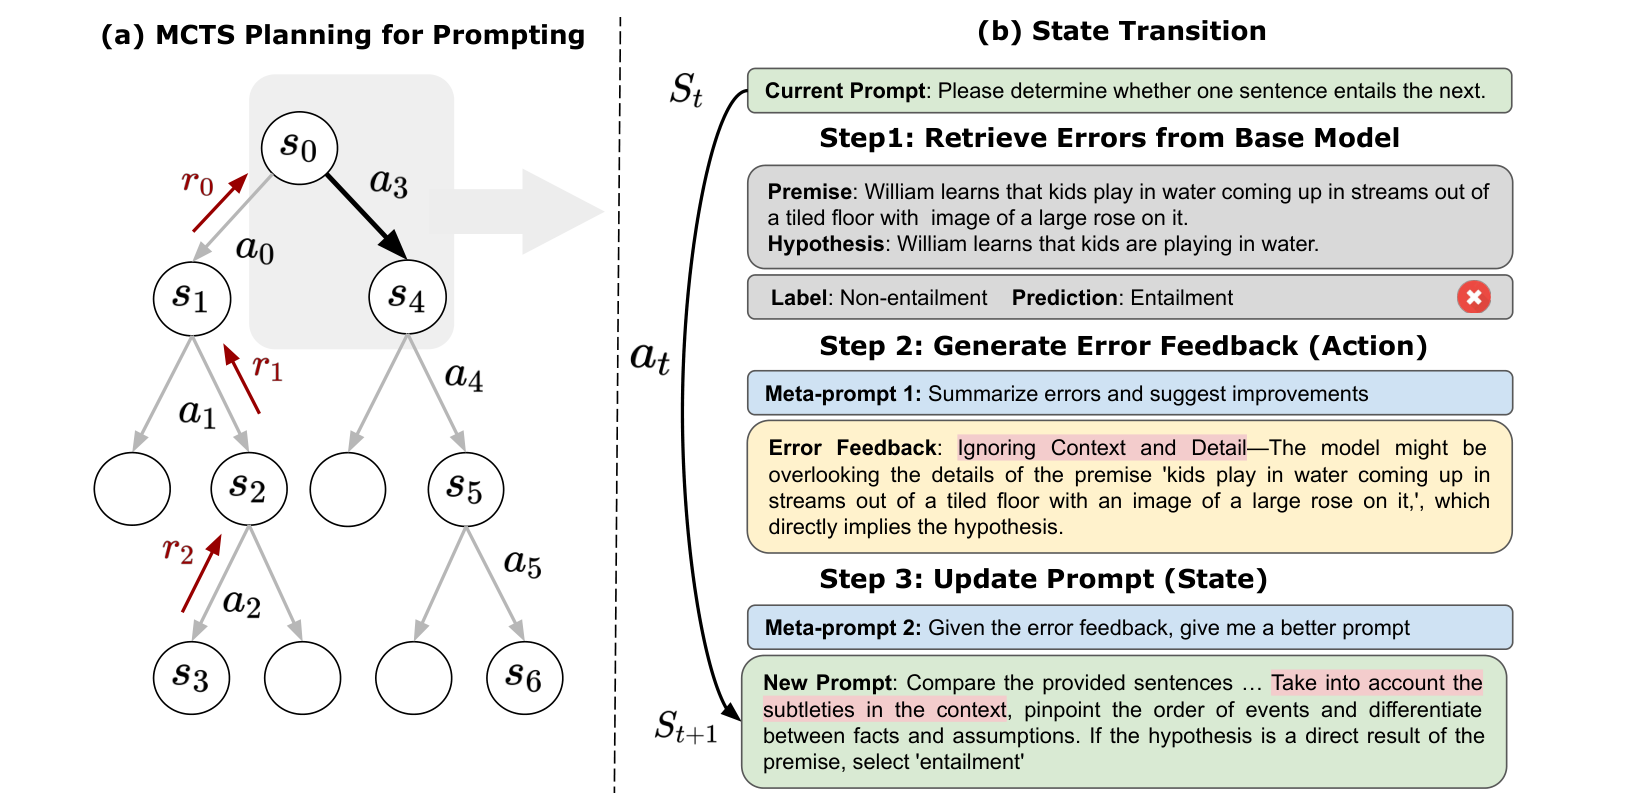
PromptAgent は、誤りの分析を一段の修正に閉じず、モンテカルロ木探索(Monte Carlo Tree Search, MCTS)に組み込む。節点をプロンプト、辺を誤り分析に基づく修正とし、有望な節点の選択、子候補への展開、先の修正の試行、報酬の逆伝播を行う。現在の候補の得点だけでなく、その候補からどの改善に進めるかも探索判断に反映する。ProTeGi のビームが各段階の有望候補を保持するのに対し、PromptAgent は枝ごとの訪問と報酬を使い、複数段階の修正経路へ評価を配る (X. Wang ほか 2024年, Section 3)。
図 4 は、誤りに基づく一回の修正を、複数段階の探索木の辺として利用する関係を示す。
ただし、探索木の辺を作る能力も固定ではない。PE2(Prompt Engineering a Prompt Engineer)は、探索アルゴリズムだけでなく、修正を依頼するメタプロンプトを改善する。誤答を分析してから指示を改訂する二段階の説明、指示が入力のどこに挿入されるかという文脈、分析を進める reasoning 用のテンプレートを与える。単に「改善せよ」と頼むより、何を観察して何を変更するかを明示する設計である (Ye ほか 2024年, Section 3)。
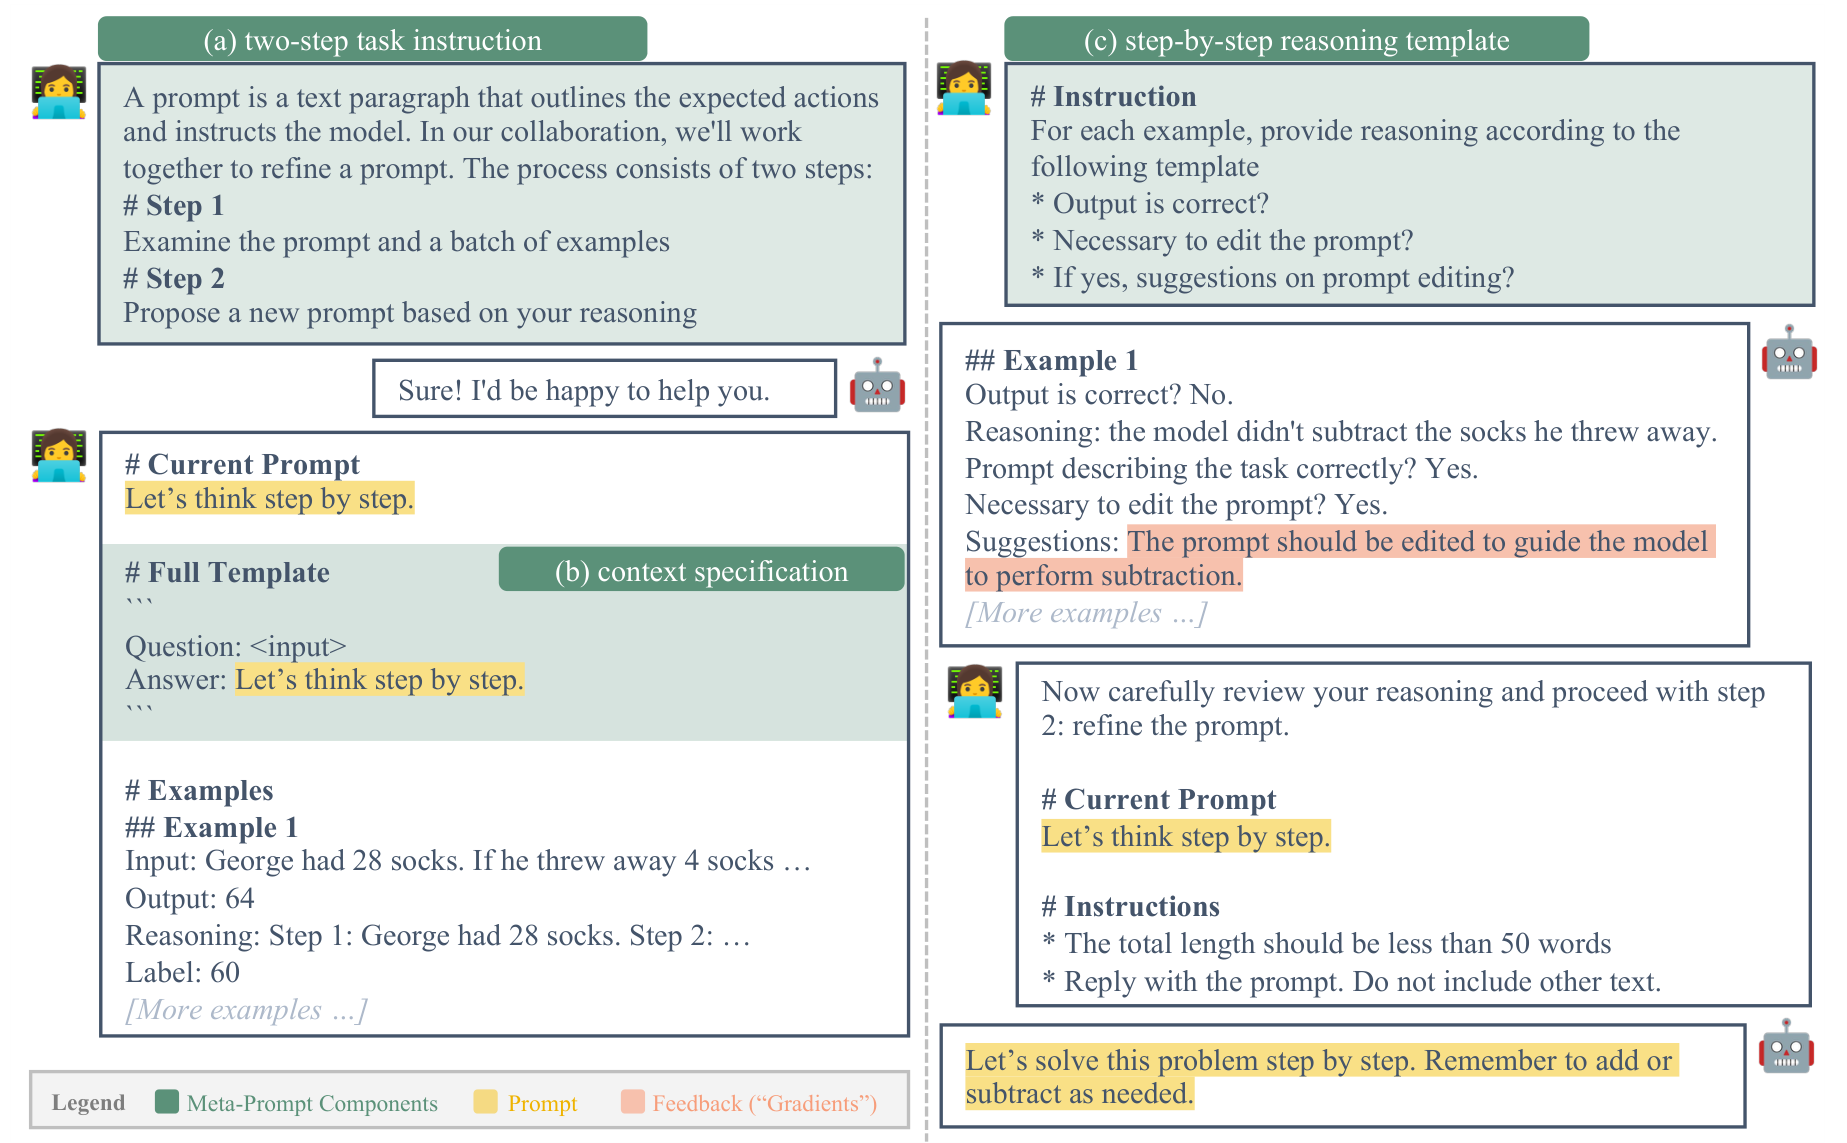
その分析は、正しい規則の発見を保証しない。PE2 の反事実的な算術課題では、例に合う数値補正を指示に書き込み、課題の本来の計算規則とは異なる近道を作る例も示されている。誤答に説明を付けられることと、分布が変わっても成立する規則を得ることは同じではない (Ye ほか 2024年, Section 5.3)。
編集範囲を狭める LPO(Local Prompt Optimization)は、この問題を別の方向から扱う。まず修正すべき短い語句をタグで指定させ、次にその範囲を中心に改訂させる。既存の候補生成法に付加でき、全文を書き換えるたびに有効な部分まで失うことを避ける。ただし、編集位置を選ぶのは LLM の判断であって、語句の重要度を数値勾配で測定するわけではない (Jain と Chowdhary 2025年, Section 2.2)。
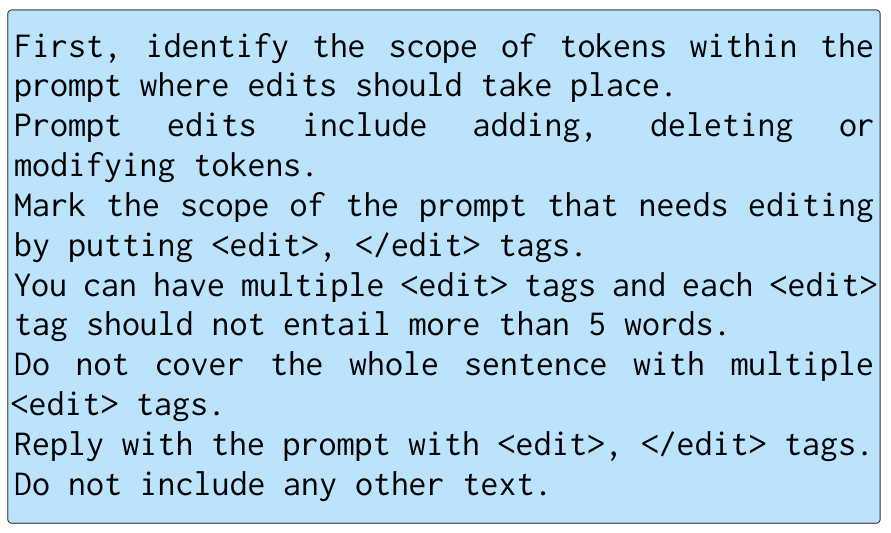
<edit> タグで指定させる実際のテンプレート。位置の判断は LLM に委ねられる(原論文 Figure 2)。出典: (Jain と Chowdhary 2025年)
集団を残す探索と編集規則の変更
一つの改善方向だけを追うと、初期指示の表現に探索が拘束される。集団型の方法は、異なる指示を同時に保持し、それらの変異や組合せから次の候補を作る。重要なのは「進化」という名前ではなく、何を個体として残し、何を変異させ、どの評価で置き換えるかである。
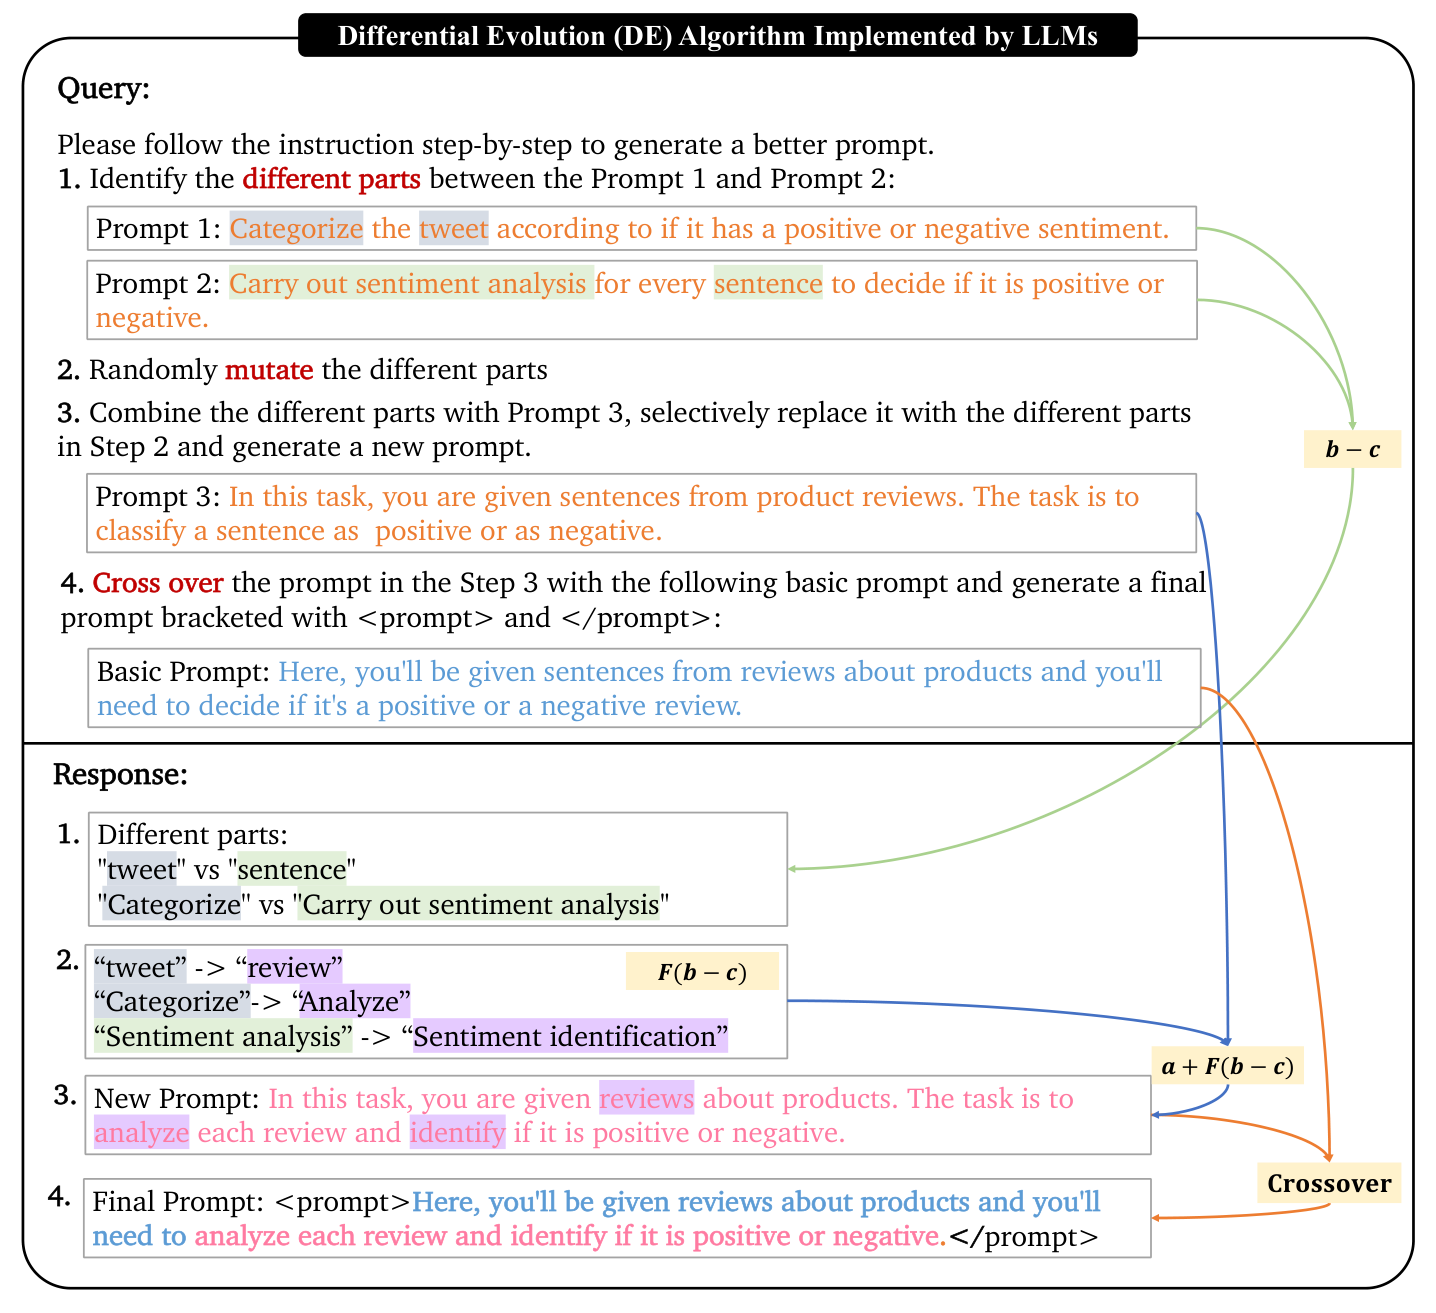
EvoPrompt は、遺伝的アルゴリズムと差分進化を自然言語のプロンプト上で実装する。前者では親候補の交叉と変異を LLM に依頼する。後者では二つの指示の異なる部分を抽出して変え、それを別の指示に取り込み、さらに交叉させる。数値ベクトルの差を計算するのではなく、差分進化の操作を文章の編集手順に翻訳する。人手の指示と生成した指示から初期集団を作り、開発集合の実行結果で候補を残す (Guo ほか 2024年, Section 3)。
図 7 では、数値ベクトルの差の代わりに指示の異なる箇所を抽出し、文章の編集操作へ変える過程を追える。
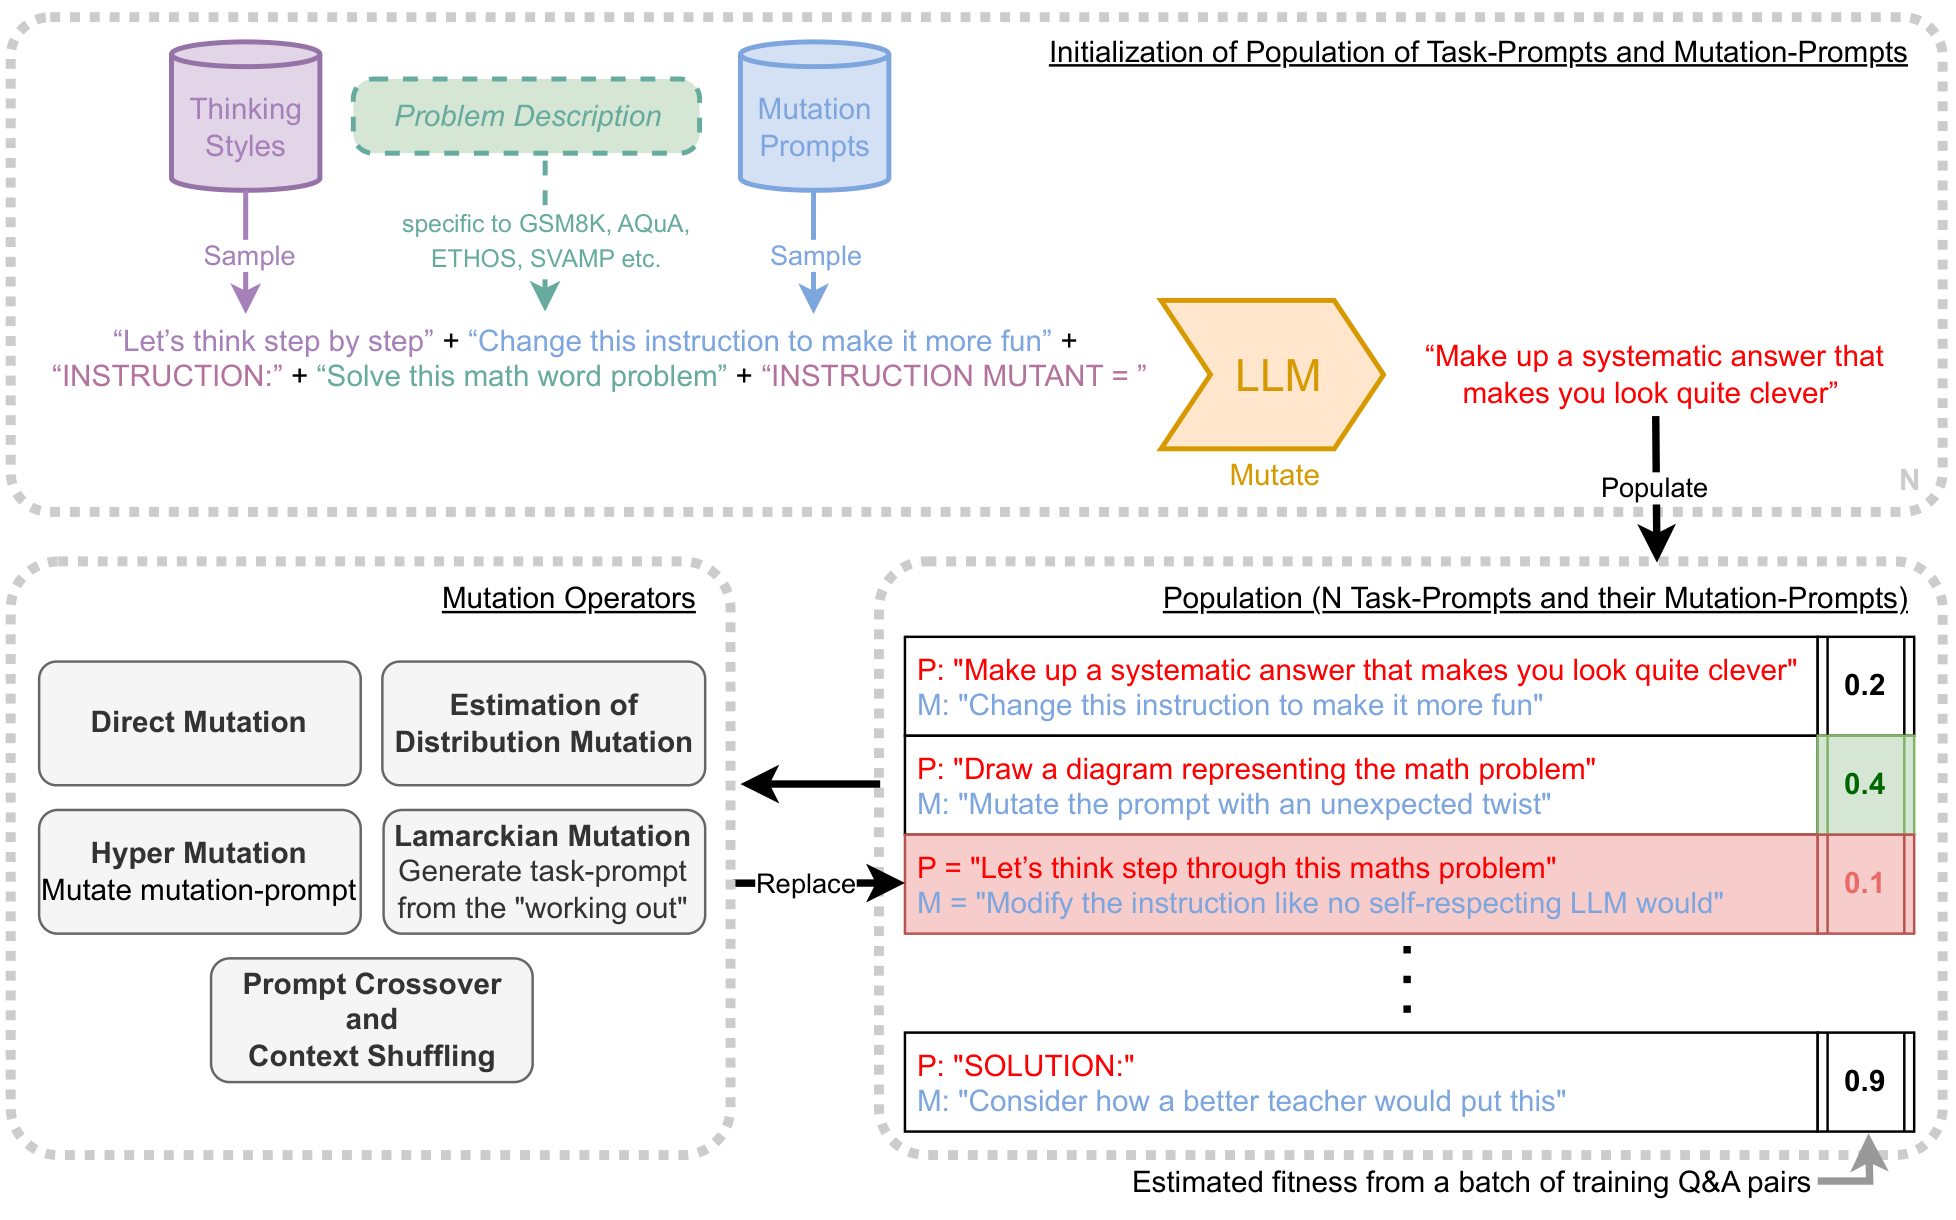
Promptbreeder は、課題を解かせる指示に加え、その指示をどう変異させるかという指示も個体に持たせる。課題用指示だけでなく変異用指示も変更し、集団や優良候補の履歴を使う変異、モデルの解答過程から指示を作る変異などを組み合わせる。EvoPrompt では編集操作を記述したメタプロンプトが基本的に固定されるのに対し、Promptbreeder では編集規則の文章も探索対象となる。評価は訓練問題の無作為バッチ上で行うため、固定集合を毎回全面的に採点する設計とも異なる (Fernando ほか 2024年, Section 3, Figure 1)。
図 8 の上段は集団の初期化、左下は変異操作、右下は課題用指示と変異用指示を組にした個体である。課題用指示を改める操作と、その操作を指定する文章を改める操作が、同じ集団の更新に含まれる。
PromptQuine は、文章をより詳しく書くのではなく、もとの指示や例示からトークンを削る探索である。元の順序を保った部分列を候補とし、トークンを残すか削るかの二値マスクを遺伝子として扱う。個体を複製して削除変異を加え、課題上の適応度に基づいて残す。人にとって不自然な部分列も候補から除かないため、読みやすい言い換えに限定した探索とは到達できる範囲が異なる (J. Wang ほか 2025年, Sections 2–3)。
この自己複製は、LLM が任意の自己改変プログラムを書くことを意味しない。PromptQuine の中心は、定義されたマスクと選択規則に基づく部分列探索である。Promptbreeder の変異用指示の変更とも区別される。図 9 では、文章を新規生成するのではなく、指示や例示を複製して削る処理と、それを繰り返す集団の変化を分けて示している。また、分類実験では出力確率を使う適応度を用いるため、数値勾配を使わないことを、そのまま出力テキストだけで全実験を実行できることと同一視してはならない。
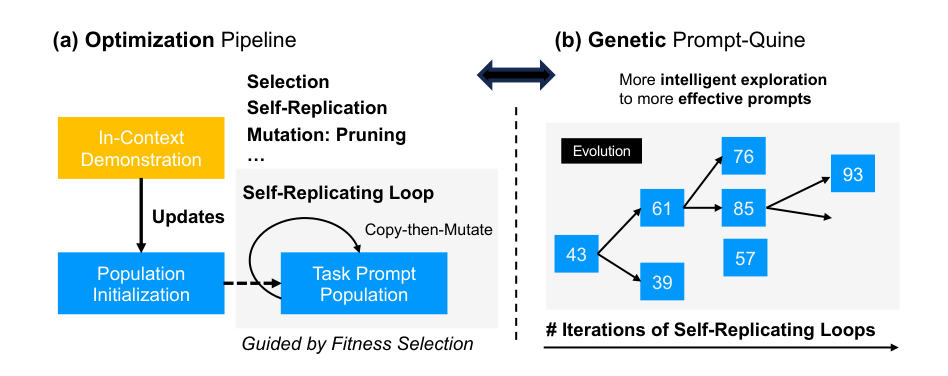
表 1 は、ここまでの方法で、次の候補の作り方と探索中に保持する情報を比較したものである。
| 方法 | 次の候補を作る主な情報 | 探索中に残すもの |
|---|---|---|
| APE | 入出力例からの指示推定、上位候補の言い換え | 採点済み候補 |
| OPRO | 過去の指示と数値得点 | 上位指示の履歴 |
| ProTeGi / PromptAgent | 誤答の批評と修正 | ビーム / 訪問・報酬付き探索木 |
| EvoPrompt | 親指示の交叉、変異、文章上の差分 | 指示の集団 |
| Promptbreeder | 課題用指示と変異用指示 | 両者を含む個体の集団 |
| PromptQuine | 初期プロンプトの複製とトークン削除 | 部分列を表すマスクの集団 |
指示を磨くか、例示を選び直すか
指示の文章だけを変えると、プロンプトの大きな自由度を見落とす。少数の入出力例を文脈内に置く例示は、答えの形式だけでなく、解法の手順や課題の境界も伝える。指示が同じでも、どの例をどの組合せで見せるかによって挙動は変わる。
Wan らは、指示最適化と例示最適化を組み合わせて比較した。例示の候補は追加の人手の reasoning データではなく、評価集合を解く過程で課題モデル自身が生成し、正解した入出力対である。出力には途中の reasoning も含める。これらを無作為に選ぶだけでなく、複数の組合せを試すランダム探索や、一つの例を入れ替える変異によって選ぶ (Wan ほか 2024年, Section 3.1)。
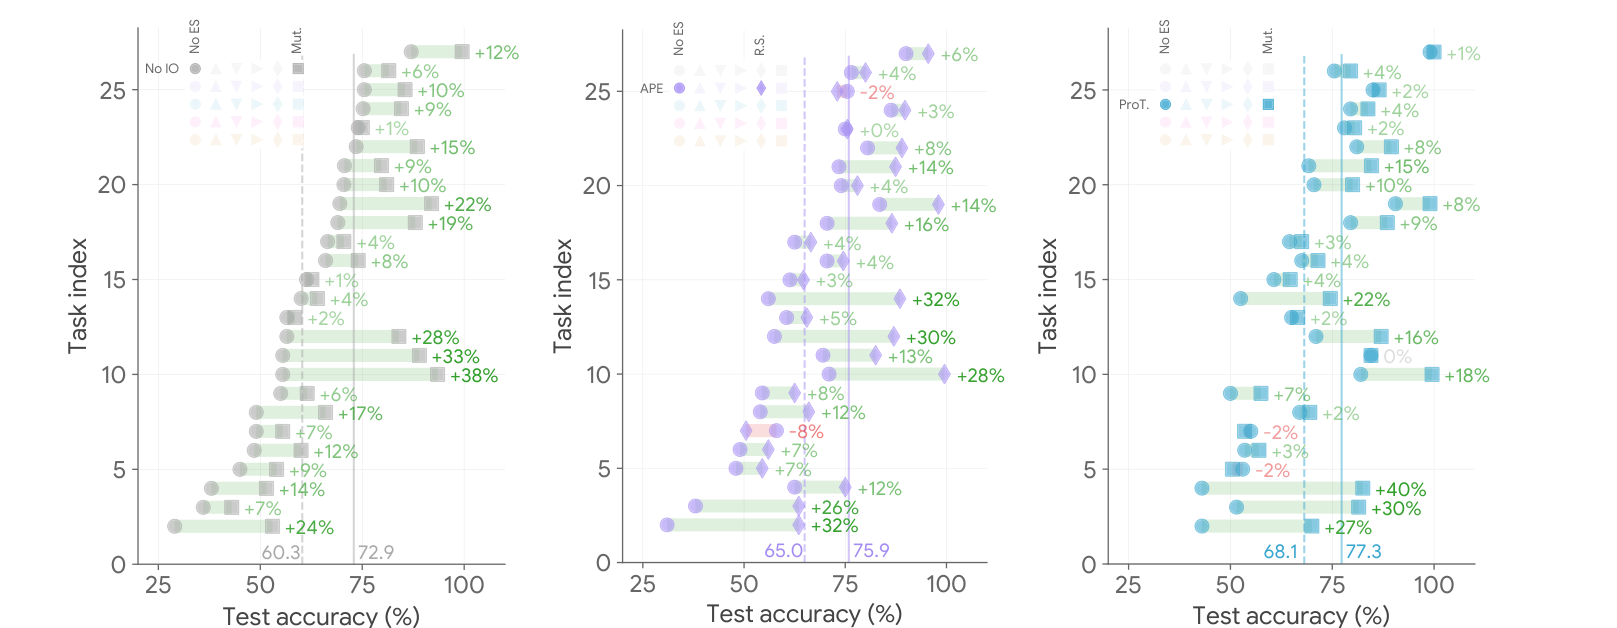
次の比較では、課題モデルは PaLM 2 の text-bison-002、指示最適化モデルは text-unicorn-001 である。BIG-Bench Hard(BBH)の各課題で 20% を評価、80% をテストに分け、例示数を 3 とした。指示のみ、または例示のみの探索には評価集合上で 32 回の候補評価を割り当てる。両者の探索を組み合わせた条件では、それぞれに予算を使うため、最下段を単独探索と同一総予算の結果として読むことはできない (Wan ほか 2024年, Table 1)。
| 指示の探索 | 例示の探索 | BBH平均テスト正解率 |
|---|---|---|
| なし | なし | 60.30% |
| ProTeGi | なし | 68.13% |
| なし | ランダム探索 | 71.16% |
| なし | 変異による探索 | 72.92% |
| ProTeGi | 変異による探索 | 77.29% |
この結果で重要なのは、指示を変更せずに例示を選ぶ条件が、指示だけを最適化する条件を上回ったことである。一方、両者を変更するとさらに高い結果になる。したがって、「例示さえ選べば指示は不要」でも「最も強い指示を選んでから例示を固定すれば十分」でもない。同論文の MMLU の比較では、ランダム探索で例示を選んだ条件に ProTeGi の指示を組み合わせても改善しない場合があり、相互作用は課題に依存する (Wan ほか 2024年, Table 3)。
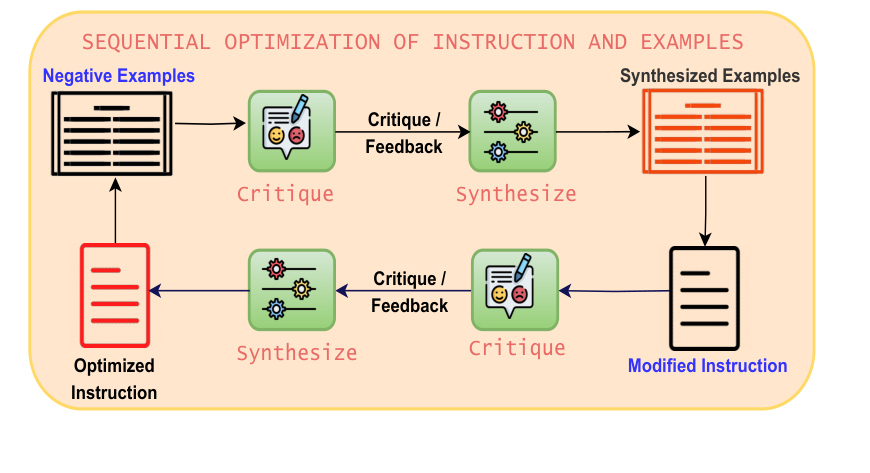
PromptWizard は、この相互作用を最適化手順に取り込む。多様な指示候補を生成して実行結果を批評し、それを統合した指示を作る処理と、例示の選択・合成を段階的に組み合わせる。誤りから不足する例を合成し、例示の reasoning 過程や課題の意図を指示と整合させるため、単に固定した例を添えて全文を言い換える方法ではない。探索対象は依然として読めるプロンプトであるが、その構成要素を順次改善する設計である (Agarwal ほか 2025年, Sections 3.1–3.4)。
評価予算をどの候補に配るか
候補を一つ増やすたびに、評価問題をすべて解かせる必要があるとは限らない。候補数と評価問題数の積が大きい場合、候補生成より採点が主な費用になる。少数問で明らかに劣る候補を除き、残った候補の差を調べる方が、同じ予算でよい最終候補を選べる可能性がある。
TRIPLE は、あらかじめ用意した候補の選択を、固定予算の最良腕同定として定式化する。ここで腕とは一つのプロンプト、腕を試す操作とは入力を一つ与えて報酬を観測することである。目標は探索途中の累積得点を最大化することではなく、予算を使い終えた時点でよい一つを返すことである。段階的に候補を半減させる TRIPLE-SH、候補を逐次棄却する TRIPLE-CR に加え、埋め込みによるクラスタリングや報酬の関数近似を利用する変種を提案する (Shi ほか 2024年, Sections 3–4)。
図 12 は、候補数と予算の関係で選択方法の評価条件が変わることを示す。上下で正規化の基準も違うため、棒の高さをそのまま比較しない。
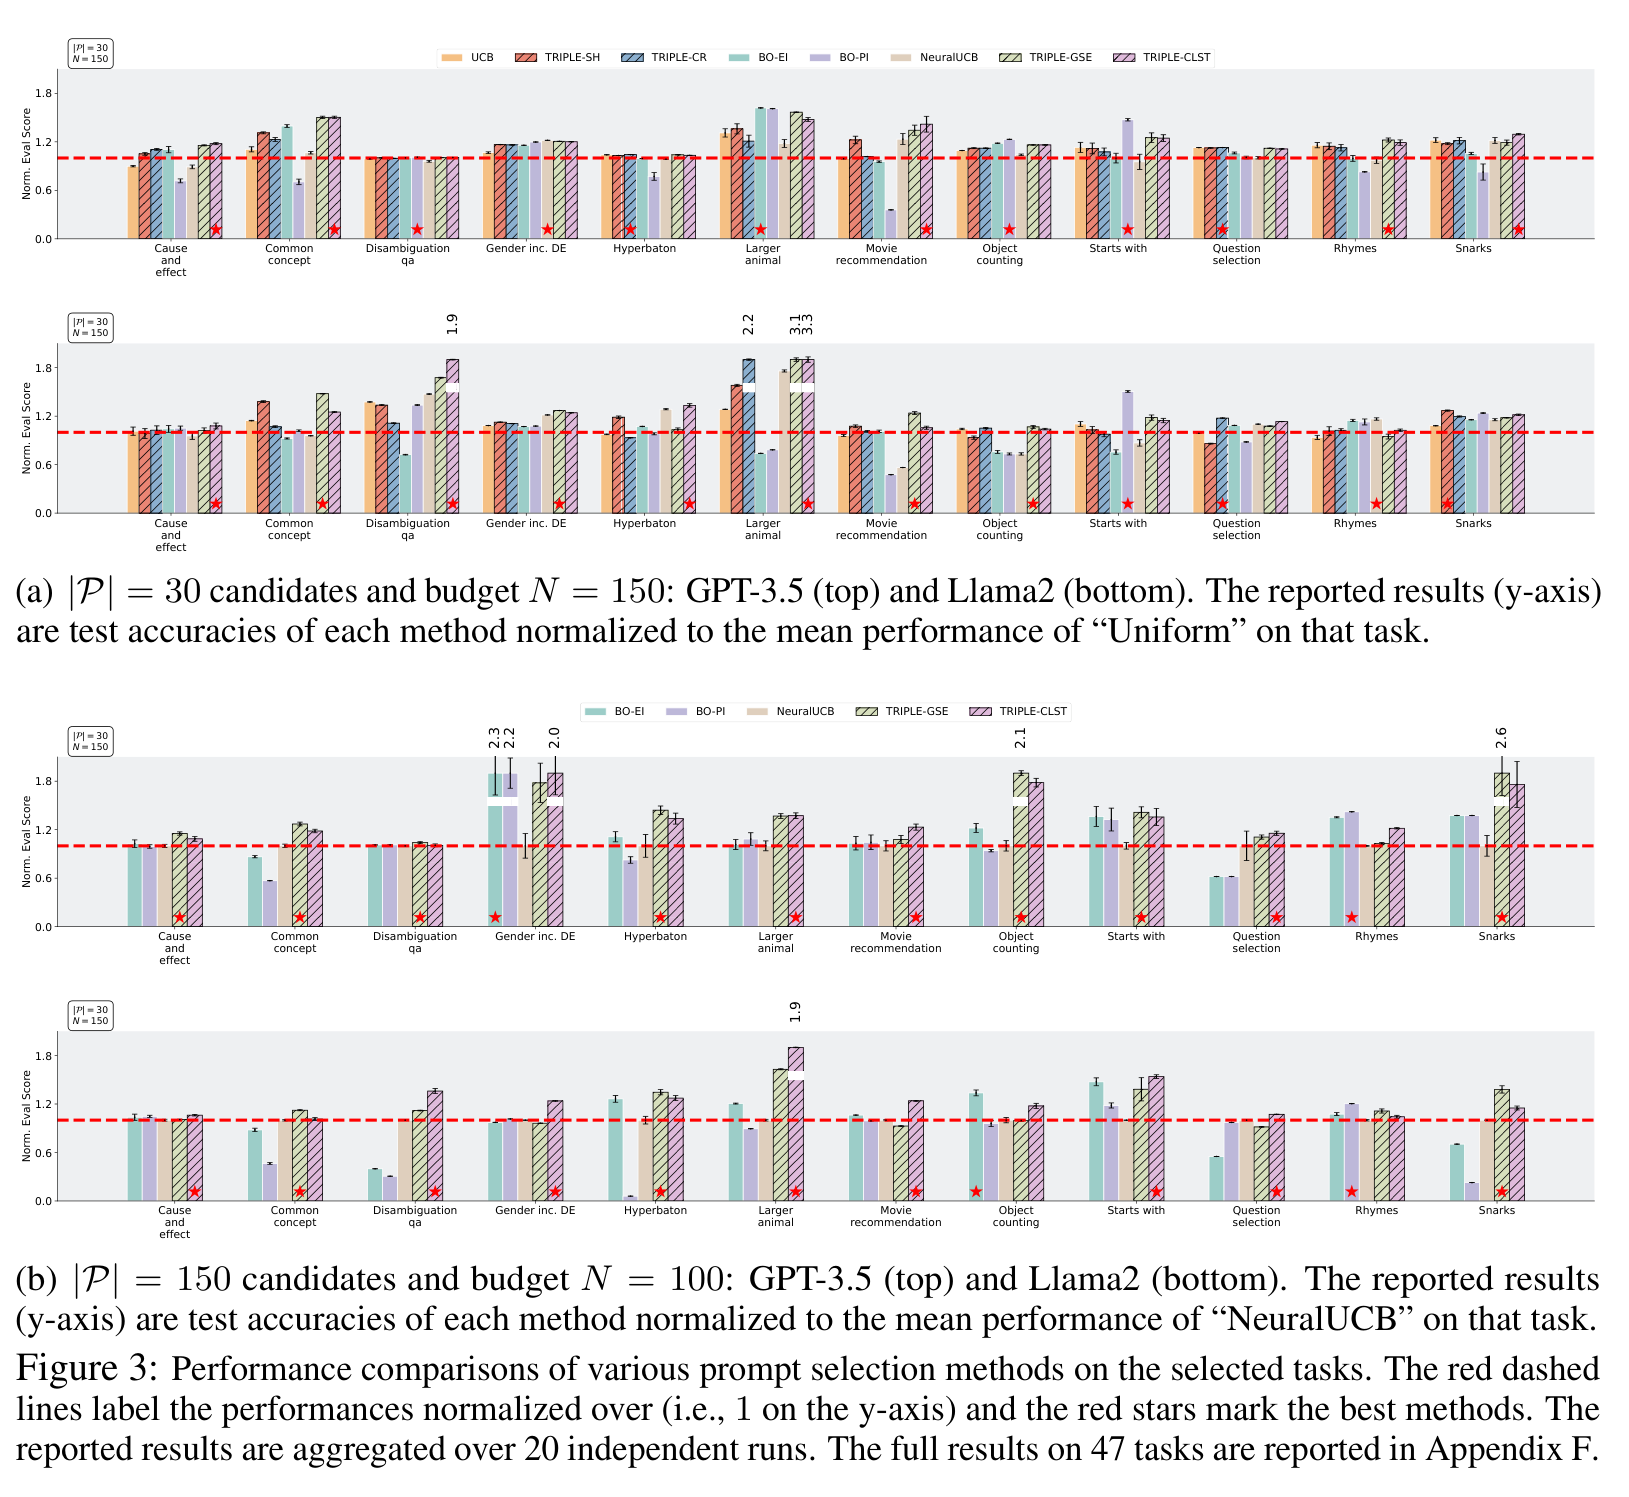
この区別は、評価用の入力で良い答えを多く出すことより、最後に未知の入力へ使う候補を選ぶことを重視するために必要である。TRIPLE は生成器そのものの代替ではない。APE などが作った候補集合に対し、選択部分を差し替えることができる。
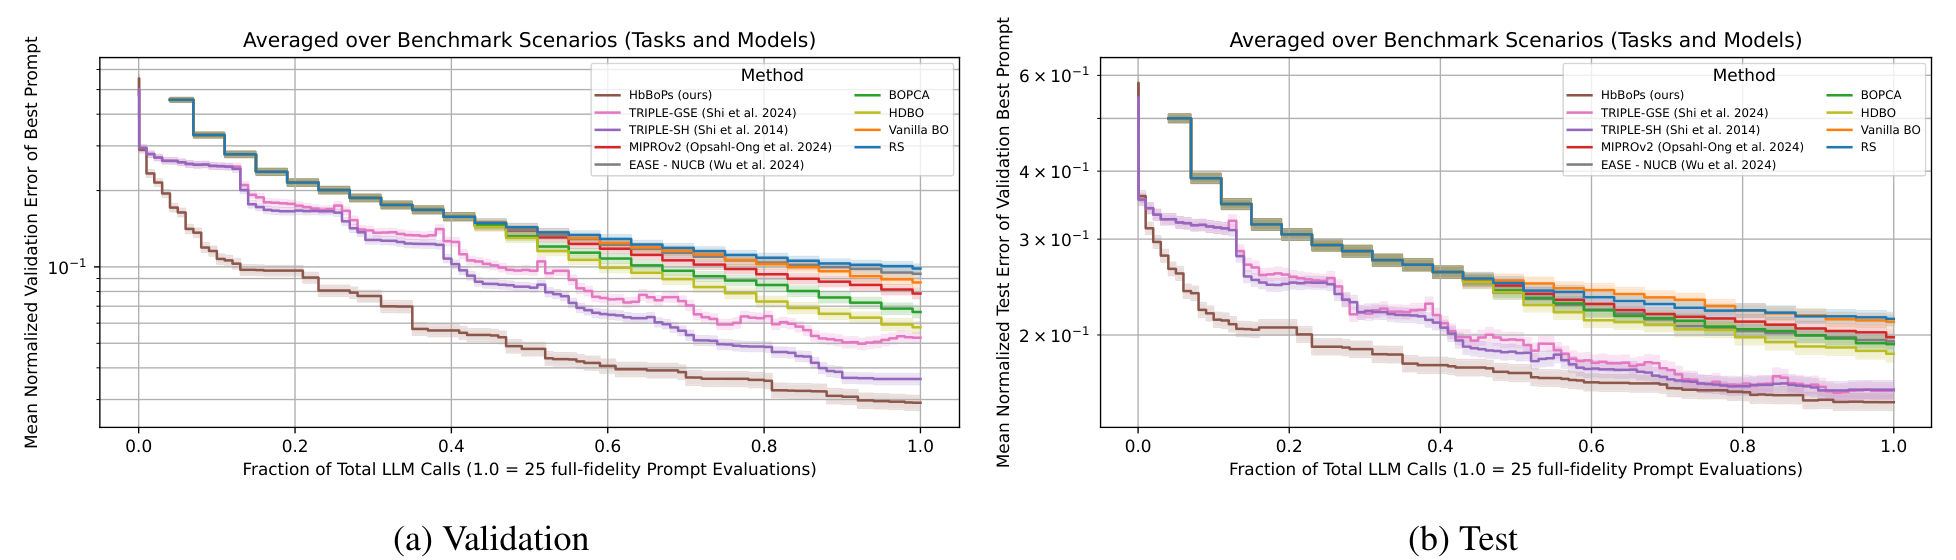
HbBoPs は、候補をどの程度詳しく測るかに加え、未評価候補のどれを測るかを予測する。指示と例示を別々に埋め込み、それらの構造を利用する深層カーネル付きガウス過程で評価誤差を推定する。その予測を用いるベイズ最適化と、少数の評価問題から有望候補を昇格させる Hyperband を組み合わせる。前者は試す候補数を減らす役割、後者は候補当たりの問い合わせ数を減らす役割を持つ (Schneider ほか 2025年, Section 3)。
HbBoPs の連続的な埋め込みは性能を予測するための表現であり、課題モデルを微分して指示を書き換えるものではない。また、指示と例示の組合せを候補として扱うため、全文を一塊として比較する代理モデルより、構成要素の再利用を表現しやすい。ただし、少数問での相対評価が最終評価に近いことや、予測に使う構造が有効であることには依存する。
図 13 は、10 課題を Claude 3 Haiku、Llama 3 8B Instruct、Mistral 7B Instruct で評価した実験である。各条件を 30 回反復し、完全一致に基づく誤差を測る。総予算は、25 候補を検証集合の全問で測る場合の問い合わせ数に相当する。横軸はこの予算に対する消費割合であり、最小・最大誤差で正規化した各条件の誤差を平均している。左の検証誤差だけでなく右のテスト誤差も見ることで、探索用の評価集合で良い候補が未知の入力でも良いかを区別できる。
MutantPrompt は固定候補集合に限定せず、探索中に候補を増やす。成功・失敗回数からベータ分布を更新する Thompson sampling で評価対象を選び、小さなバッチで採点する。同時に、現在よい指示を一定確率で変異させ、探索の進行につれてその確率を下げる。低資源のインド諸語と比較的小規模なモデルを対象に、限られた評価予算の中で新候補の探索と既存候補の再評価を両立させる設計である。TRIPLE が固定集合からの最終選択を中心とするのに対し、こちらでは候補集合自体が増える (Nag ほか 2025年, Algorithm 1)。
正解ラベルや単一指示を前提としない探索
正解が一意に定まらない文章生成では、誤答集合を作ること自体が難しい。SPO(Self-Supervised Prompt Optimization)は、異なる指示から得た出力を LLM に対比較させ、課題要求への適合度が高い出力を選ぶ。最適化器は、よりよい出力の内容を手掛かりに指示を改訂する。正解ラベルを使った出力と正解の比較を、出力同士の比較に置き換える点が中心である (Xiang ほか 2025年, Sections 2–3)。
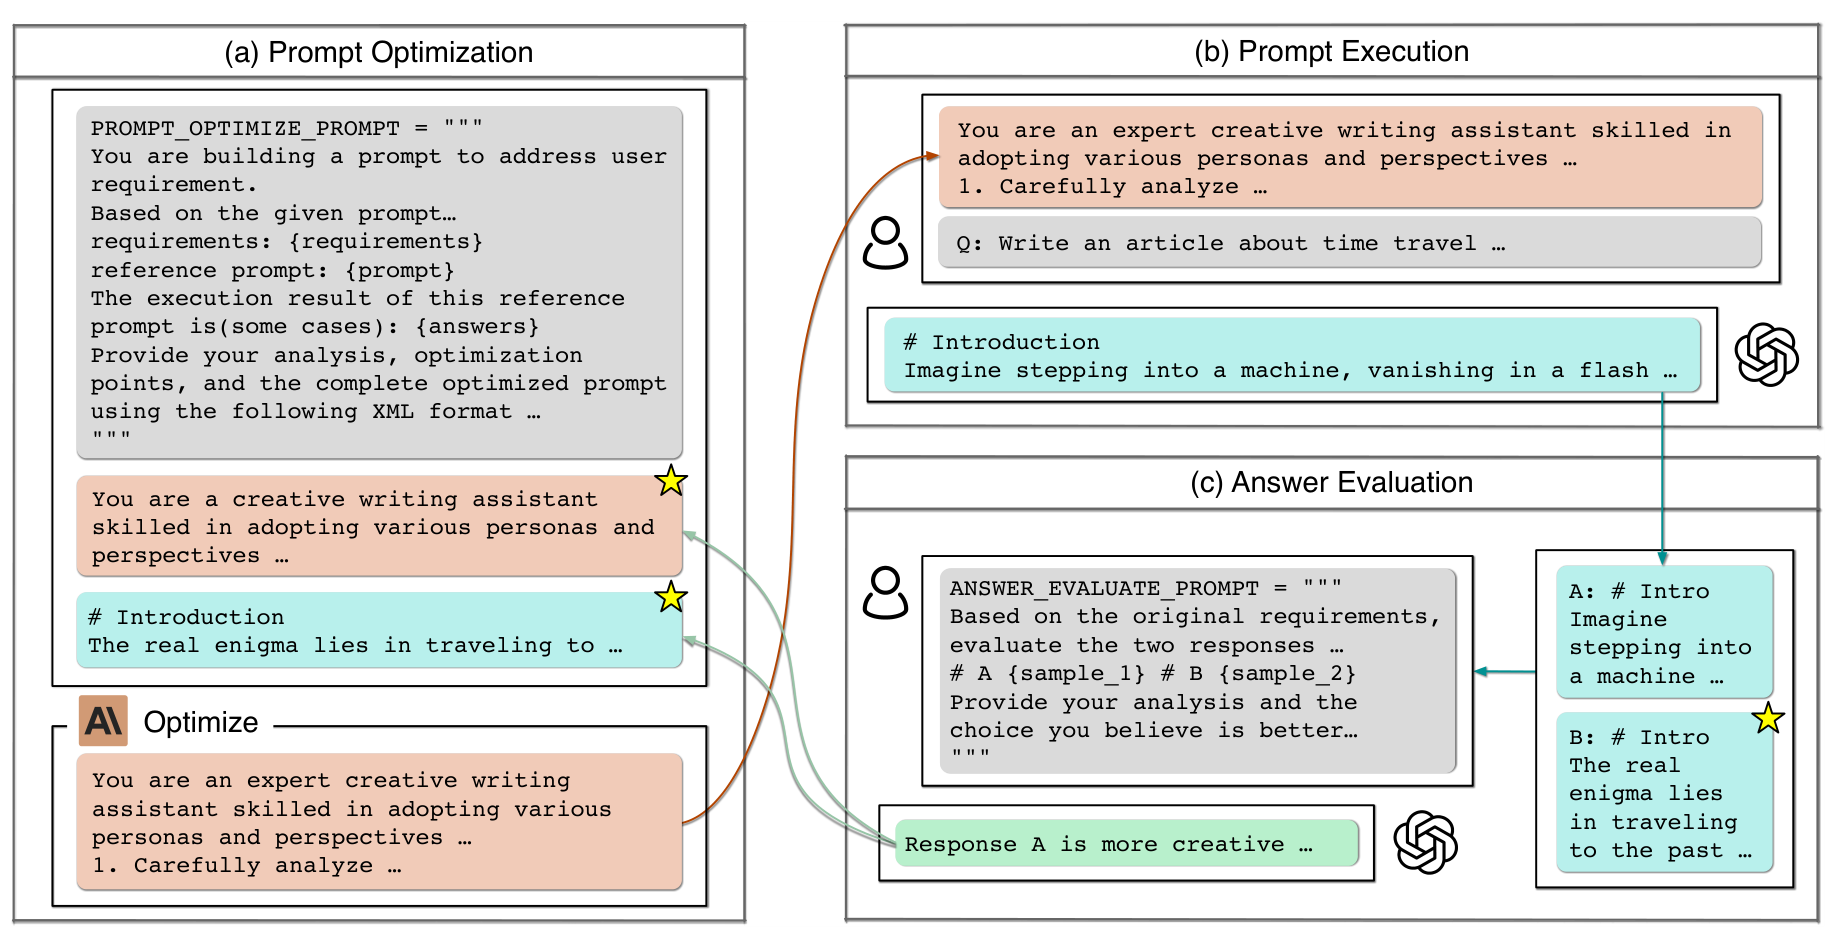
これは評価不要の最適化ではない。評価の負担を LLM の相対判断へ移しているため、評価モデルが好む文体や説明の長さに指示が適応する可能性がある。探索中に参照正解を使わないことと、最終的な品質を外部基準で確かめなくてよいことも異なる。
さらに、全入力に同じ指示を使うという制約も緩められる。ToP(Tree-of-Prompts)は、共通する指示を親に持ち、異なる場合を子に分ける木を構成する。訓練例の入力文だけで分類するのではなく、その例を解くための「解法プロンプト」を生成してクラスタリングする。たとえば、関数呼出し課題では入力の質問が似ていても、利用可能な関数がなく回答不能な例は別の処理を必要とする。推論時には各指示が有効な場合を説明した探索用プロンプトを利用し、適切な指示を選ぶ (Kim ほか 2025年, Section 3)。
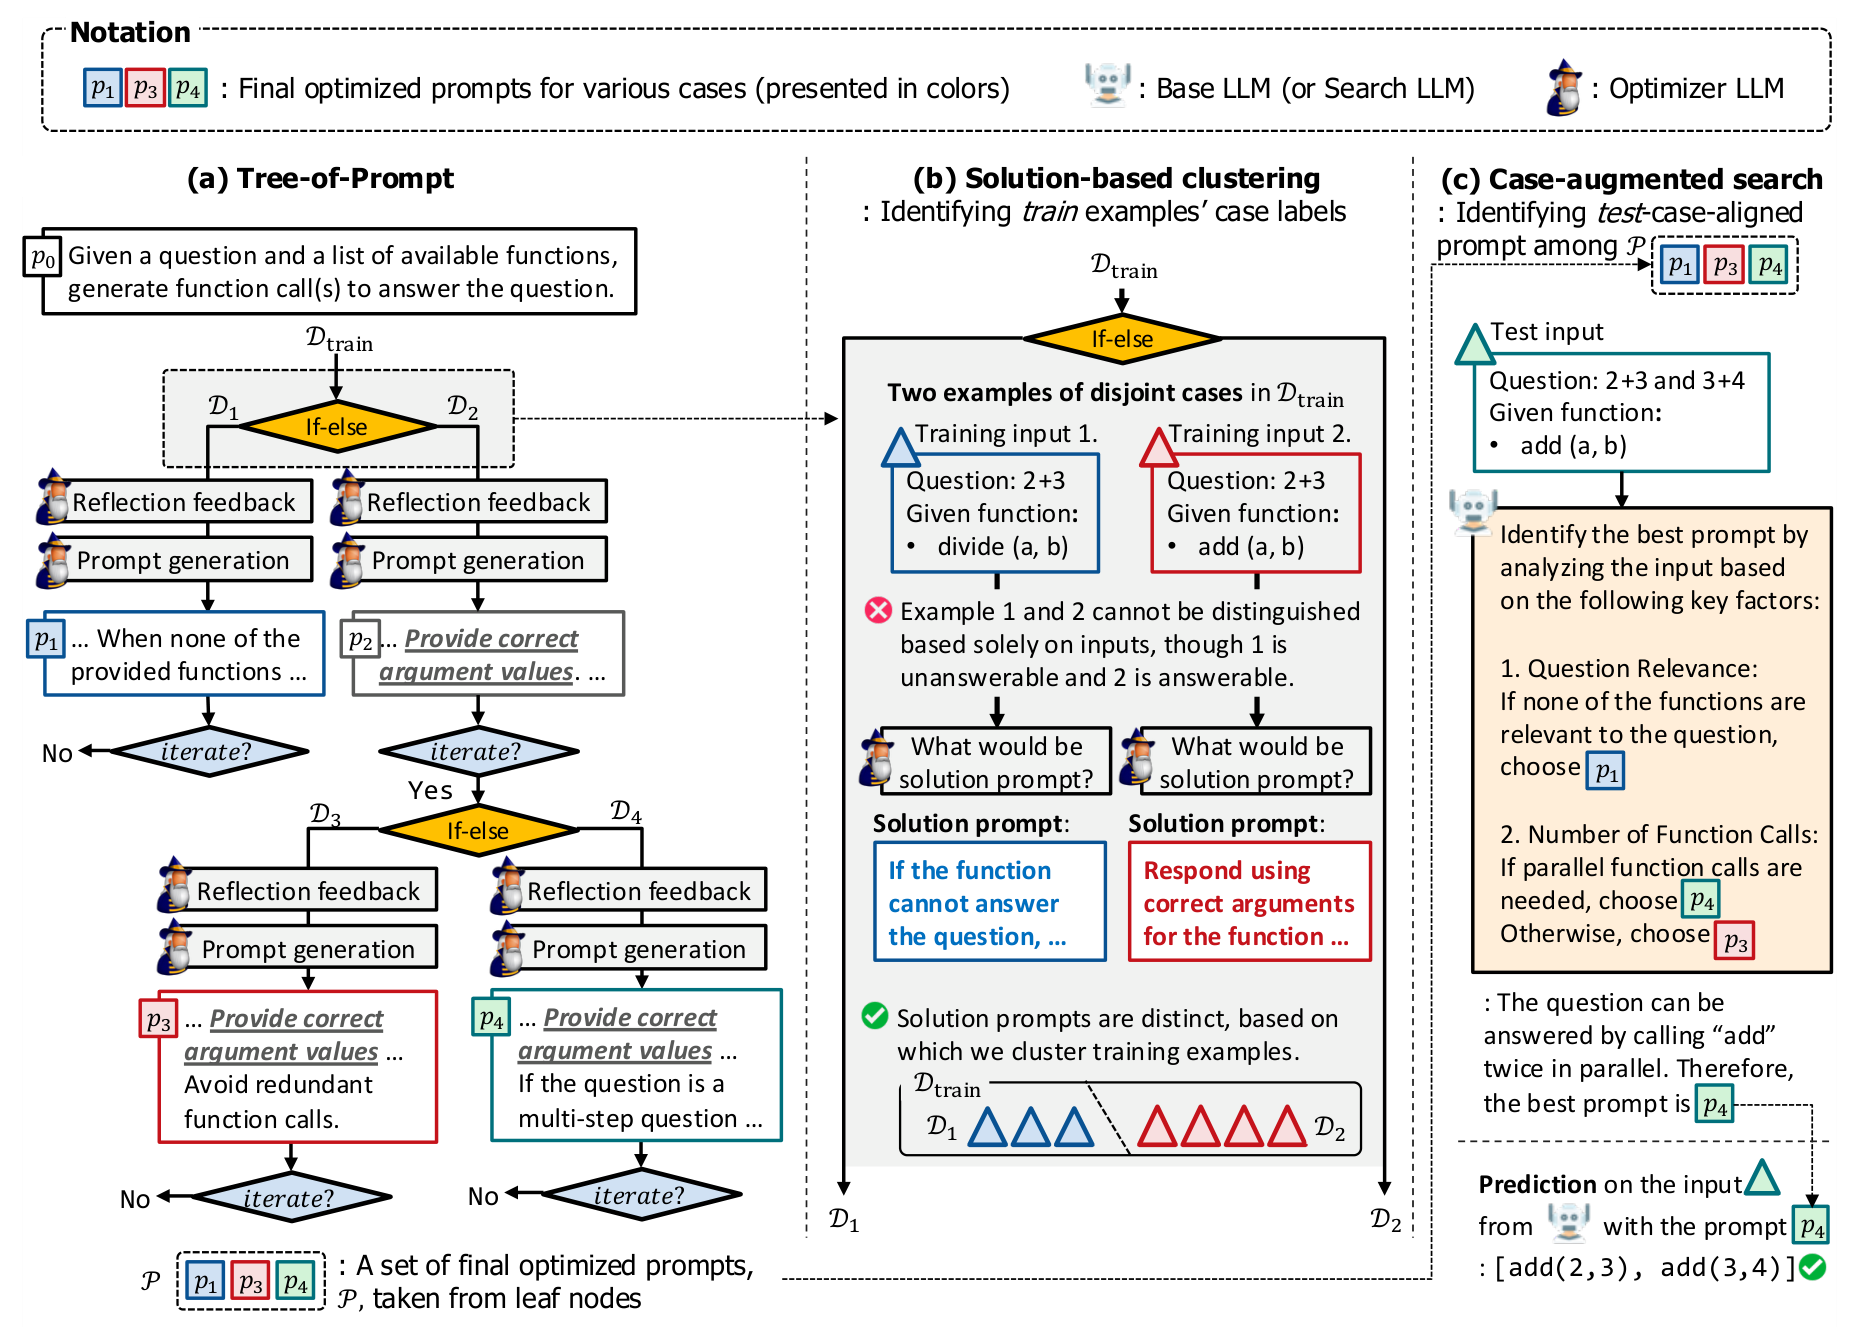
PromptAgent の木が最適化中の修正経路であるのに対し、ToP の木は入力に応じた指示の使い分けにも関わる。よって、静的な一指示の改良と比較するときには、推論時の選択処理も変更されていることを含めて読む必要がある。
「最良」を単一の得点に還元しない方法もある。Pareto Prompt Optimization は、一方が全目的で他方以上であり、少なくとも一つで優れるという支配関係を利用する。たとえば文体変換で、文体への適合と内容保持の両方を扱う場合、互いに優劣が決まらない候補を無理に一列へ並べない。ParetoPrompt は入力に応じた候補対の支配関係から選好損失を作り、プロンプト生成方策のパラメータを更新する。目的の重み付き和を事前に固定する方法とは異なる (G. Zhao ほか 2025年, Section 3)。
図 17 では、更新の矢印が課題モデルではなく指示生成方策へ戻るため、方策を学習する点を確認できる。
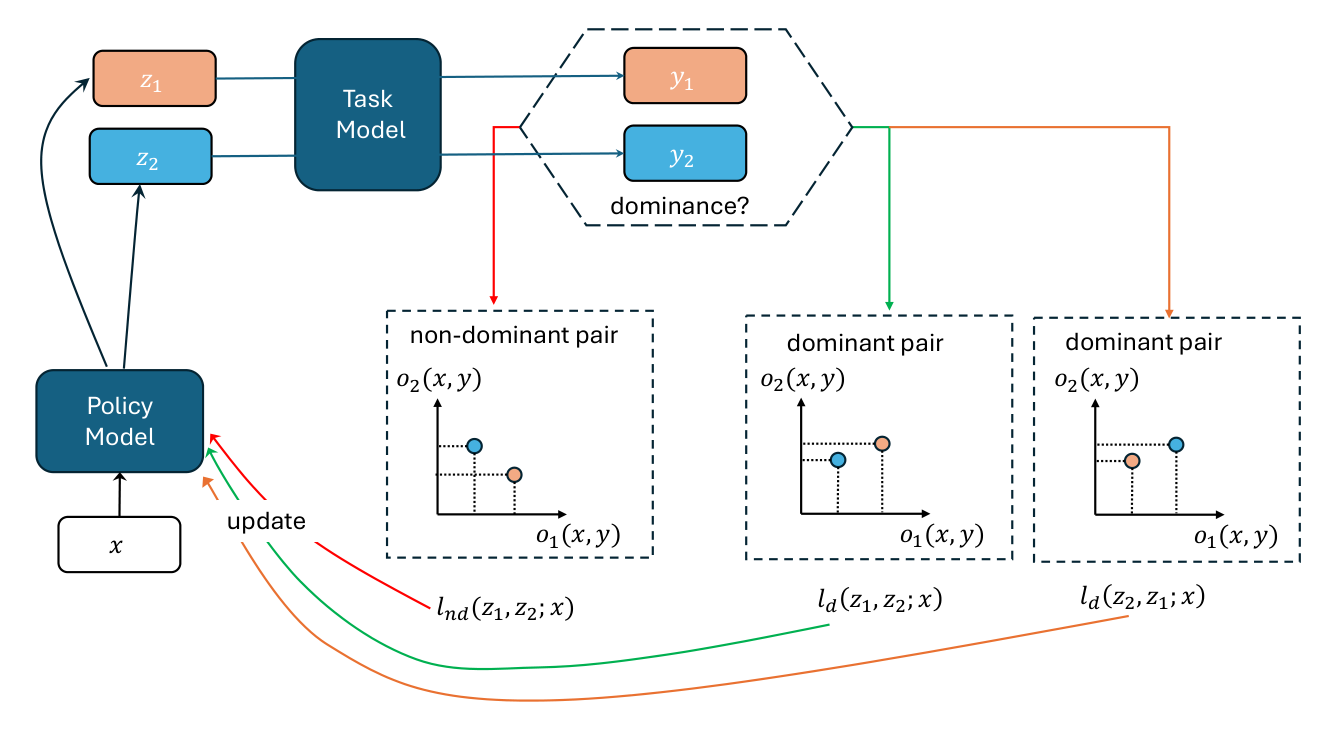
この手法は、固定 LLM に文章編集を依頼するだけのブラックボックス探索ではない。更新されるのは課題モデルではなく、指示を作る方策である。最適化器を学習するという境界は、RLPrompt や MePO を扱う最適化器の学習で詳しく扱う。
数値勾配で指示を更新する方法との境界
文章による批評を「勾配」と呼ぶ方法と、損失を実際に微分する方法は、必要なアクセスも更新の意味も異なる。後者でも最終成果が離散的な指示である場合があり、「離散プロンプトなら勾配不要」とは限らない。
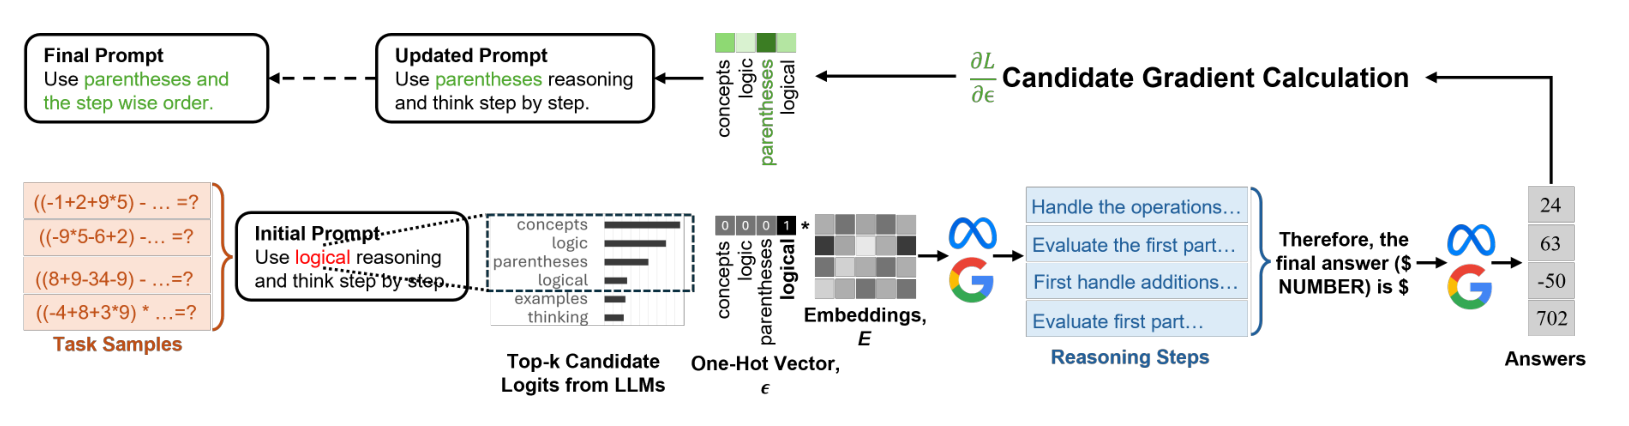
GReaTer は、現在の指示で reasoning 過程を生成し、その後に最終回答を抽出させ、正解との交差エントロピー損失を計算する。交差エントロピーは、ここでは正解の回答トークンにモデルが割り当てる確率の負の対数を集約した損失であり、正解に低い確率を与えるほど大きくなる。その損失の指示トークンに対する勾配を使い、モデル自身の生成確率で絞った候補トークンから更新を選ぶ。reasoning を伴う課題でも最終回答から数値的な信号を得る点が、誤答の自然言語批評とは異なる。生成済みの reasoning を条件として損失を計算するのであり、離散的な reasoning 生成過程全体を厳密に微分するという意味ではない (Das ほか 2025年, Section 4)。
図 18 は、生成済みのreasoningから回答損失を計算し、指示トークンへ数値的な信号を戻す経路を示す。
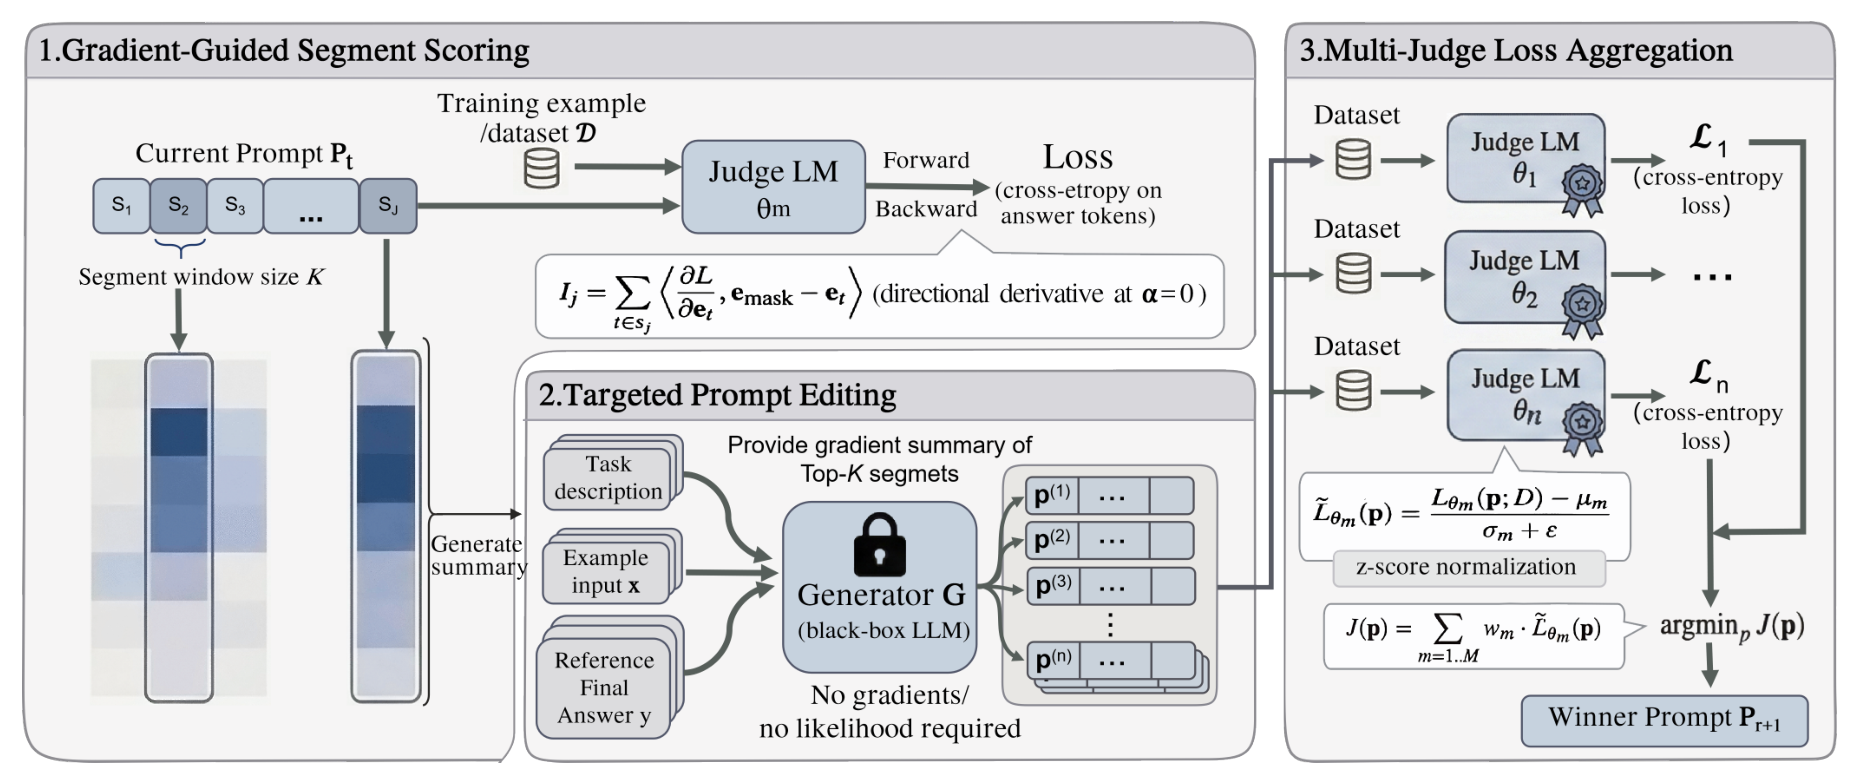
GMPO(Gradient-guided Multi-judge Prompt Optimization)は、指示の区間をマスク埋め込みへ動かした場合の損失変化を一次近似し、勾配から重要な区間を特定する。生成器にその区間の修正を依頼し、複数の軽量な評価モデルの交差エントロピー損失を集約して候補を選ぶ。生成器は閉じた API でもよいが、重要度計算には評価モデルの逆伝播が必要である。LPO と編集範囲を絞る目的は近いものの、その位置を選ぶ信号が異なる (C. Zhao ほか 2026年, Section 3)。
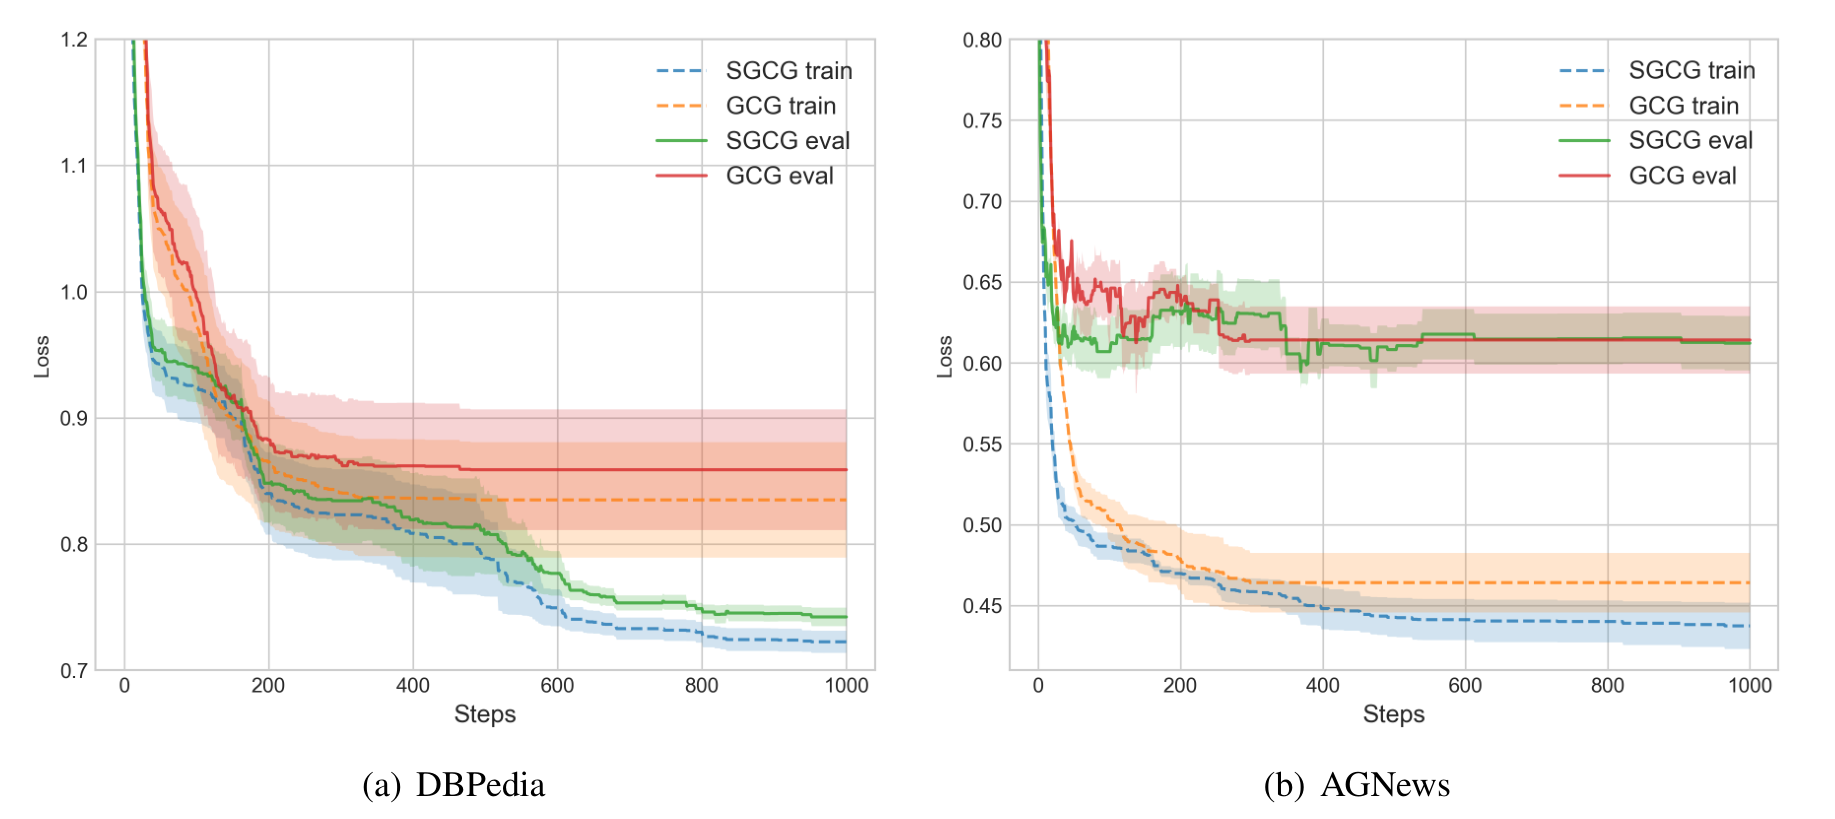
SGCG は、離散トークンを選ぶ分布とサンプリングを連続表現で扱い、勾配更新と貪欲な候補選択を組み合わせる。順伝播では離散選択を行い、逆伝播では代理勾配を使う。代理勾配とは、そのままでは微分できない離散選択を、逆伝播時には微分可能な連続表現で近似して得る更新信号であり、離散操作そのものの厳密な微分ではない。さらに、直近の損失を保持する移動窓を使って更新の採否を判定する。対象は分類やテキスト攻撃であり、LLM が読める批評を書いて指示を修正する探索とは、探索表現も実験課題も異なる (Y. Wang ほか 2025年, Section 3)。
以上の三手法は、数値勾配を得るモデルへの内部アクセスを要する。ただし、モデル重みの微調整ではなく、指示のトークンやその探索表現を更新する点は共通する。一方、複数のモデル呼出しを含むプログラムでは、どの指示を変えるかだけでなく、各段階の例示や相互作用も選ばなければならない。DSPy、MIPRO、GEPA によるその拡張は、複数モジュールの最適化で扱う。
プロンプト探索の違いは、流暢な修正文を生成できるかだけにはない。候補の範囲、誤りから得る信号、例示との組合せ、評価予算の配分が、最終的に選ばれる指示を左右する。未解決なのは、これらを同じ課題モデルと総予算の下で比較したとき、どの仕組みが未知の問題への改善を最も安定してもたらすかである。
図版クレジット
Figure 2: (Pryzant ほか 2023年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 3: (Ye ほか 2024年)。原図公刊版、Figure 3。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (Jain と Chowdhary 2025年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 1: (Fernando ほか 2024年)。原図公刊版、Figure 1。CC BY 4.0。原図の図部分を切り抜き。
Figure 2: (J. Wang ほか 2025年)。原図公刊版、Figure 2。CC BY 4.0。原図の図部分を切り抜き。
Figure 3: (Wan ほか 2024年)。原図公刊版、Figure 3。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 4: (Agarwal ほか 2025年)。原図公刊版、Figure 4。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 1: (Schneider ほか 2025年)。原図公刊版、Figure 1。CC BY 4.0。原図の図部分を切り抜き。
Figure 1: (Nag ほか 2025年)。原図公刊版、Figure 1。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 4: (Xiang ほか 2025年)。原図公刊版、Figure 4。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (Kim ほか 2025年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (C. Zhao ほか 2026年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 1: (Y. Wang ほか 2025年)。原図公刊版、Figure 1。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 3: (Yang ほか 2024年)。出典: 原論文PDF、Figure 3。原図の領域を切り出してPNG化。
Figure 1: (Zhou ほか 2023年)。出典: 原論文PDF、Figure 1。原図の領域を切り出してPNG化。
Figure 3: (X. Wang ほか 2024年)。出典: 原論文PDF、Figure 3。原図の領域を切り出してPNG化。
Figure 2: (Guo ほか 2024年)。出典: 原論文PDF、Figure 2。原図の領域を切り出してPNG化。
Figure 3: (Shi ほか 2024年)。出典: 原論文PDF、Figure 3。原図の領域を切り出してPNG化。
Figure 1: (G. Zhao ほか 2025年)。出典: 原論文PDF、Figure 1。原図の領域を切り出してPNG化。
Figure 2: (Das ほか 2025年)。出典: 原論文PDF、Figure 2。原図の領域を切り出してPNG化。