経験の再利用
エージェントが一度解けた仕事を、次も最初から考え直す必要はあるのか。大規模言語モデル(Large Language Model, LLM)の重みを変えなくても、過去の操作記録、失敗から得た注意点、再利用可能な手順を外部に残せば、後続の判断は変えられる。ただし、記録を増やすことと、将来の成績を改善することは同じではない。本章では、経験が何に変換され、どのように更新・選択され、その有用性が何で確かめられているかを整理する。
ここでいうメモリは、後続の実行で参照する外部状態である。会話中の事実を保存するメモリも、仕事の進め方を記したスキルも含む。一方、ハーネス最適化として特に重要なのは、個別の回答ではなく、複数の仕事に再利用される指針や手順が改善される場合である。長期対話の情報検索も、その更新・検索機構を理解する重要な隣接研究であり、評価目的の違いを明示して扱う。
同じ仕事への再挑戦と、別の仕事への経験移転
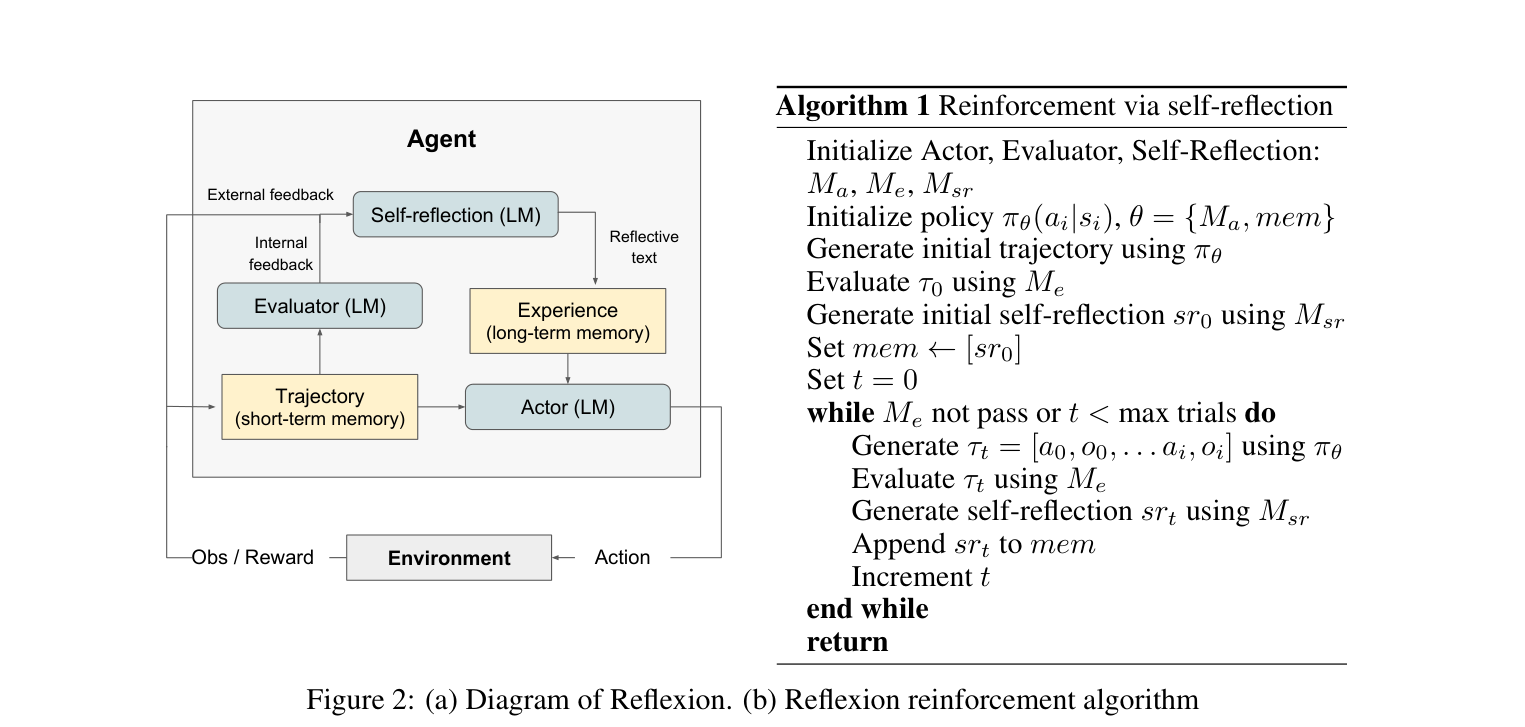
まず、失敗の説明を次の試行へ渡す場合と、複数の仕事から知識を蓄積する場合を分ける必要がある。Reflexionは、環境からの成功・失敗信号や実行結果を自然言語の反省へ変換し、次の試行を条件づける。モデルの重みを更新する強化学習ではない。代表的な評価は同じ問題への複数回の挑戦であり、改善には反省だけでなく再試行の計算も含まれる。このタスク内の改善は有用であるが、それだけで未見タスクに持ち越す共有手順が改善されたとはいえない。(Shinn ほか 2023年)
図 1 のフィードバック循環は同じ課題への次の試行を条件づけるもので、未見課題への移転そのものではない。
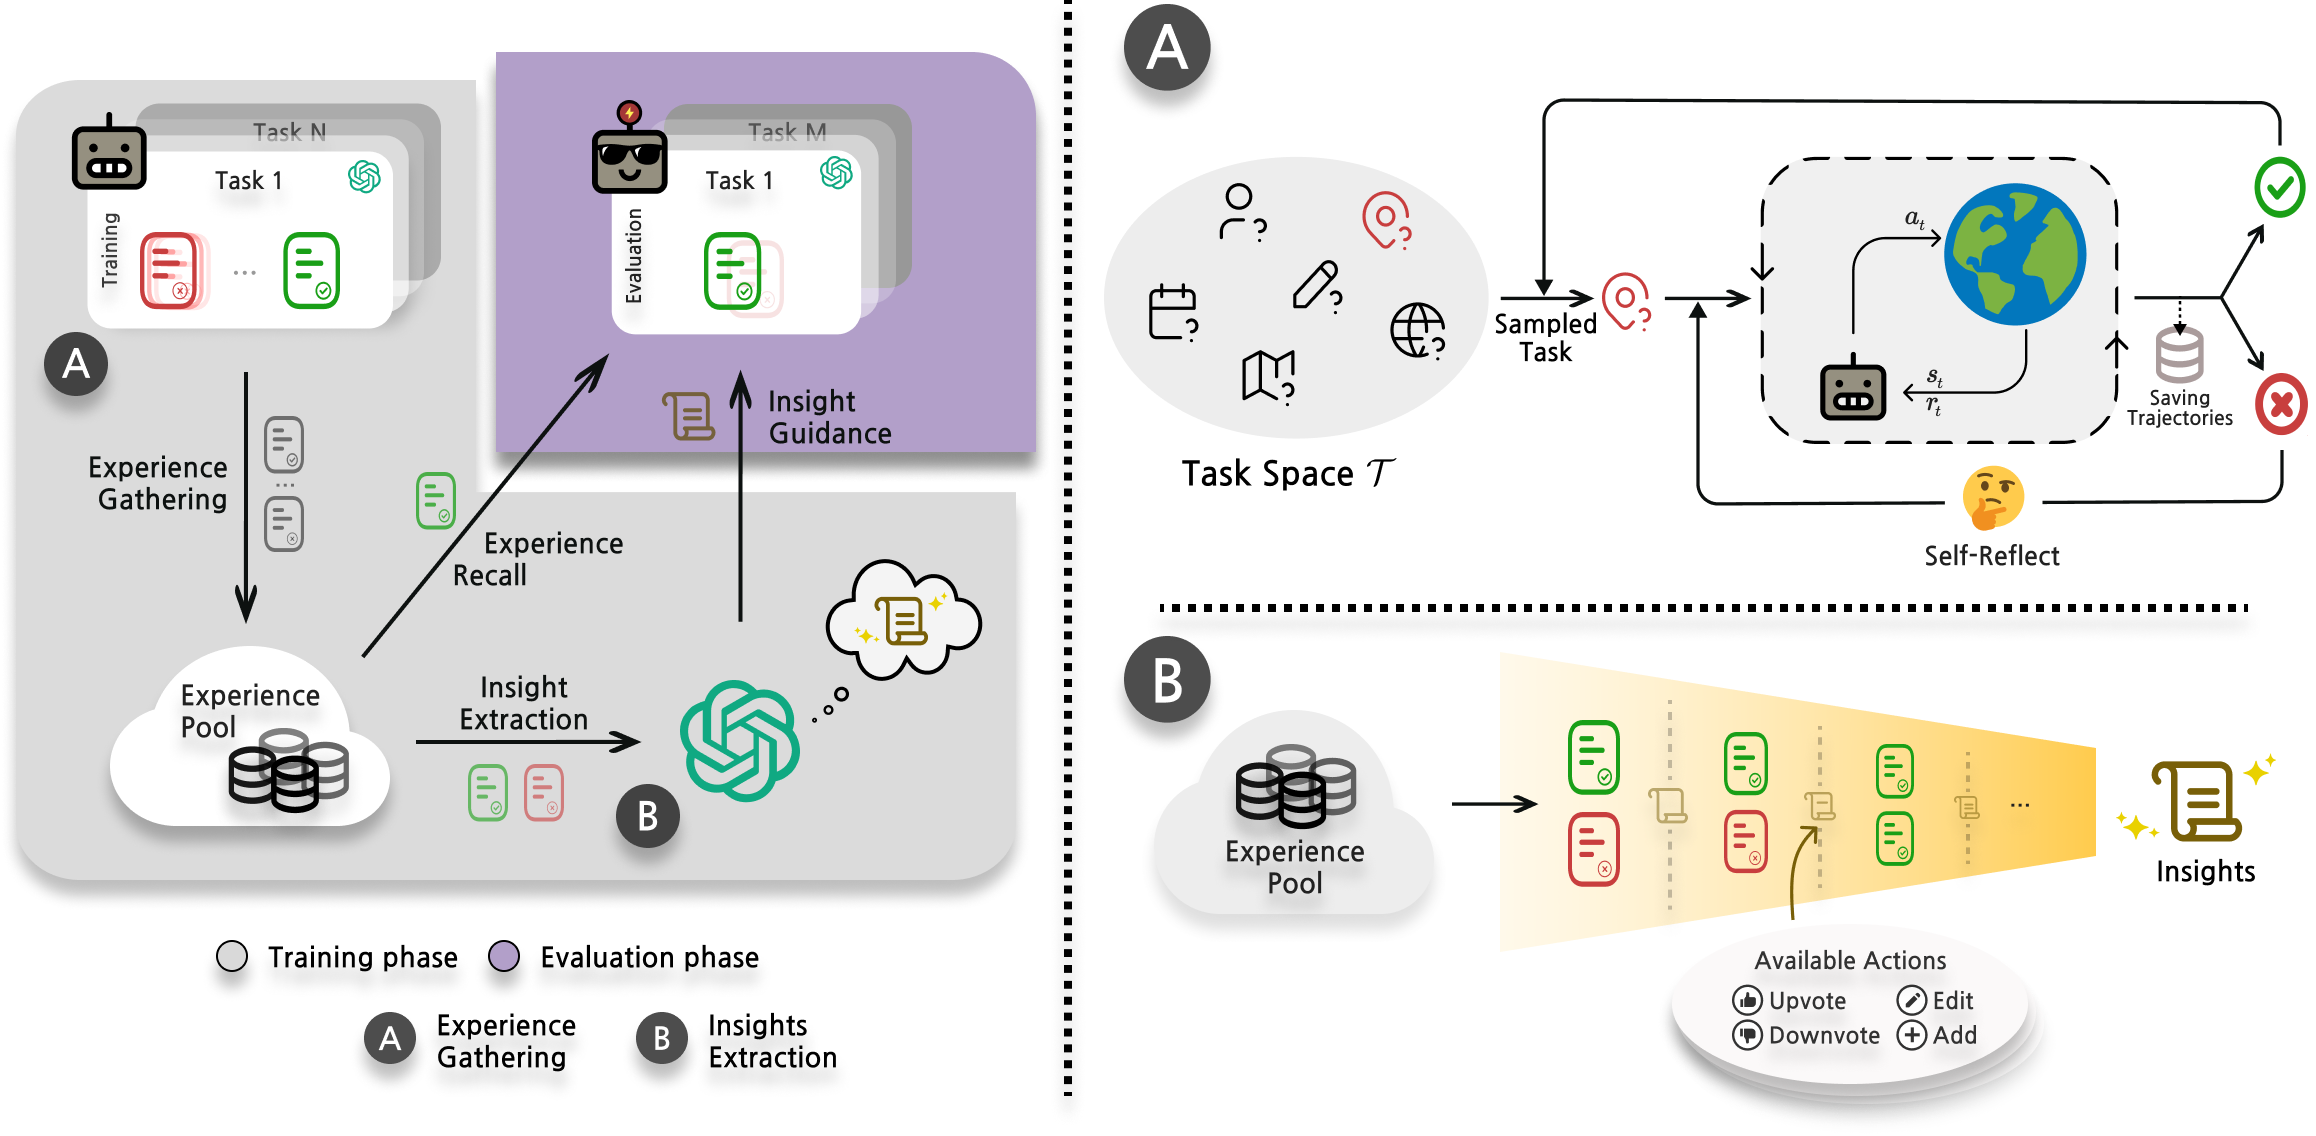
ExpeLでは、訓練タスクで集めた経験を、別のタスクにも使う二つの形へ変える。一つは成功軌跡であり、似た仕事の具体例として検索する。もう一つは洞察であり、成功と失敗の対比や複数の成功例から、行動を導く自然言語の規則を抽出する。評価時には洞察の一覧と、タスク類似度によって検索した上位の成功軌跡を与える。何をしたかを想起する経路と、何に注意すべきかを抽象化する経路は別である。(Zhao ほか 2024年)
洞察は一度生成して固定するだけではない。追加・編集・賛成票・反対票の操作で一覧を更新し、重要度の計数がゼロになった項目を削除する。成功した軌跡にも不要な手順が混ざるため、その一例から得た規則を無条件に永久保存しない設計である。洞察抽出には主にGPT-4-0613を使う一方、評価時に行動するエージェントはGPT-3.5-turbo-0613である。知識を作るモデルと、その知識を利用するモデルも区別されている。(Zhao ほか 2024年)
図 2 は、この二経路と、タスク内の再試行を分けて示す。後続タスクに成功軌跡だけを渡せば事例検索であり、洞察を併用すれば具体例を越えた判断規則も渡せる。
同一論文のALFWorld比較は、この区別を具体化する。4分割検証を用いたGPT-3.5-turbo-0613の評価で、再試行前の成功率はReActが40.3%、成功軌跡の検索だけを用いたExpeLが54.5%、洞察も用いたExpeLが59.0%である。Reflexionによる3回の再試行後は、それぞれ54.4%、60.4%、64.2%となる。検索・洞察の持越しと、同じ仕事への再挑戦は両立するが、同じ改善ではない。この比較は論文Table 2の予備的な再試行実験であり、試行回数を無視して一つの成功率にまとめるべきではない。(Zhao ほか 2024年)
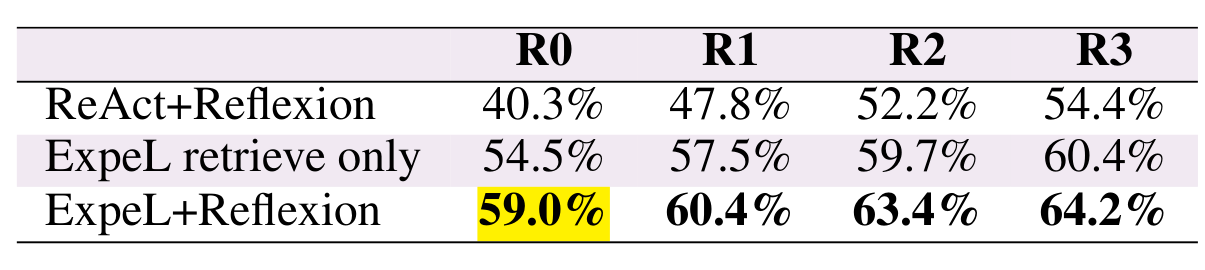
図 3 の行方向の比較は経験の渡し方を、列方向の比較は同じ仕事への追加試行を変えている。したがって、R0 の基準と R3 の完全な ExpeL だけを比べて、差のすべてを洞察の効果と読むことはできない。
軌跡を変数付きの手順へ変える
具体例は細部を保てる反面、注文番号や画面要素など、次の仕事には不要な値まで持ち込む。逆に「よく確認する」という短い洞察だけでは操作順が失われる。中間の表現が、具体値を変数に置き換えた再利用可能なワークフローである。
Agent Workflow Memory(AWM、ICML 2025)は、成功した操作軌跡から、繰り返し使う部分手順を抽出する。図 4 の注文検索では、特定の注文番号への操作を、その番号を変数として受け取る手順へ一般化する。手順は目標の説明に加えて、各段階の環境状態、判断、操作を保持する。単なる成功例のコピーでも、目標だけの短い要約でもない。(Wang ほか 2025年)
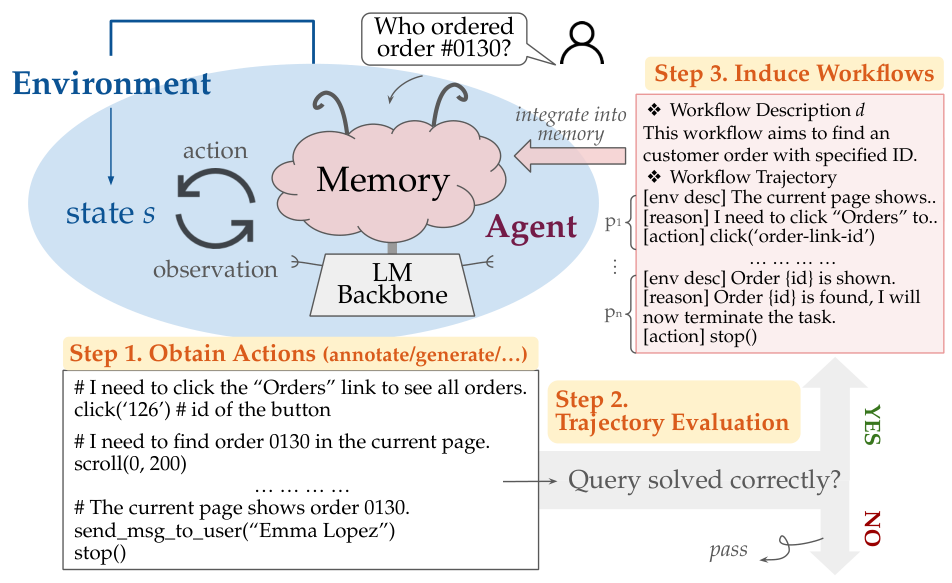
抽出した手順はエージェントの文脈へ追加され、モデルが次の操作を生成する際の指針となる。手順内に操作コードが書かれていても、それを一つの新しいツールとして自動実行する方式とは異なる。また、基本実験ではウェブサイトごとに手順群を管理して関連性を保つ。すべての過去経験から毎回一つの万能スキルを選ぶ、という構成ではない。(Wang ほか 2025年)
AWMには二つの評価設定がある。オフライン設定は訓練例から先に手順を作り、テスト中は同じメモリを使う。オンライン設定はテスト問題を順に処理し、モデル評価器が成功と判定した実行から手順を作って、次の問題へ渡す。後者は正解ラベルを使わないが、成功判定を誤れば不適切な手順も残る。また、後半の問題は前半から得た知識を利用するため、固定メモリによる独立なテストとは評価対象が違う。(Wang ほか 2025年)
同論文内の比較は、抽象化が常に成功率を押し上げるという単純な説明を支持しない。WebArenaでは、具体的な軌跡を規則で抽出・重複除去する方式と、LLMで部分手順を抽象化する方式の成功率はほぼ同じであり、違いは主に手数に現れた。一方、Mind2Webでは要素選択が改善しても、操作の種類を測るF1が低下する場合がある。手順への追従は、現在の画面では別の操作が必要な場面で制約にもなる。(Wang ほか 2025年)
| 同一論文内の条件 | 比較した表現・利用法 | 測定結果 | 読み取れる範囲 |
|---|---|---|---|
| AWM、WebArenaのオンライン評価、本文指定のGPT-4o-2024-05-13 | 規則ベース抽出 / LLMによる抽象化 | 成功率35.6 / 35.5%、平均手数6.3 / 5.9 | 抽象化の成功率優位は示されず、手数との違いがある |
| AWM、Mind2Web cross-task、GPT-4、オフライン | MindAct / AWM | ステップ成功率36.2 / 45.1%、操作F1 60.6 / 57.3 | 総合的なステップ成功の改善と操作F1の低下が併存する |
| Dynamic Cheatsheet、AIME 2024の30問、Claude 3.5 Sonnet、逐次適応 | 指示・ツール利用ありの空メモリ / 累積メモリ / 検索・合成あり | 正答率36.7 / 50.0 / 46.7% | メモリなしの強い基準を越えるが、検索追加が常に最良ではない |
経験の粒度を選び、関係ごと検索する
変数付きの手順でも、再利用できる部分と、今の仕事に合わせて考え直す部分は混在する。MetaFlowLLM(NeurIPS 2025)は、その区別を実行構造へ組み込む。MetaFlowは、ツール呼び出しやコードをそのまま実行する静的ステップと、サブタスクの解決をエージェントへ委ねる動的ステップからなる。両者が共有状態を読み書きしながら処理を進める。AWMの文脈内の手順より、再利用する実行部分が明示的である。(Fan ほか 2025年)
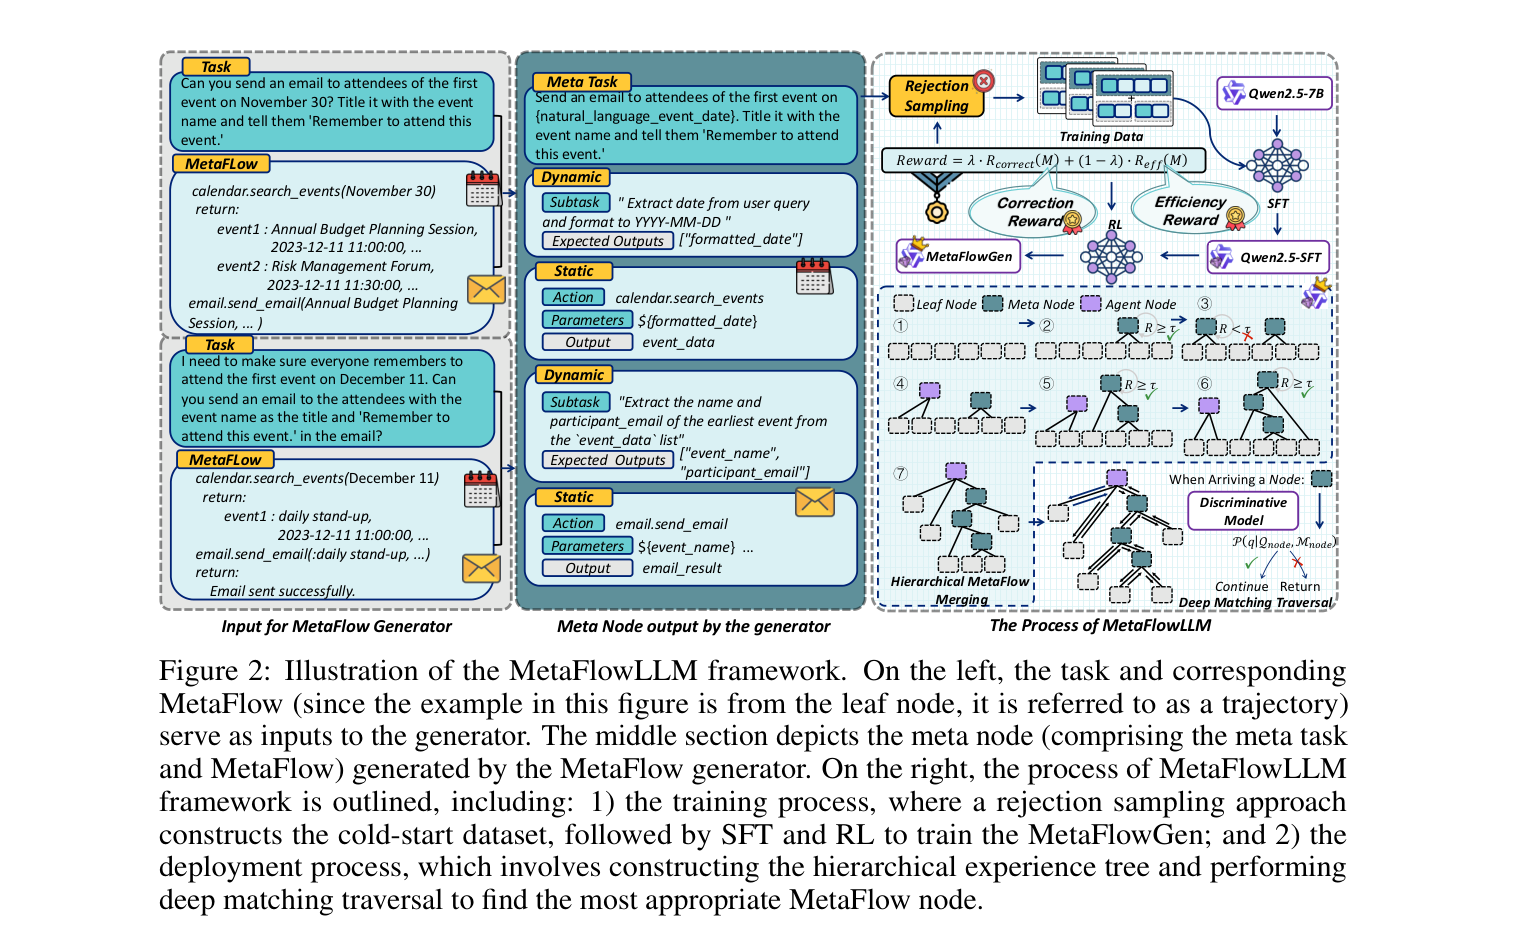
過去の仕事から作る経験木では、葉に近いほど具体的な静的ステップが多く、根に近いほど動的な解決へ委ねる部分が増える。複数のMetaFlowを階層的に併合して木を作り、新しい仕事に対して適合する節点を検索する。最も具体的な経験を常に使うのではなく、適合性を保てる粒度を選ぶのである。AppWorldでは全評価テストを通過するタスク目標達成率、WorkBenchでは正確さに加えて意図しない副作用も評価するため、再利用による効率だけでなく実行結果が問われている。(Fan ほか 2025年)
この手法は生成器MetaFlowGenの重み学習も含むため、全体を「重みを変えないメモリ法」と呼ぶのは不正確である。経験木の表現・検索と、木の節点を作る生成器の訓練は別の層である。生成器の訓練は最適化器の学習で扱う。論文要旨の平均改善32.3%、6.2%は、ここでは単位の異なる実験をまとめる根拠にせず、百分率とポイントを読み替えない。(Fan ほか 2025年)
経験が長い対話や複数エージェントの協働になると、問題は手順の抽象化だけではない。必要な事実や協働上の失敗へ、どの関係をたどって到達するかが重要になる。
A-Mem(NeurIPS 2025)は、新しい対話や相互作用を、内容・時刻・キーワード・タグ・文脈記述を持つノートに変える。埋め込みで近い既存ノートを探して関連を判断し、リンクを作るだけでなく、既存ノートの文脈表現や属性も更新する。検索は、生の履歴ではなく、このように組織化されたメモリを利用する。ここでの主な評価は長期対話からの質問応答であり、操作手順を改善する実験と同一ではないが、書込み時に索引と既存知識を作り直す機構を示している。(Xu ほか 2025年)
図 6 の書込み時の経路は、検索される文脈が類似度検索だけでなくメモリの組織化にも依存することを示す。
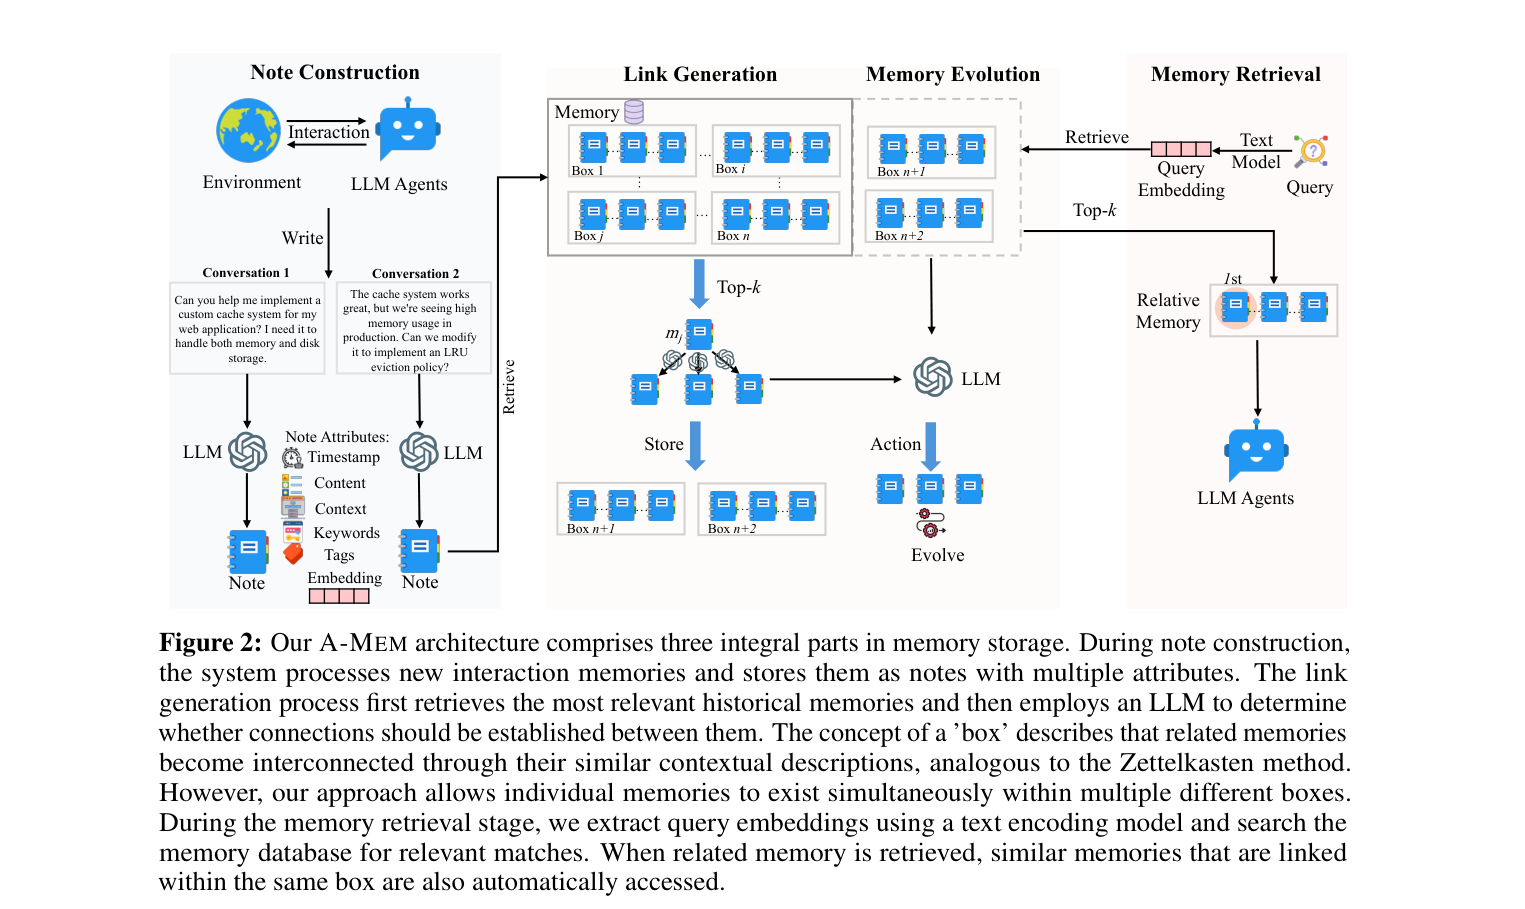
LoCoMoのGPT-4o実験では、A-Memの時間推論F1は39.41で、比較対象のLoCoMo方式は9.09である。一方、単一箇所から答える質問のF1は48.43対61.56であり、すべての質問型で優位ではない。同Table 1の入力トークン長は1,216対16,910だが、これは書込み・ノート更新まで含む総費用ではない。短い検索結果で必要な関係を拾えることと、履歴の情報を一切失わないことは別である。(Xu ほか 2025年)
G-Memory(NeurIPS 2025)は複数エージェントの協働経験を、洞察・クエリ・相互作用という三層のグラフに分ける。新しいクエリから関連する過去のクエリを探し、上へたどって一般的な洞察を、下へたどって必要な相互作用部分を取り出す。完了後には三層を更新するため、結論だけでなく、役割分担や途中のやり取りも後続の協働に渡せる。A-Memがノート間の関係を柔軟に育てるのに対し、こちらは異なる粒度の記憶を階層化して検索する。(G. Zhang ほか 2025年)
図 7 の上向き・下向き走査は、履歴全体ではなく一般的な洞察と必要な相互作用の細部を取り出す仕組みを示す。
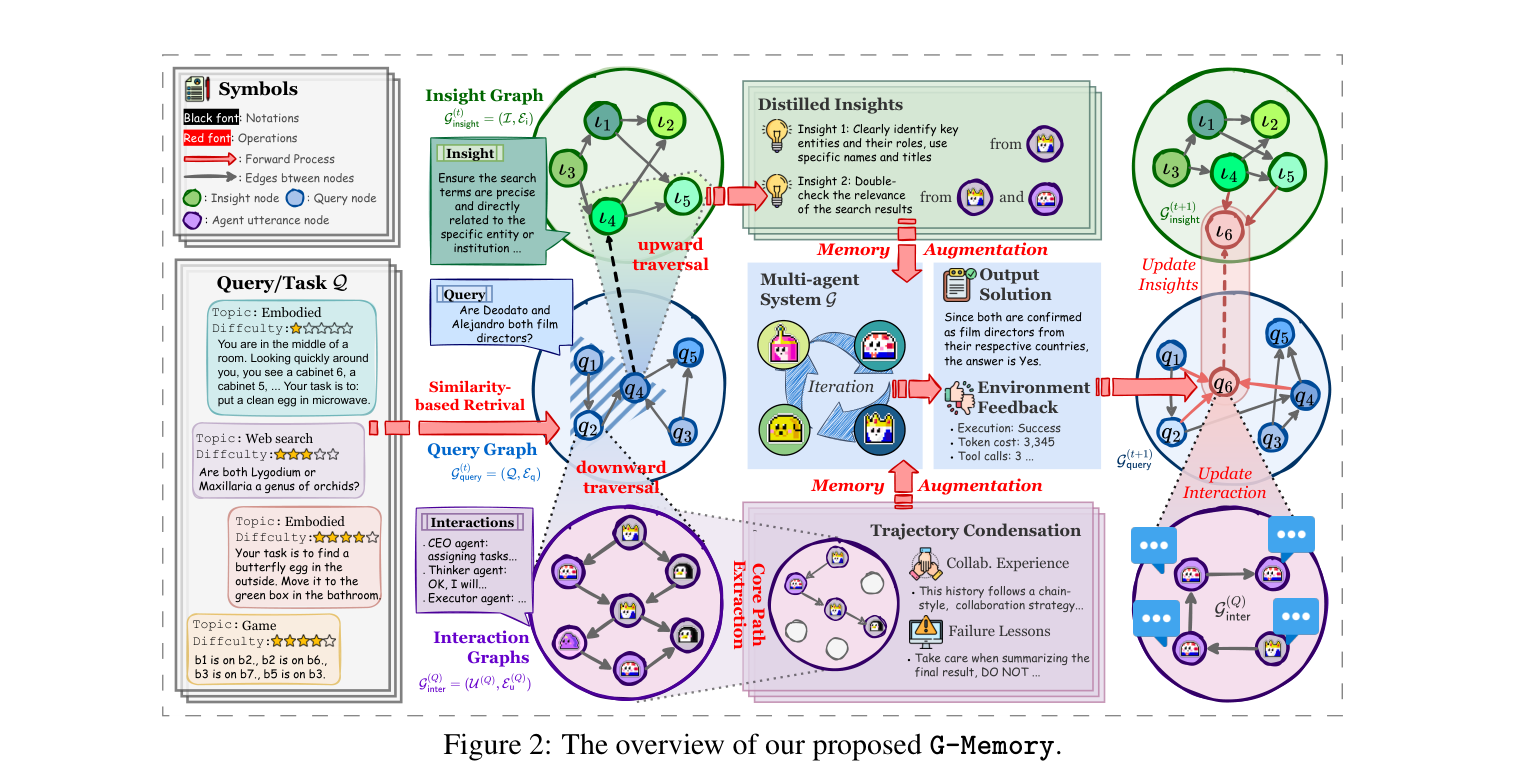
同論文はALFWorld、SciWorld、PDDL、HotpotQA、FEVERを、複数のモデルと協働フレームワークで評価する。たとえばQwen2.5-14BとMacNetのALFWorld成功率は、メモリなしの58.21%からG-Memory使用時の79.10%となる。ただし、これはメモリ構成全体の比較であり、グラフ化だけの効果とはいえない。相互作用の圧縮、役割に応じた提示、洞察の抽出も一緒に変わる。(G. Zhang ほか 2025年)
再計画を省くキャッシュと、解き方を育てるプレイブック
経験の価値は正答率の向上だけではない。同じ種類の計画を何度も高価なモデルに作らせないことも、明確な最適化目標になる。Agentic Plan Caching(APC、NeurIPS 2025)が保存するのは最終回答ではなく、実行計画のテンプレートである。成功実行から不要な推論や個別の値を取り除き、仕事の意図を表すキーワードと組にして保存する。(Q. Zhang ほか 2025年)
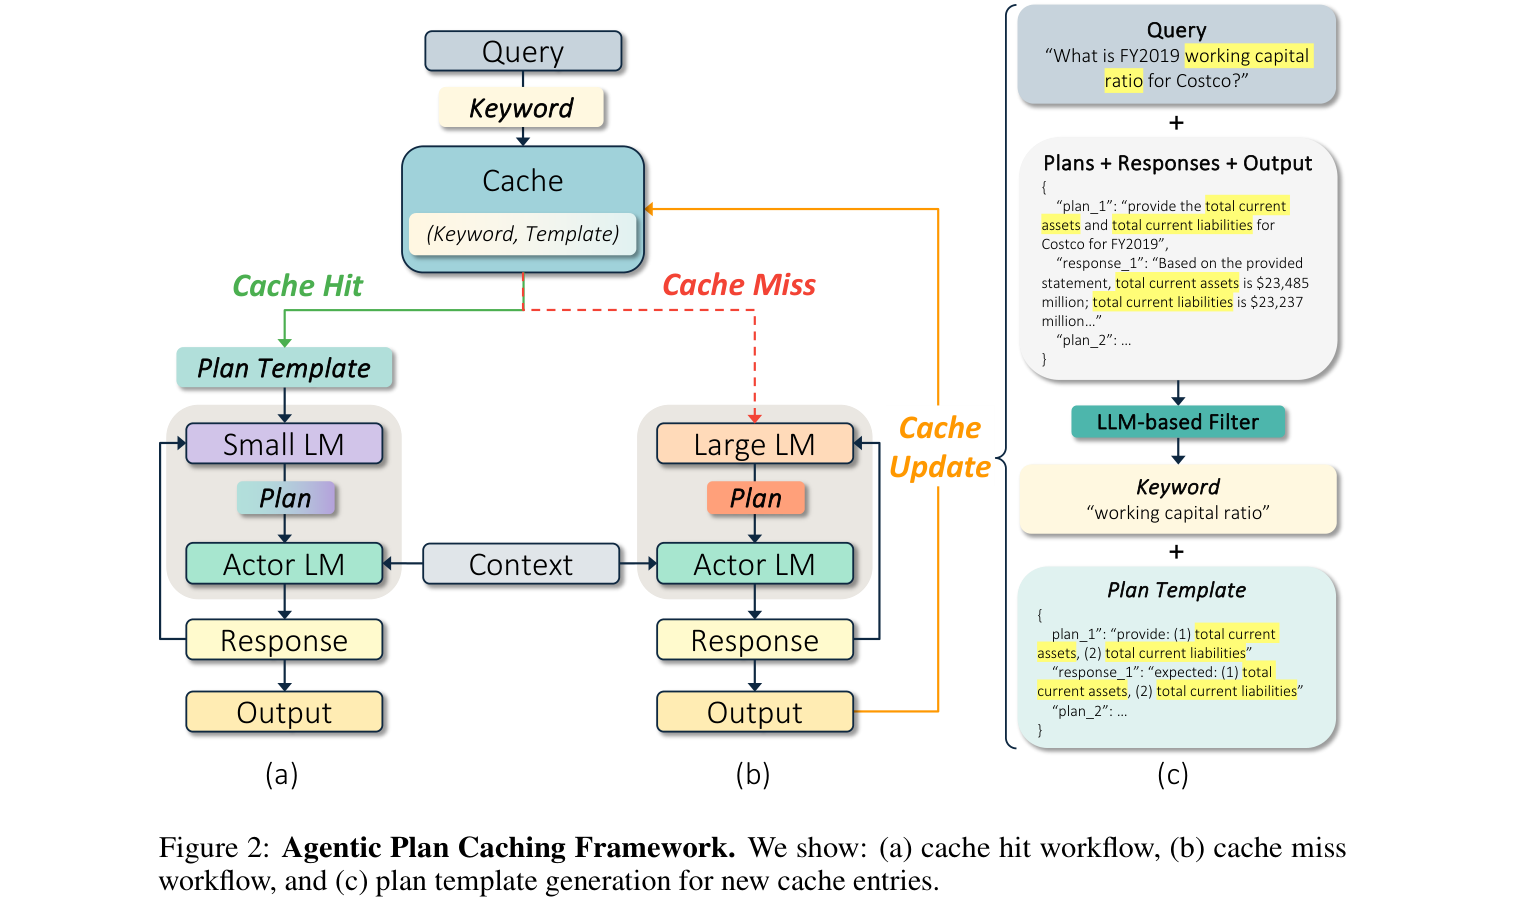
新しい要求では軽量モデルが意図を抽出し、ヒットすればテンプレートを現在のデータや環境に合わせて具体化する。ミスなら大規模な計画モデルが新しい計画を作り、完了後の経験をキャッシュへ戻す。回答の意味的な近さだけで過去の出力を返すキャッシュと違い、計画を再利用しても、対象データから答えを求める処理は残る。(Q. Zhang ほか 2025年)
五つのワークロードでの著者集約値は、費用を平均50.31%、遅延を27.28%削減し、論文の最適精度基準の96.61%を保持したというものである。96.61%は絶対正答率ではなく、基準に対する精度の保持割合であり、精度損失ゼロを意味しない。 メモリを使うことによって何を最大化したいのかを、成功率だけでなく費用・遅延との関係で読む必要がある。(Q. Zhang ほか 2025年)
対して、Dynamic Cheatsheet(EACL 2026)は、問題解決の方略、コード断片、注意点を逐次編集する。累積型のDC-Cuは現在のメモリで解答した後に整理・更新する。検索・合成型のDC-RSは、過去の入出力から関連例を検索し、現在の問題に合わせてメモリを更新してから解答する。整理役は正解ラベルを見ず、保存・修正・削除を判断する。このため、生の全履歴を残す方式とも、過去の事例をそのまま検索する方式とも違う。(Suzgun ほか 2026年)
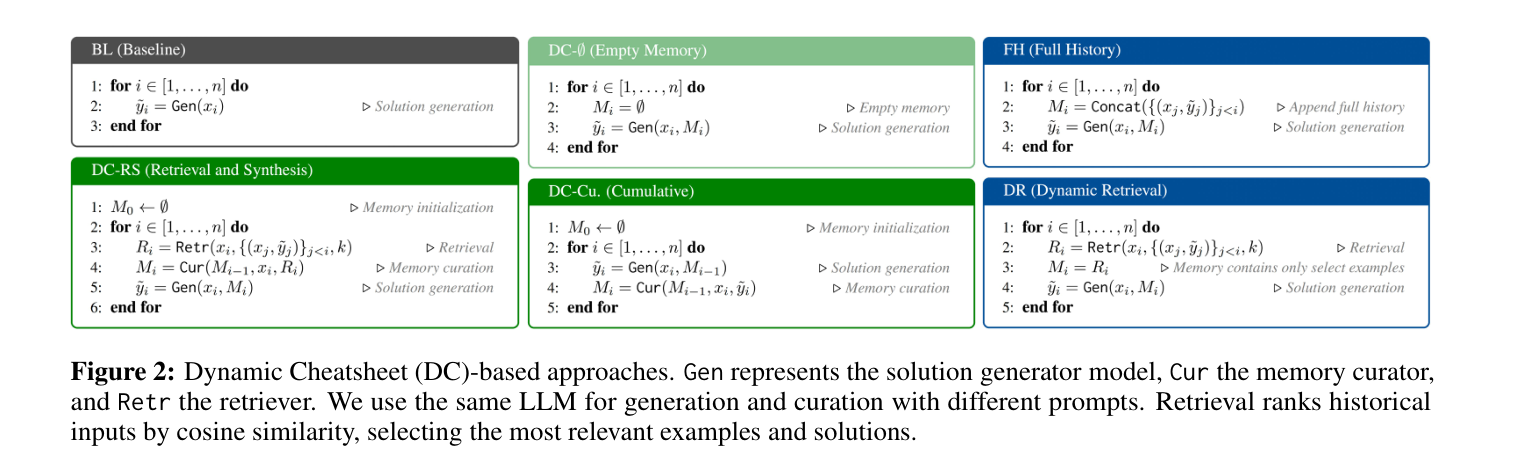
表 1 のAIME結果に加え、GPT-4oのGame of 24では、基本プロンプト10.0%、指示とツール利用を備えた空メモリ19.0%、DC-RS 99.0%という差がある。論文は、途中で得たPython探索手順の保存・再利用を説明している。ただし、すべてをメモリの寄与とするには空メモリ基準との比較が重要であり、AIMEのように累積型が検索型を上回る場合もある。要旨の「9%」などを一律に9ポイントと読み替えるのではなく、各表の条件と値で確認すべきである。(Suzgun ほか 2026年)
ACE(Agentic Context Engineering、ICLR 2026)は、こうした経験知を、詳細な手順と注意点を持つプレイブックとして蓄積する。実行するGenerator、成功・失敗を分析するReflector、知識を統合するCuratorを分け、識別子と有用・有害の計数を持つ項目を差分更新する。全体を書き直す代わりに、項目の追加・局所修正・重複除去を行う。(Q. Zhang ほか 2026年)
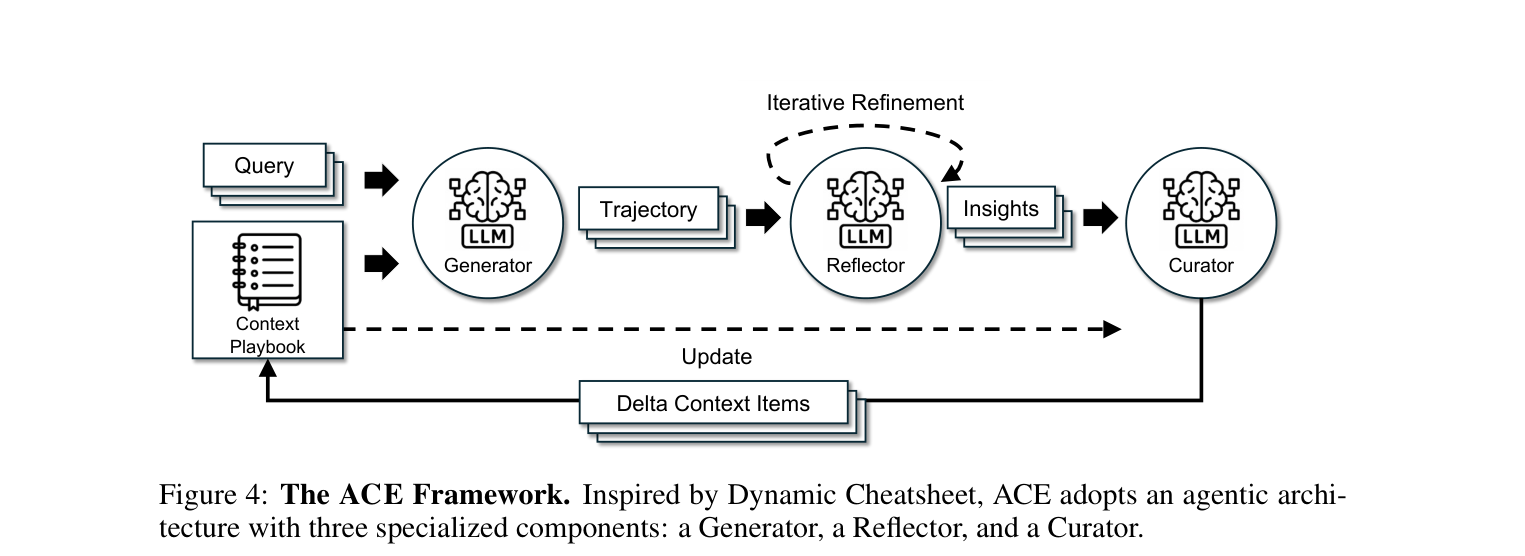
この設計が対処するのは、短くまとめるたびに蓄積した詳細を消してしまう文脈崩壊である。短い要約そのものが悪いのではない。引き継ぐべき具体的な例外や道具の使い方まで、全体の再生成で失うことが問題になる。Dynamic Cheatsheetの選択的な整理も全文保存より有用だが、ACEはさらに更新単位を小さく保つ。(Q. Zhang ほか 2026年)
ただし、更新方式だけで経験の正しさは保証できない。DeepSeek-V3.1を用いたACEの金融分析オンライン実験では、正解ラベルありのFiNER精度は76.7%、ラベルなしでは67.3%で、適応前の70.7%を下回る。一方、Formulaは同じ順で76.5%、78.5%となり、適応前は67.5%である。同Table 2は、同じ更新枠組みでも課題とフィードバックによって効果が反転することを示す。実行成否が観測できる仕事と、誤った説明をもっともらしく保存できてしまう仕事を分けて考える必要がある。(Q. Zhang ほか 2026年)
書込みを、検証された更新へ変えるには
以上の研究で「経験」と呼ばれるものは一様ではない。ExpeLは成功軌跡と洞察、AWMは変数付きの部分手順、MetaFlowLLMは静的・動的処理の階層、A-MemとG-Memoryは関係をたどる記憶、APCは計画テンプレート、Dynamic CheatsheetとACEは編集される解法集を残す。保持する表現によって、更新すべき情報も検索すべき単位も異なる。
ここで区別すべきなのは、メモリへの書込み、その書込みを含むシステム全体の評価、個々の変更を比較して採否を決める最適化の三つである。ノートの属性が変わることや、経験が追加されること自体は、改善を測定した証拠ではない。一方、個々の更新に検証ゲートがなくても、後続タスクでの有用性を評価するメモリ研究には独自の価値がある。
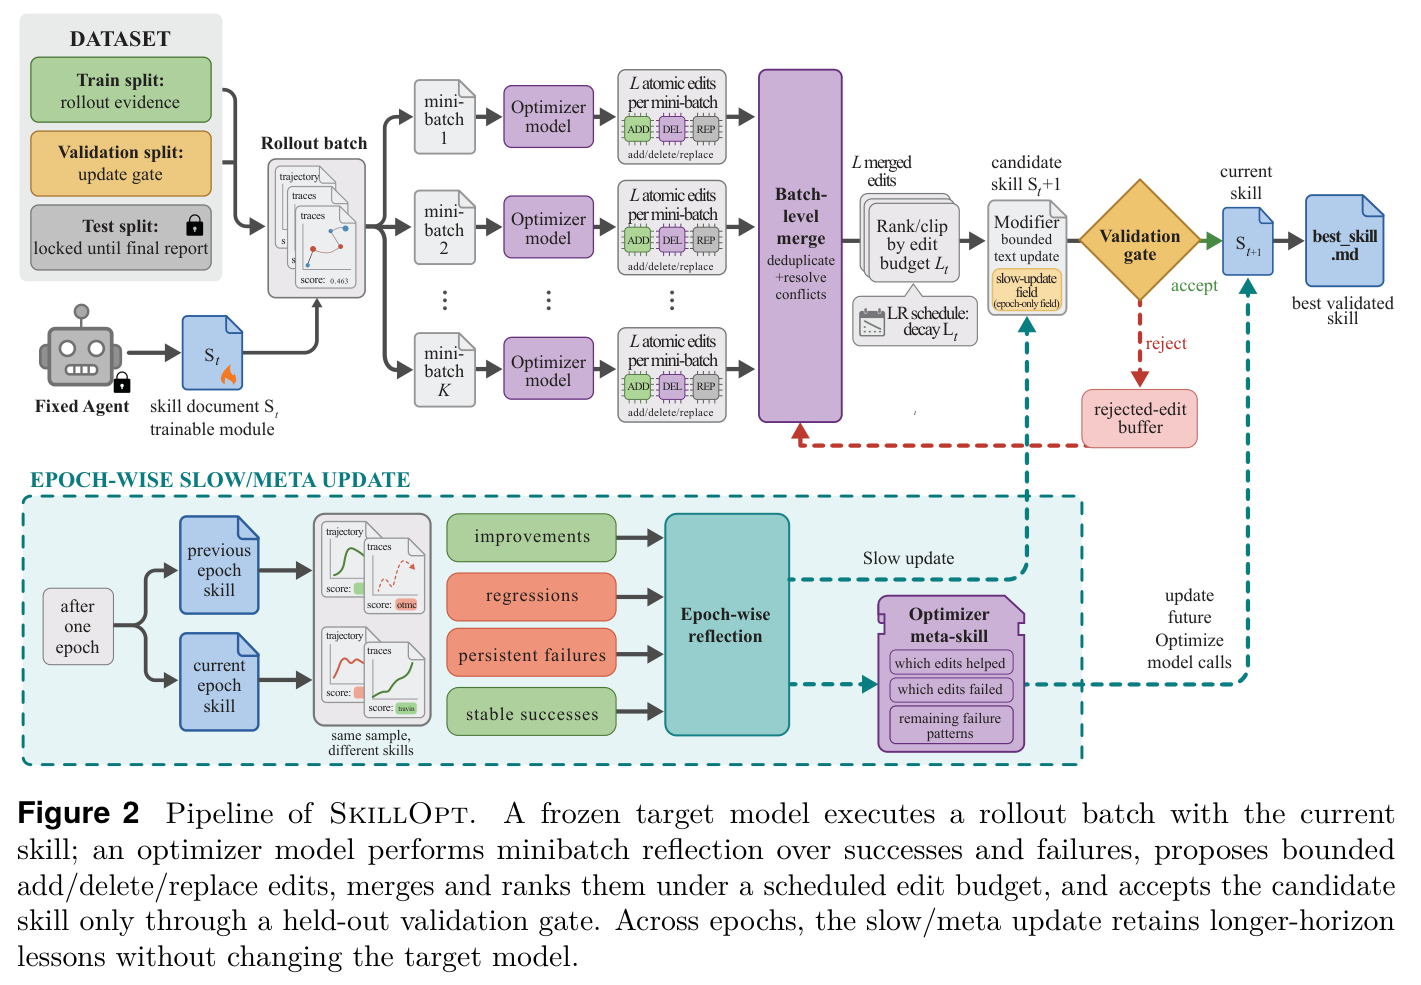
SkillOptは、このうち変更の採否を明示的に扱う2026年のプレプリントである。固定したエージェントの外部スキル文書を対象に、実行記録から追加・削除・置換を提案し、編集量を制限し、別に確保した検証集合のスコアが厳密に改善したときだけ採用する。却下した編集も次の提案への負例として保持する。ここでは「スキルを書いた」ことと「測った上で採用した」ことが分離される。ただし、この検証集合は繰り返し選択に使うものであり、最終的な未見テストと同一視できない。査読済み会議論文と同じ確度で一般化せず、現時点の著者実験として読むべきである。(Yang ほか 2026年)
図 11 のゲートは編集の提案と測定後の採用を分離するが、そのフィードバックは最終テストではなく選択に使われる。
さらに、テスト時学習という語は評価手順の説明を要する。Dynamic CheatsheetやオンラインAWMでは、評価列を処理する間に状態が変わる。各問題の正解を見ていなくても、固定した手順を独立な未見問題に適用する評価とは異なり、問題の順序、初期メモリ、更新回数、整理や検索の追加費用が結果を左右する。ACEもオフライン適応、オンライン適応、事前適応後のオンライン更新を分けて報告する。(Wang ほか 2025年; Suzgun ほか 2026年; Q. Zhang ほか 2026年)
残る科学的な問いは、経験を増やせるかではなく、どの表現と更新単位なら、古い誤りや不要な具体値を持ち越さず、別の仕事でも有用な手順を維持できるかである。その答えには、固定メモリの未見評価と逐次適応の評価を区別し、精度だけでなく検索・整理・再試行を含む費用も測る必要がある。評価設計の比較はハーネスと最適化器の評価で扱う。
図版クレジット
Figure 1: (Zhao ほか 2024年)。原図プレプリント、Figure 1(arXiv 公開版)。CC BY 4.0。原図を縮小。
Table 2: (Zhao ほか 2024年)。原図プレプリント、Table 2(arXiv 公開版)。CC BY 4.0。表本体を切り抜き・ラスタライズ。
Figure 2: (Wang ほか 2025年)。原図公刊版、Figure 2。CC BY-SA 4.0。原図を切り抜き・ラスタライズ。本図の翻案も同ライセンスで提供。
Figure 2: (Fan ほか 2025年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (Q. Zhang ほか 2025年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (Suzgun ほか 2026年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 4: (Q. Zhang ほか 2026年)。原図公刊版、Figure 4。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (Shinn ほか 2023年). 原図: 出典PDF、Figure 2。図の内容を変更せず図領域をラスタライズ。
Figure 2: (Xu ほか 2025年). 原図: 出典PDF、Figure 2。図の内容を変更せず図領域をラスタライズ。 CC BY 4.0.
Figure 2: (G. Zhang ほか 2025年). 原図: 出典PDF、Figure 2。図の内容を変更せず図領域をラスタライズ。
Figure 2: (Yang ほか 2026年). 原図: 出典PDF、Figure 2。図の内容を変更せず図領域をラスタライズ。