複数モジュールの最適化
検索質問を作り、文書を取得し、取得した文書から回答を書く。大規模言語モデル(Large Language Model, LLM)を複数回呼ぶこのシステムで、用意できる正解が最終回答だけだとする。回答が誤ったとき、検索質問の指示を直すべきか、回答生成の指示を直すべきか。それぞれは妥当でも、組合せが悪い可能性はないか。
複数モジュールの共同最適化とは、途中の処理ごとに独立した正解を与える代わりに、システム全体の評価を使って、複数の指示や例示などを調整することである。難しいのは候補を作ることだけではない。最終結果への寄与をどの変更へ割り当てるかという、寄与割当の問題がある。すべての指示を一度に書き換えて得点が上がっても、次にどこを変えるべきかは自明でない。
本章では、変更対象の表現、候補生成、評価と選択の三つを分けて比較する。DSPyとMIPROは、宣言的に記述したモジュールの指示・例示を全体得点から選ぶ。TextGradとTrace/OptoPrimeは、計算の関係や実行記録を修正案へ変換する。GEPAは実行記録への反省と入力別の候補選択を組み合わせる。Optimas、MASPO、TRUCEは、局所的に良い出力や規則と、システム全体に役立つ出力や規則をどう対応させるかをさらに具体化する。
中間の正解を、成功した実行から補えるか
最終回答にしか正解がなくても、システムの途中で何が起きたかは記録できる。検索質問、検索結果、回答の草稿などの入出力を保存し、最終評価を添えれば、それらを次のプロンプトの例示候補に使える。これは人手で中間ラベルを追加する方法とは異なる。
DSPyは、言語モデル(Language Model, LM)の呼び出しを、入力と出力の役割を宣言するシグネチャと、それを使うモジュールとして記述する。たとえば質問と既知の文脈から検索質問を作る処理と、文脈から答えを作る処理を分け、通常のプログラムで接続する。人が固定の長いプロンプト文字列を全段階へ埋め込む代わりに、コンパイラがデータと評価指標に合わせてモジュールを具体化する。ここでいうコンパイルは機械語への変換ではなく、与えられたプログラムの指示・例示などを調整する操作である (Khattab ほか 2024年)。
代表的な方法は、学習入力でプログラムを動かし、最終評価が成功と判定した実行から各モジュールの入出力を取り出すものである。これをブートストラップした例示として蓄え、どの例示集合を各段階へ与えるかを探索する。検索質問そのものの正解は不要である。ただし、最終回答が正しい実行の途中にも冗長な検索や偶然の成功が含まれ得るため、取り出した記録は中間処理の正解証明ではなく候補である (Khattab ほか 2024年; Opsahl-Ong ほか 2024年, sec. 3.1)。
図 1 では、単純化した質問とキーワードによる検索質問が同じプロンプトの例示に含まれ、中間処理の実行を次の入力の手本にする仕組みが分かる。
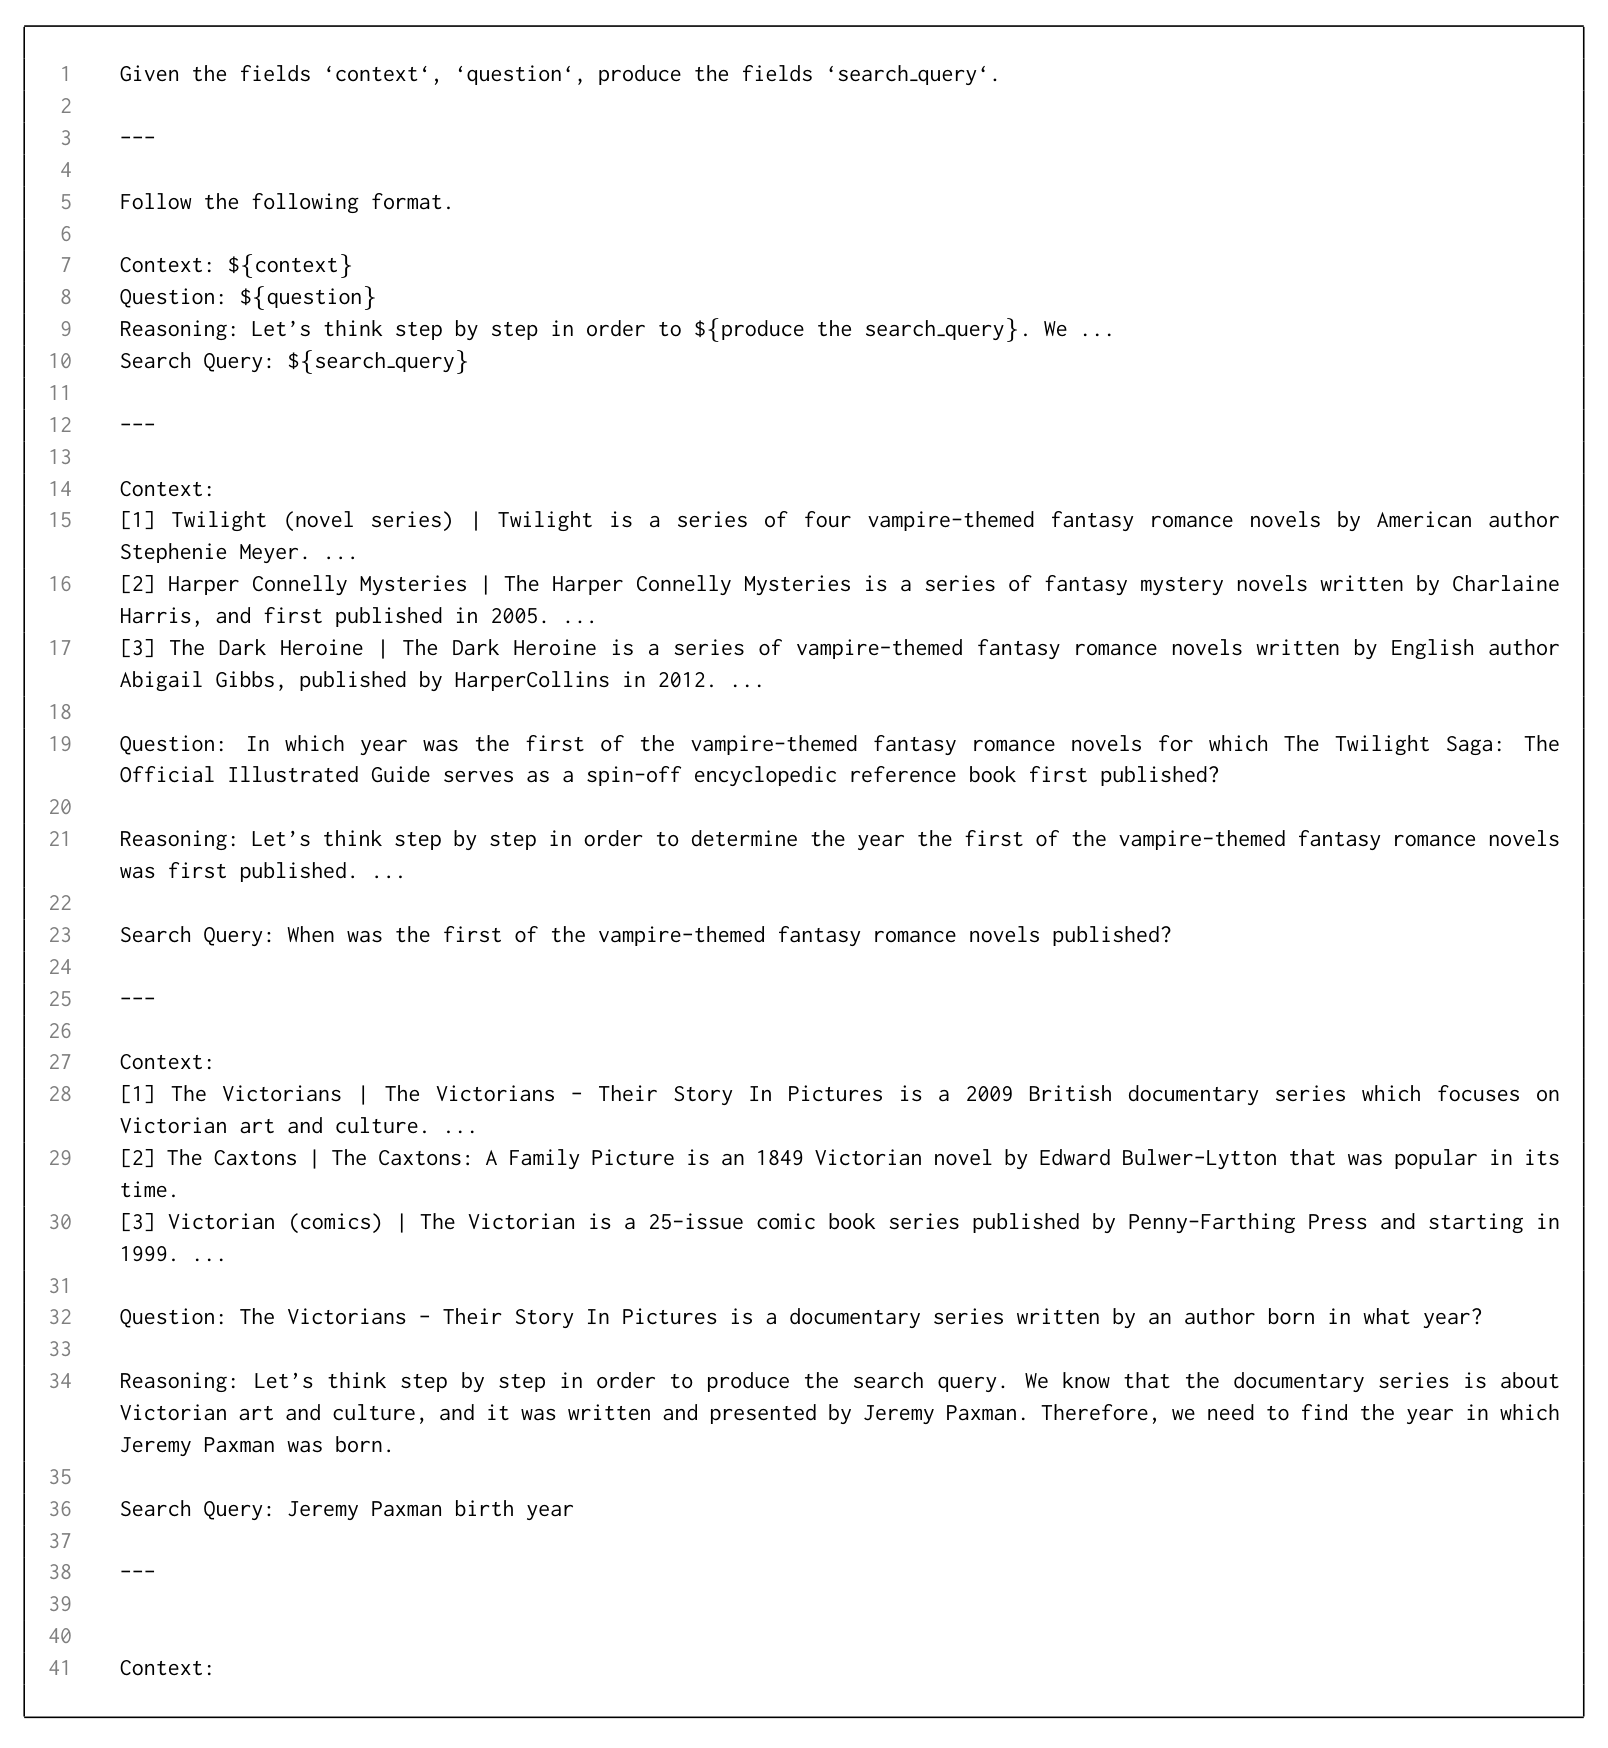
この区別から、DSPyは一つの候補選択アルゴリズムの名称ではないことが分かる。モジュールを表現する仕組みと、それを最適化する手続きを分離する枠組みであり、同じプログラムへ異なる最適化器を適用できる。DSPy原論文が扱う学習範囲には微調整も含まれるが、以下ではまず、対象モデルの重みを固定して指示と例示を選ぶ場合を考える。
指示と例示の組合せを、全体得点で探索する
例示だけを選ぶと、データから示しにくい条件や出力規則を十分に伝えられない場合がある。逆に指示だけを改良しても、具体例によって伝わる振る舞いを失うことがある。そこで、各段階の指示と例示集合を同時に選ぶ問題が生じる。
MIPRO(Multi-prompt Instruction PRoposal Optimizer、EMNLP 2024)は、プログラムの構造を与えたまま、各モジュールの指示と例示を共同最適化する。まず、成功した全体実行から例示候補を作る。次に、データの特徴、プログラムの流れ、成功例などで候補生成用LMを条件付けし、各モジュール向けの指示候補を作る (Opsahl-Ong ほか 2024年, sec. 3–4)。
冒頭の例であれば、検索質問の指示AかB、回答生成の指示CかD、さらに各段階の例示集合を選ぶことになる。この説明用の構成では、候補一つは指示文一本ではなく、複数の選択をまとめたプログラム全体である。ある検索指示が有効かどうかは、回答側の指示と例示にも依存する。
図 2 の下段では、一候補が複数モジュールの指示と例示の組を含むことが分かる。上段の候補生成を終えても、どの組合せを使うかという別の探索が残る。
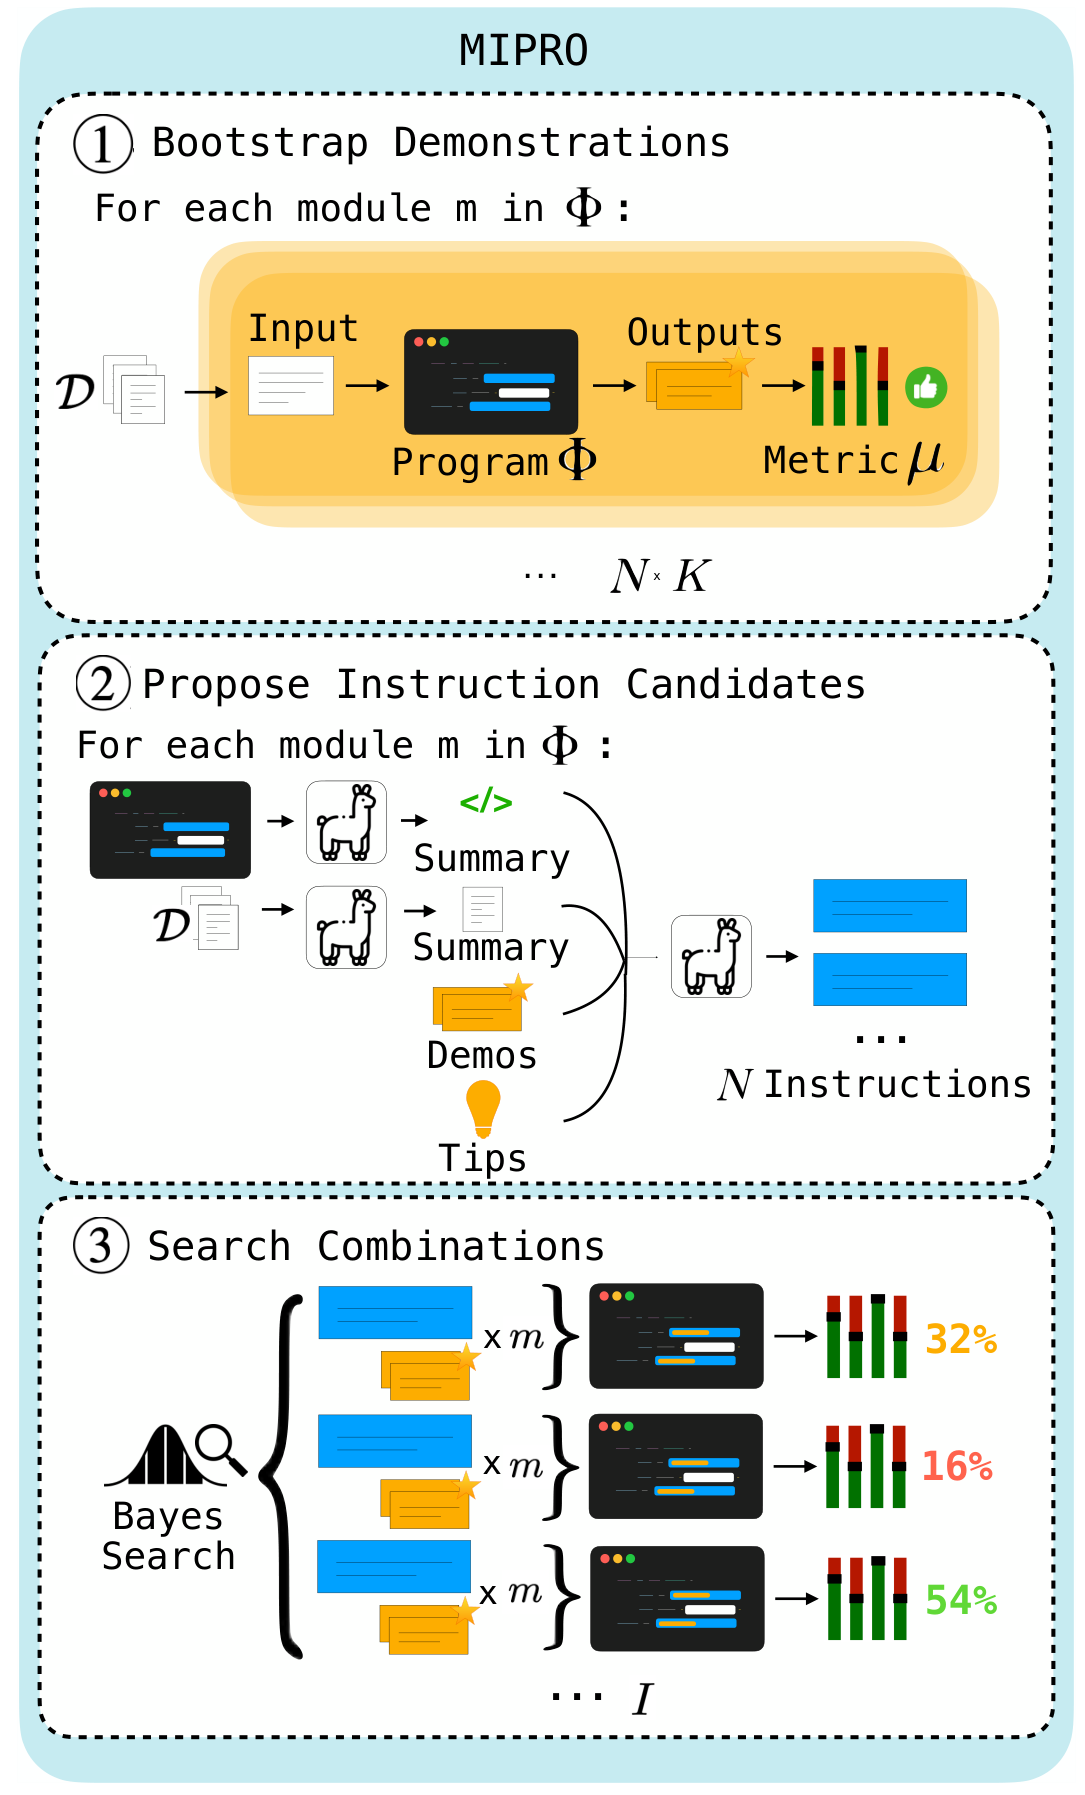
MIPROは、既に試した組合せと最終得点を使って、次に有望な組合せを選ぶ。原論文の代理モデルによる探索は、Optunaの多変量Tree-structured Parzen Estimatorを用いるベイズ最適化である。各選択の共同寄与を評価履歴から扱い、ミニバッチ評価と、定期的な広い評価を組み合わせて探索費用を抑える。ここでいう寄与割当は、誤りの原因を文章で確定する操作ではなく、組合せと得点の関係を学ぶ操作である (Opsahl-Ong ほか 2024年, sec. 3.2, §4.3)。
指示候補をデータや実行に即して作る部分と、その候補の組合せを探索する部分は別である。固定された候補集合の外に解があるなら、代理モデルだけではその新しい指示を発明できない。原論文は候補生成と寄与割当の設計を分け、例示のみ、指示のみ、両方などを比較する。Llama3-8Bによる七つのタスクのうち五つでベースラインを上回るという結果は、この設計全体への証拠であり、指示生成だけへの証拠ではない (Opsahl-Ong ほか 2024年, sec. 5–6)。
また、2024年のMIPRO原論文と、後続のDSPyソフトウェアで使われるMIPROv2は区別する必要がある。後述するGEPA最終版の比較対象はMIPROv2であり、GPT-4.1 Miniでは指示のみの設定と指示・例示を共同探索する設定を分けている。原論文の全条件が、そのまま後続実装の比較へ引き継がれたわけではない (Agrawal ほか 2026年, Table 2, Appendix G.4)。
批評と実行記録を、次の修正へ変える
得点は候補を比較できるが、なぜ失敗したかを直接は説明しない。出力形式の違反、必要な文書の欠落、ツールの例外などを文章で保持すれば、新しい指示を作る材料を増やせる。問題は、そのフィードバックをどの変更可能な変数へ、どの形で渡すかである。
TextGrad(Nature 2025)は、指示や出力などを変数とし、モデルやツールの呼び出しでつながる計算グラフ上で自然言語の批評を伝える。下流から届いた批評に、呼び出しの入力・出力や変数の役割を添え、上流の変数へ向けた改善フィードバックをLMに作らせる。複数の経路から届いた情報を更新対象へ集め、指定した変数を文章として書き換える (Yuksekgonul ほか 2025年, Figs. 1–2)。
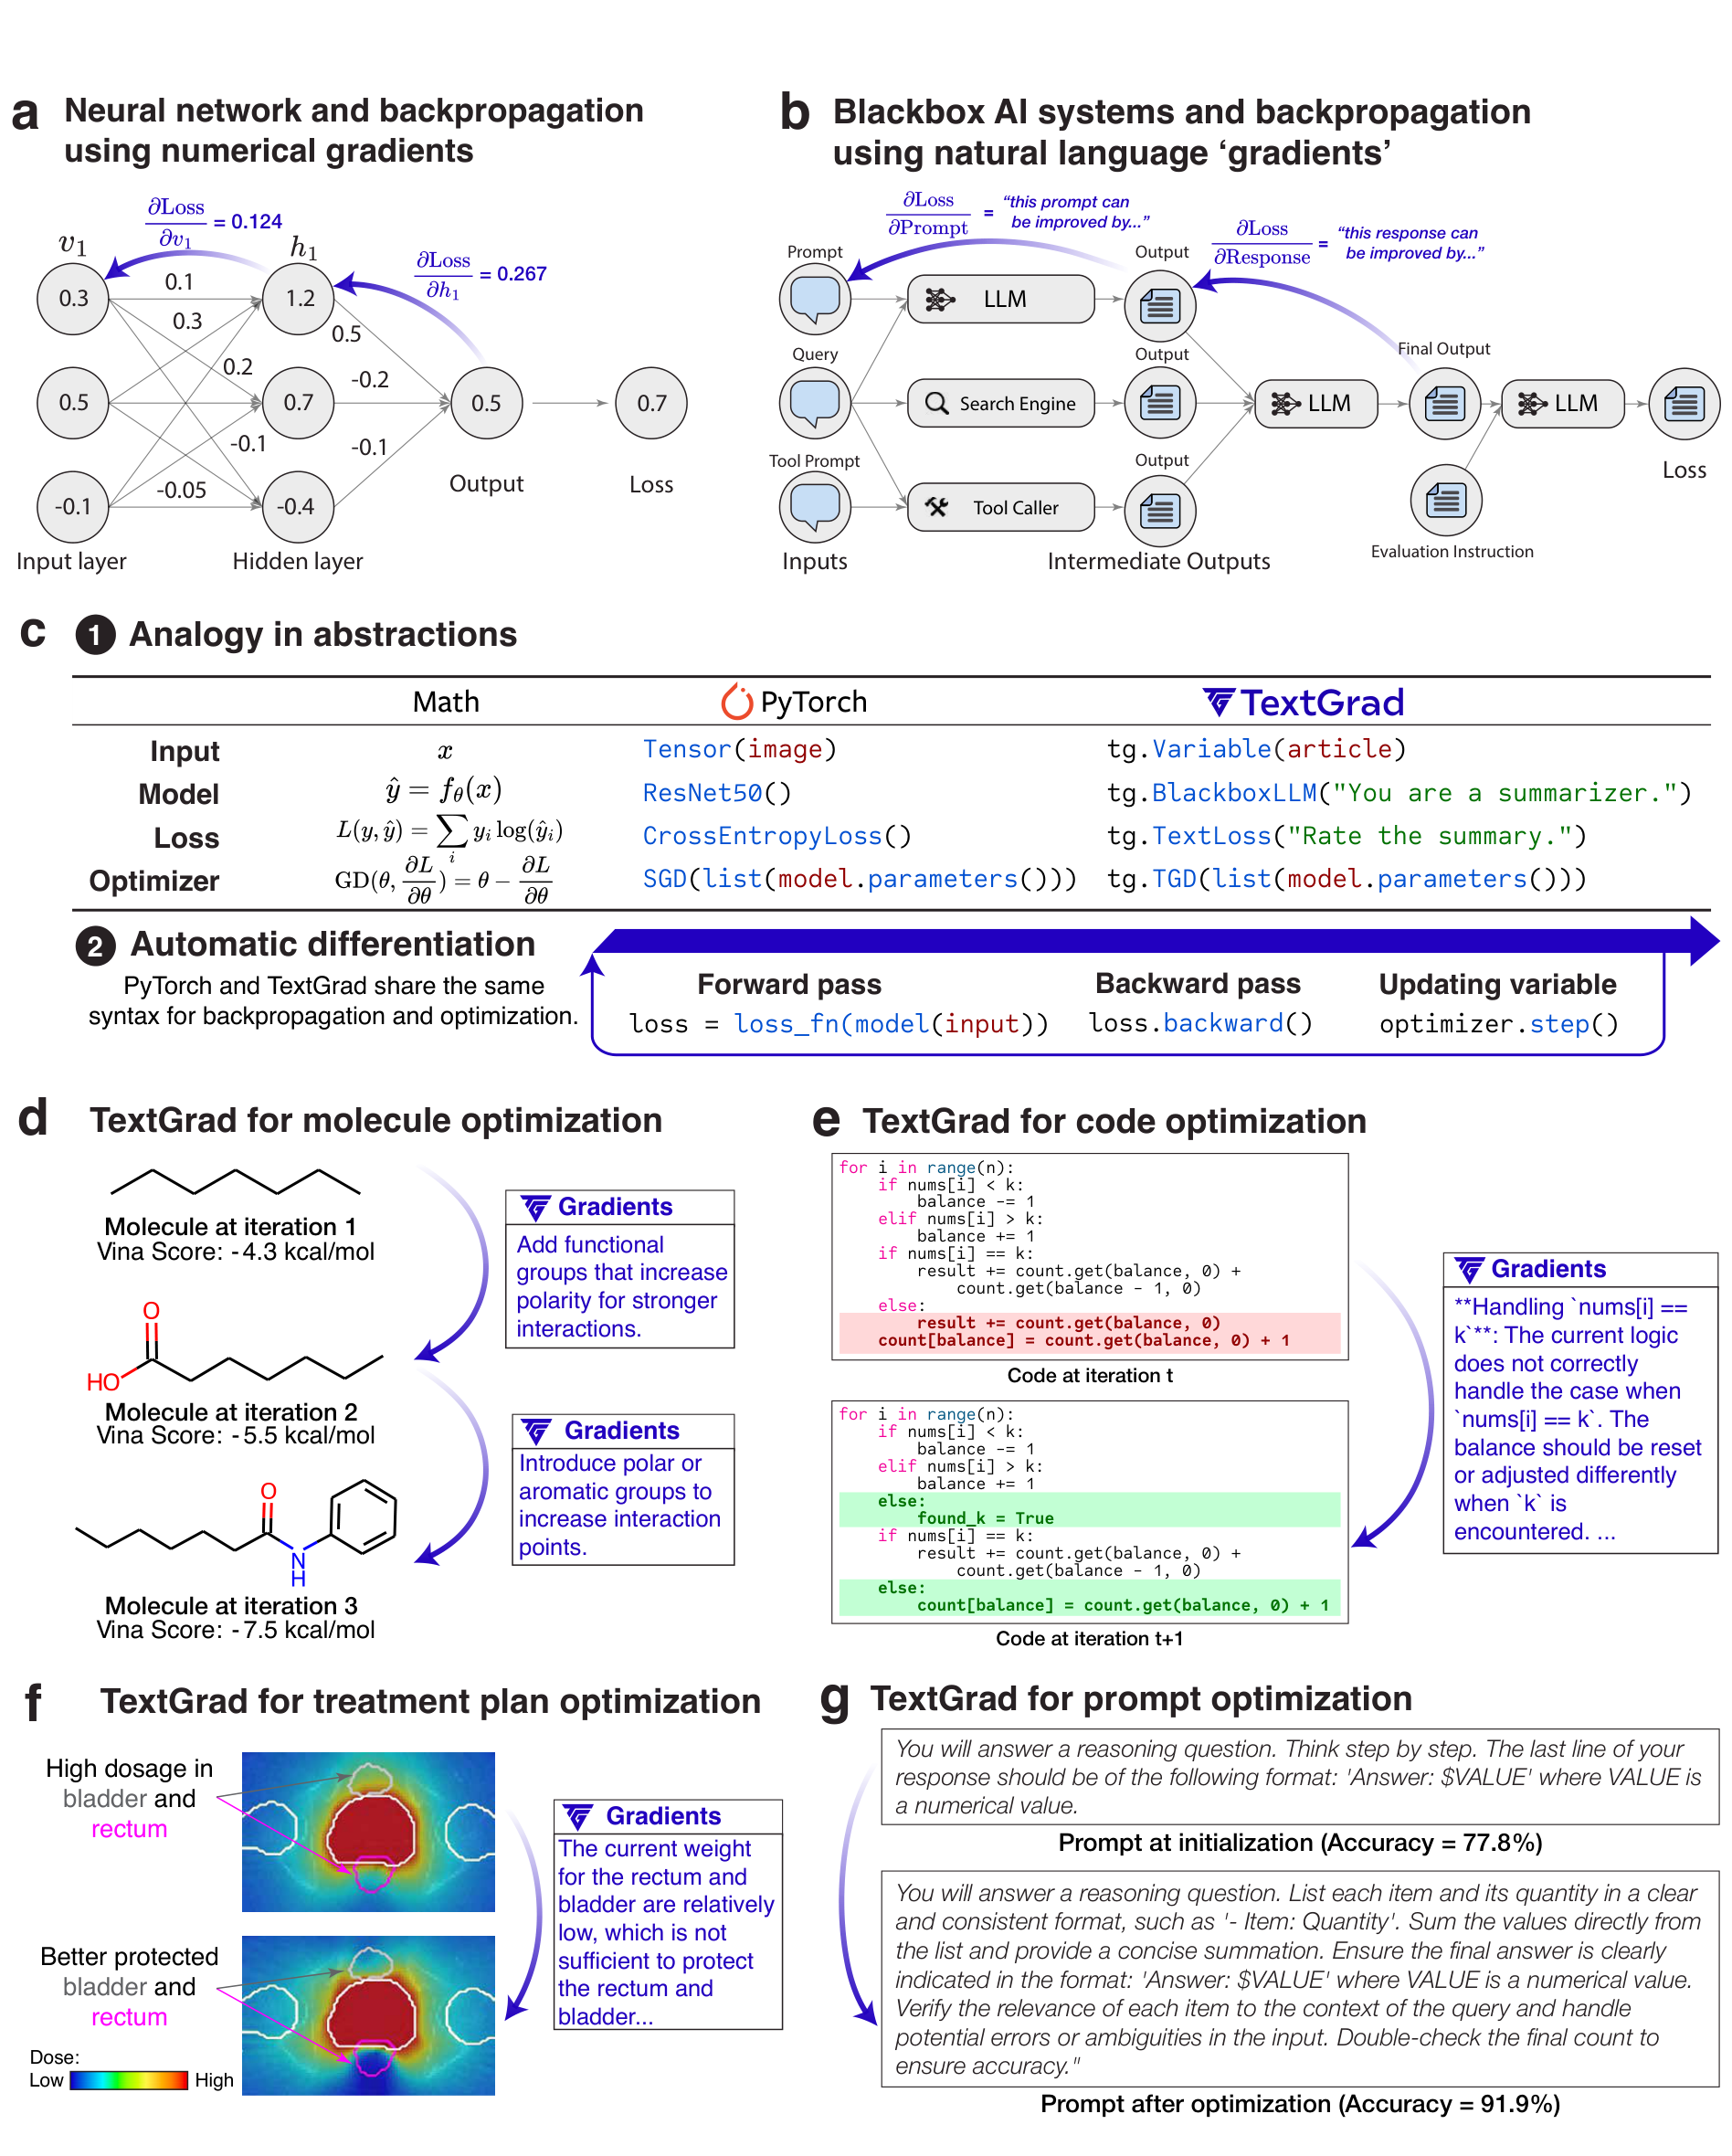
検索・回答の例なら、「答えに根拠がない」という最終出力への批評を、回答の指示だけでなく、検索質問を作る指示へ向けたフィードバックに変換する設計になる。この例は機構の説明である。計算グラフがあるからといって、実際の原因が検索側だと判明したわけではない。
TextGradの「勾配」は自然言語で表した改善情報であり、微分可能な関数の導関数そのものではない。局所的な批評の生成を連ねても、数値の連鎖律による正確な勾配や、原因への正しい寄与割当を計算したことにはならない。この性質は単なる用語上の注意ではない。どの変数に何を伝えるかを、フィードバック生成用LMの推論に依存するという設計上の違いである。
Trace/OptoPrime(NeurIPS 2024)は、同じ計算グラフを異なる形で利用する。Traceは実行を記録し、更新対象からフィードバックを受けた出力までの関係する部分グラフを取り出す枠組みである。OptoPrimeは、その構造、演算の説明、中間値、出力へのフィードバックを、コード実行の報告に似た表現へ直してLMへ渡す。LMはその報告から推論し、変更対象の新しい値を提案する。過去のパラメータとフィードバックの組も、文脈内の履歴として利用できる (Cheng ほか 2024年, sec. 2–4)。
図 4 は、原論文に掲載された小さな計算例の報告である。変更できる変数 x、中間値、演算の説明と「出力を大きくせよ」というフィードバックが同時に渡される。新しい値を実測した成功例ではなく、修正案を作るために何を見せるかの例である。
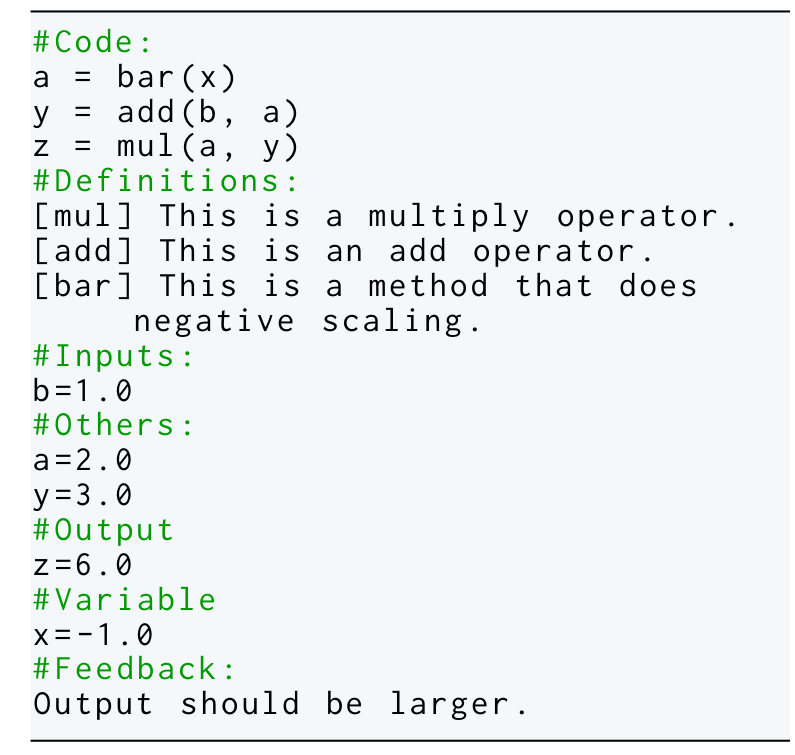
違いは、TextGradが各計算に即した局所フィードバックを上流へ生成するのに対し、OptoPrimeでは関係する実行の部分グラフを修正問題として提示する点にある。Traceの記録は実プログラムの全文ではなく、利用者が指定した演算単位で表した計算の関係である。したがって、記録する単位が、最適化器に見える情報を変える。
さらに、Traceはプロンプト以外も更新対象にできる。原論文のBig-Bench Hard実験は、指示に加えてプロンプト作成関数と回答抽出関数を変更し、指示を調整するDSPyのCOPROと比較する。同じ初期プログラムを使っていても、許される変更が同一ではない。これはコードを含む共同最適化の有効性を調べる実験であり、指示だけの最適化器の優劣を切り離して測った実験ではない (Cheng ほか 2024年, sec. 5.3)。
TextGradにも、その問題の回答・コード・分子などを直接改善する使い方がある。将来の入力に共通して使う指示の更新と、一問の解答を改善する処理は、同じ更新機構でも異なる評価対象である。本章が扱う共同最適化の証拠としては、共通の構成を更新して別の入力で測る設定を中心に読む。
実行記録で編集し、入力別の強みを残す
豊かなフィードバックから良い編集を作れても、編集の出発点を常に平均得点一位に限ると、別の入力にだけ強い候補を捨ててしまう。候補の作り方とは別に、どの候補から次の探索を始めるかが問題になる。
GEPA(Genetic-Pareto、ICLR 2026)は、対象モデルの重みを固定し、モジュールごとのプロンプト集合を進化させる。一つの候補は、システム全体のプロンプトを具体化した構成である。親候補を選び、学習用ミニバッチで実行し、選んだモジュールの実行記録と評価器の文章フィードバックを反省用LMへ渡す。その結果から新しい指示を作り、ミニバッチで改善を確認した候補を、より広い集合で評価して候補プールへ追加する (Agrawal ほか 2026年, sec. 3, Figure 3)。
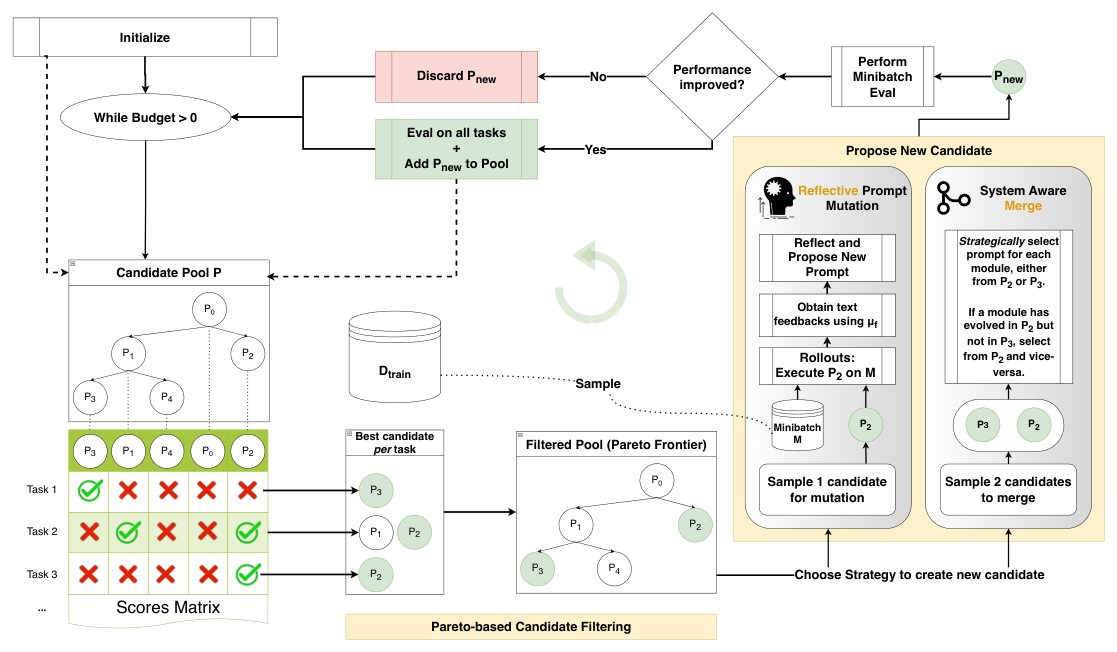
図 5 は、左下の成績行列から読むと選択の意味が分かる。行は評価する個々の入力、列は候補である。図のTask 1を解くのはP3、Task 2を解くのはP1とP2、Task 3を解くのはP2である。P1はTask 2でP2と並ぶだけなので、この例ではP2に対する独自の強みを持たない。右の絞り込み後の候補ではP2とP3が残り、異なる入力での成功を次の編集へ利用できる。
ここでのPareto選択は、入力ごとの得点を軸としている。費用と正確性、安全性と速度のような複数目的の釣合いを直接最適化する仕組みではない。入力別の最高得点を達成する候補と支配関係を使って候補を絞り、各候補が先頭に立つ入力数に応じて確率的に親を選ぶ。全体平均の最高候補だけを残す方法とも、非支配候補をすべて一様に選ぶ方法とも異なる (Agrawal ほか 2026年, sec. 3.1)。
図の右側は、新候補の二つの作り方である。反省による変異では、P2の実行記録と文章フィードバックから指示を修正する。System Aware Mergeでは、共通祖先から異なるモジュールが改良された二候補を使い、モジュールごとに引き継ぐ指示を選ぶ。上部の判定では、新候補がミニバッチで改善しなければ破棄し、改善すれば広い評価へ進める。親の多様性、指示の編集、モジュールの統合、評価の段階化は、それぞれ異なる設計要素である。
最終版では、学習集合の内容とラベルは最適化に使えるが、検証集合の内容への直接アクセスを制限し、検証得点は候補選択などに使う。したがって、反省用LMに失敗内容を見せる経路と、検証得点で候補を選ぶ経路を同一視しない (Agrawal ほか 2026年, sec. 4)。
局所的な良さを、後続処理の成功へ合わせる
途中の検索質問が流暢でも、必要な文書が得られなければ回答には役立たない。複数エージェントでも、一つの発言が単独で妥当であることと、後続エージェントの成功を助けることは異なる。ここを、学習する報酬、候補の共同評価、規則単位の寄与という異なる方法で扱う研究がある。
Optimas(ICLR 2026)は、各コンポーネントの入力と出力から局所得点を返す局所報酬関数(Local Reward Function, LRF)を持つ。局所出力の候補を後続処理へ渡して得た全体報酬から選好データを作り、局所報酬の順位を全体報酬に合わせる。システムが更新されれば、後続処理に役立つ出力も変わるため、報酬関数も少量の新しいデータで適応させる。そのうえで、各コンポーネントに適した最適化器で局所報酬を最大化する (S. Wu ほか 2026年, sec. 4)。
図 6 は、全体報酬に合わせて局所報酬を学ぶ段階と、その報酬でコンポーネントを最適化する段階を分けて示す。
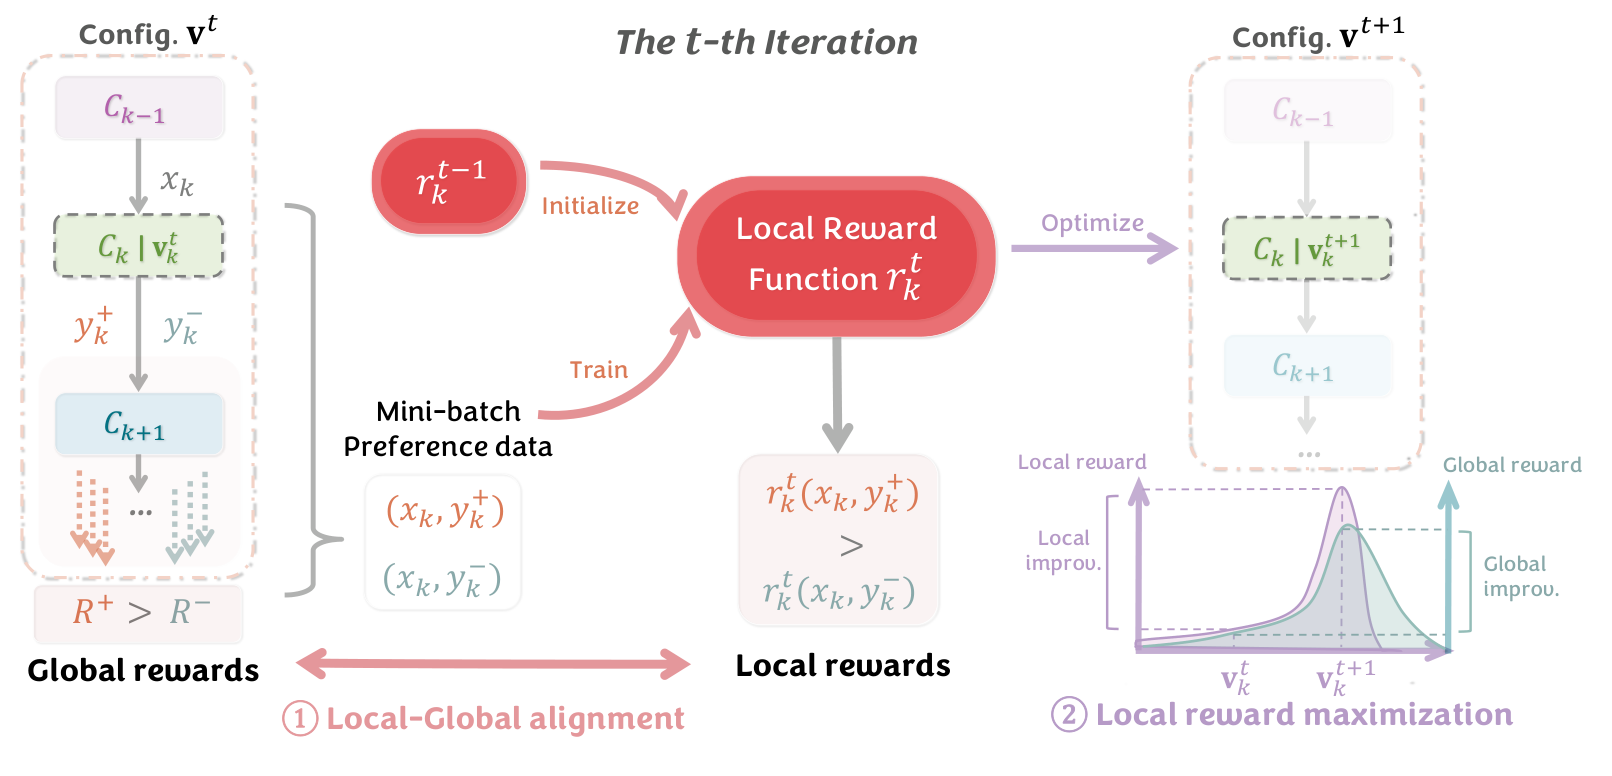
この設計は、最終評価を毎回全体実行で得る代わりに、学習した局所報酬を更新の目的に使うものである。報酬関数は共有LLMとコンポーネント別の出力ヘッドで実装される。TextGradの文章批評とは違い、候補の順位付けに使う数値の関数を学ぶ。
Optimasでは、報酬を推定するモデルの学習と、対象システムのモデル重みの更新も分けなければならない。対象はプロンプト、ハイパーパラメータ、モデル選択、モデル重みを含む。Amazonの推薦システムでは、学習可能な局所モデルを近接方策最適化(Proximal Policy Optimization, PPO)で更新する一方、DSPyとTextGradの比較設定は最終コンポーネントのプロンプトを調整する。したがって、この推薦実験の差を、重み固定のプロンプト探索だけの差とは解釈できない。理論上の収束先も仮定のもとでのコンポーネント単位の極大であり、大域最適解の保証ではない (S. Wu ほか 2026年, sec. 4.4, Appendix G.4)。
MASPO(ICML 2026)は、各エージェントの役割別プロンプトを共同で改善する。中心は、局所的に妥当な出力かどうかだけでなく、後続エージェントの成功を助けるかどうかでプロンプトを評価する共同評価機構である。正解ラベルに依存しない評価を使い、データに基づく進化的ビーム探索で候補を改善する (Wang ほか 2026年)。
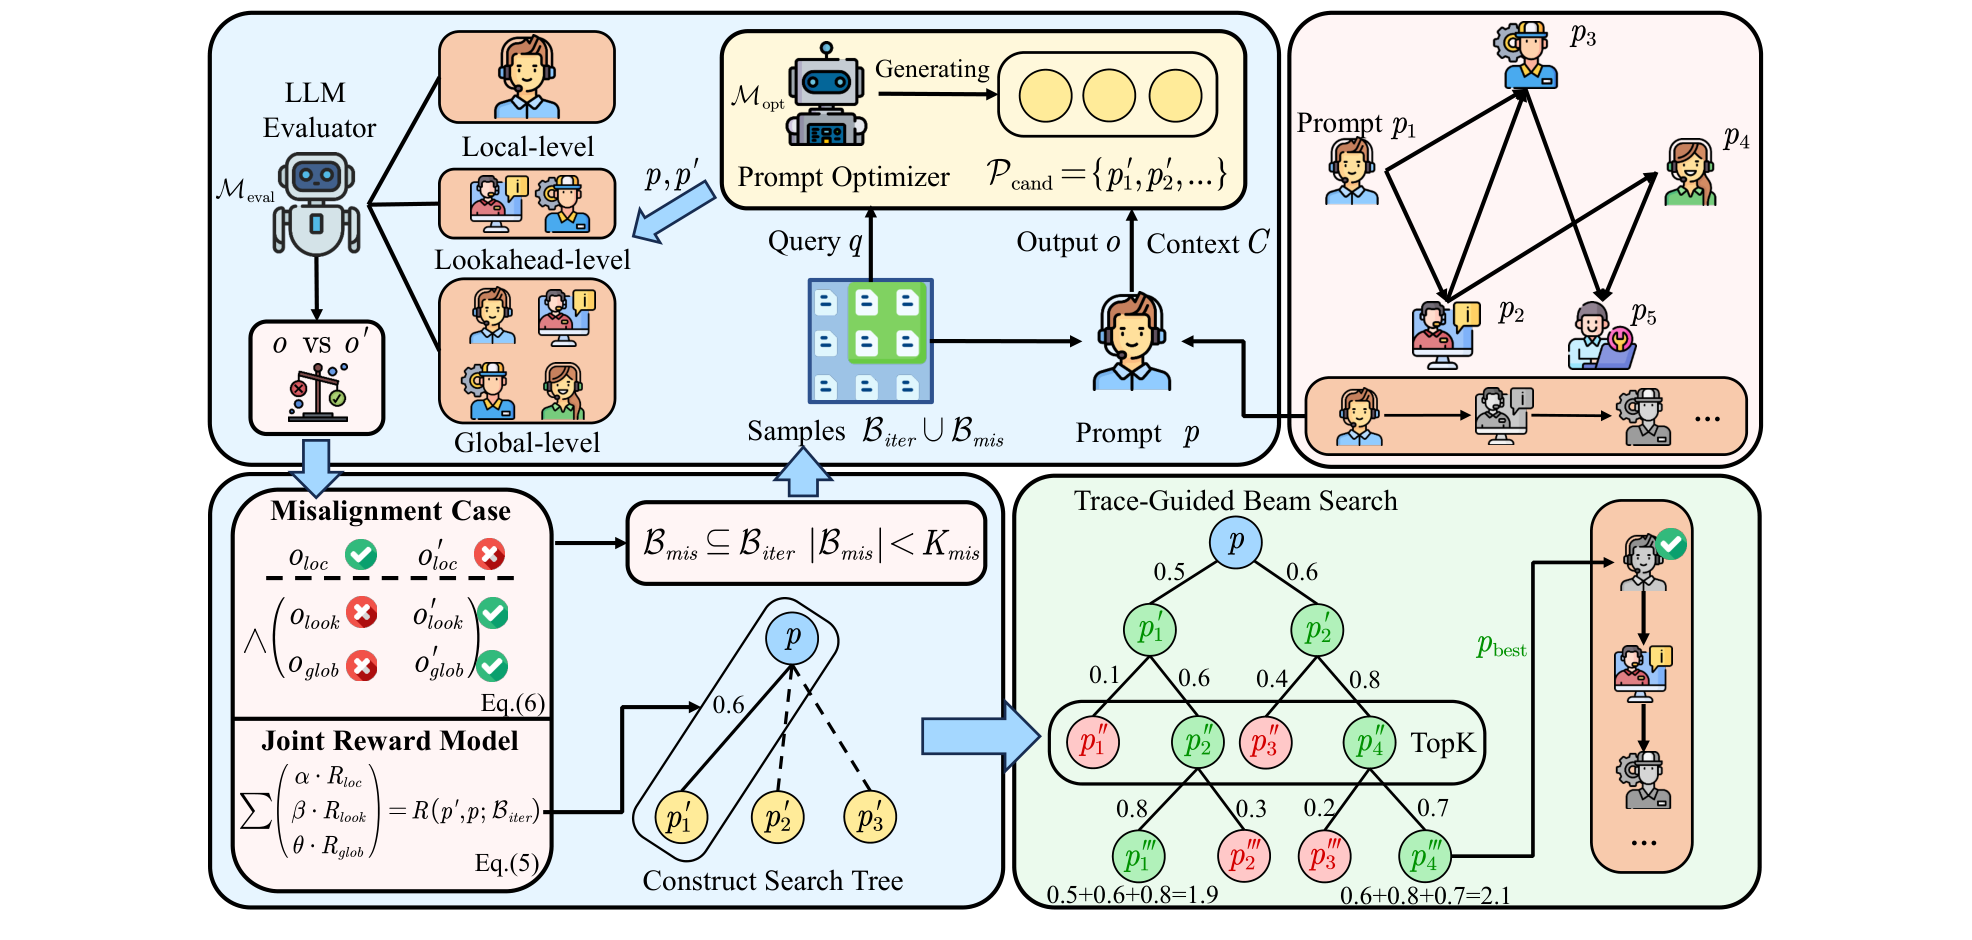
MIPROが全体得点と指示・例示の組合せを対応させるのに対し、MASPOはエージェント間の受渡しを含む良さを候補評価へ入れる。Optimasのように局所報酬関数を学習して異種の設定を更新することと、役割別プロンプトの候補を共同評価して探索することも異なる。六タスクでの著者実験は後者を検証するものであり、中間の正解ラベルを必要としないことを、評価信号自体が不要だという意味に広げてはならない。
TRUCE(Trajectory-based Rule Credit Estimation、ICML 2026)は、さらにプロンプト内の行動規則を更新単位にする。最終結果へのフィードバックを、相互作用の全履歴へ一括して対応させるのではなく、情報量のある部分的な軌跡へ結び付け、その寄与を規則単位の編集へ変換する。複数タスクから得た局所的な更新を集約し、エージェントの役割と相互作用構造を維持したままプロンプトを改良する (B. Wu ほか 2026年)。
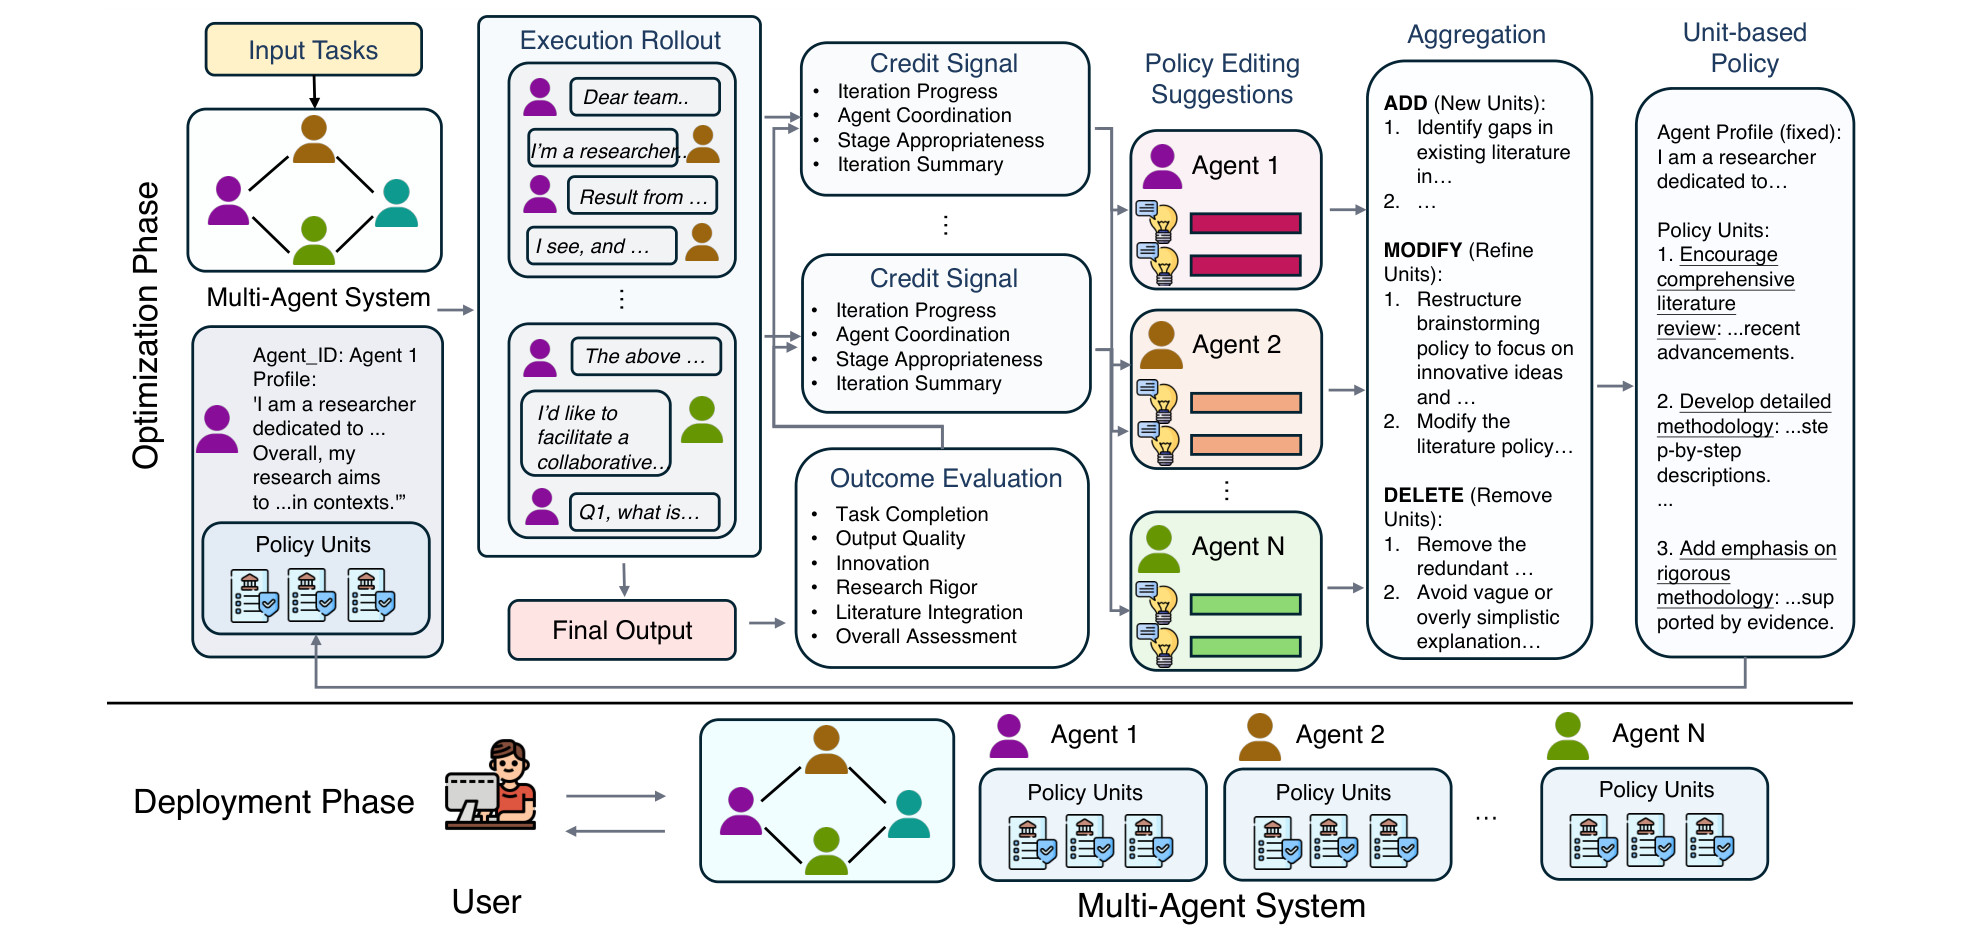
したがって、TRUCEの軌跡利用は、実行記録をそのまま長い批評文へ追加することではない。どの部分軌跡をどの規則へ対応付けるかが設計対象である。MASPOが後続成功を含む候補評価に重点を置くのに対し、TRUCEは結果から編集単位までの対応を細かくする。役割や接続を固定するので、エージェント数や通信構造を探索した結果とは区別できる。
全体の成績と、個別機構の効果を分けて読む
手法全体の比較からは最終性能を、同じ編集手続き内の比較からは候補選択の効果を読む必要がある。GEPAのICLR 2026最終版は、この二種類の比較を含む。表 1 は、同論文のTable 1からQwen3 8Bの三タスクを抜粋したものである (Agrawal ほか 2026年, Table 1)。
| 方法 | HotpotQA | IFBench | AIME-2025 |
|---|---|---|---|
| 初期構成 | 42.33 | 36.90 | 27.33 |
| MIPROv2 | 55.33 | 36.22 | 20.00 |
| GEPA | 62.33 | 38.61 | 32.00 |
| GEPA+Merge | 64.33 | 28.23 | 32.00 |
| GRPO | 43.33 | 35.88 | 38.00 |
各列は異なるタスクの指標であり、列をまたいで同じ量として読まない。GEPAの総最適化予算は、この順に6,871、3,593、1,839ロールアウトであり、GRPOは各24,000である。ロールアウトは一入力のシステム実行と評価の単位で、トークン数、金銭費用、実時間を等しくした比較ではない。GRPO(Group Relative Policy Optimization、グループ相対方策最適化)は対象モデルの重みを更新するので、変更可能な対象も異なる。
この条件ではGEPAは三列ともMIPROv2を上回る。しかしMergeを追加するとHotpotQAは上がり、IFBenchは下がる。AIME-2025ではGRPOがGEPAを上回る。これらの差は、モジュールの統合が常に有利だとも、プロンプト最適化が重み学習を一般に代替するともいえないことを具体的に示す。
TextGradとTrace/OptoPrimeを含む直接比較は、同じ最終版のTable 2にある。GPT-4.1 MiniのHotpotQAでは、Trace/OptoPrimeが60.33、MIPROv2が58.00、TextGradが62.33、GEPAが69.00である。これは対象モデルとタスクを揃えた最適化器全体の比較であり、TextGradの局所批評だけ、あるいはOptoPrimeの部分グラフ表現だけを入れ替えた比較ではない (Agrawal ほか 2026年, Table 2)。
一方、表 2 は、Qwen3 8Bで編集の仕組みを固定し、親候補の選び方を変えた比較である。最良候補一つを使う方法、上位四候補を維持するビーム探索、入力別の強みを使うGEPAの選択を比べる (Agrawal ほか 2026年, Table 3)。
| 親候補の選択 | HotpotQA | IFBench | HoVer | PUPA |
|---|---|---|---|---|
| SelectBestCandidate | 58.33 | 30.44 | 45.33 | 85.45 |
| BeamSearch(4候補) | 57.33 | 36.39 | 41.00 | 81.08 |
| GEPAの入力別選択 | 62.33 | 38.61 | 52.33 | 91.85 |
この比較は、同じ反省的編集でも親候補の選択によって結果が変わることを支持する。SelectBestCandidateをTextGrad全体の再現、BeamSearchを別の最適化器全体の再現と見なすのではなく、GEPAの編集手続き内の機構比較として読む。いずれもGEPA著者による実験である。
最終ラベルしかなくても、中間の指示や例示は最適化できる。ただし、全体得点から組合せを選ぶこと、批評を伝えること、実行記録から編集すること、局所報酬を学ぶこと、規則へ寄与を割り当てることは同一ではない。残る問いは、同じ変更範囲と評価費用のもとで、どの中間情報と寄与割当が、未見入力での共同改善に最も寄与するかである。固定した役割・呼び出し構造そのものを変更する場合は、ワークフロー構造の探索で扱う。
図版クレジット
Figure 4: (Opsahl-Ong ほか 2024年)。原図公刊版、Figure 4。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 1: (Yuksekgonul ほか 2025年)。公刊版。図版は arXiv 2406.07496v1 の Figure 1(Nature 掲載版ではない)。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 4: (Cheng ほか 2024年)。原図公刊版、Figure 4。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 3: (Agrawal ほか 2026年)。原図ICLR 2026公開版、Figure 3。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 1: (Wang ほか 2026年)。原図公刊版、Figure 1。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (B. Wu ほか 2026年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 11: (Khattab ほか 2024年)。出典: 原論文PDF、Figure 11。原図の領域を切り出してPNG化。
Figure 3: (S. Wu ほか 2026年)。出典: 原論文PDF、Figure 3。原図の領域を切り出してPNG化。