ワークフロー構造の探索
回答の指示を改善しても、情報を調べる前に結論を出す構造や、誤った中間結果を検査せず後段へ渡す構造が残れば、改善には限界がある。本章の問いは、どの処理を置き、何をどこへ渡し、どの条件で再実行するかを、実行結果からどう探索するかである。ワークフローとは、大規模言語モデル(Large Language Model, LLM)の呼び出し、ツール実行、集約などを接続した処理手順を指す。プロンプトの文面に加えて、処理の個数、順序、分岐、反復を変えることが本章の対象である。
ただし、「動的なワークフロー」は一つの意味ではない。探索によって得た共通プログラムが入力に応じて分岐する場合もあれば、入力ごとに別のグラフを生成する場合もある。さらに、実行中の観測で手順を変えることと、試行後に次の試行の構成を更新することも異なる。この区別を保ったうえで、実行可能な構造の探索、プロンプトとの共同最適化、失敗箇所に絞った修正、入力別・試行別の適応を比較する。
何を共通化し、何を入力ごとに変えるか
最も基本的な設定は、開発用の複数問題で候補を評価し、未知の問題にも使う共通ワークフローを選ぶことである。この場合、最終的に残るのは一つのプログラムやモジュール構成である。内部に検査後の分岐があっても、それだけで入力別の構造生成器になったわけではない。AFlow、MASS、FlowBot の主要実験は、この共通構造を探索する設定に属する。対して MaAS は入力を条件として構造を取り出す分布を学び、FlowSearcher は与えられた検索課題の小目標ごとに手順を合成する。EvoTest は同じ課題を繰り返す間に、次の試行で使う構成を変える。(Jiayi Zhang ほか 2025年; Zhou ほか 2026年; Yu ほか 2026年; G. Zhang ほか 2025年; Xiang ほか 2026年; He ほか 2026年)
この違いは評価対象にも直結する。共通構造なら、探索に使わなかった問題に同じ構成を適用した成績が重要である。入力別生成なら、構造を生成・選択する費用も問題ごとの推論費用に入る。試行間適応なら、最終試行だけでなく、何回の経験を経て改善したかを測る必要がある。したがって、いずれも「ワークフロー最適化」と呼ばれていても、一つの正答率順に並べることはできない。
| 比較する単位 | 代表的な方法 | 更新して保持するもの | 入力・実行との関係 |
|---|---|---|---|
| 共通ワークフローの探索 | AgentSquare、AFlow、MASS、CE-Graph、EvoMAS、FlowBot | モジュール構成、接続、プロンプトなど | 開発例で選び、後続の複数問題に適用する |
| グラフ接続分布の最適化 | GPTSwarm | 接続の確率とノードのプロンプト | オンライン更新と転移を含む実験がある |
| 入力条件付き構造の選択 | MaAS | agentic supernet の構造分布と演算子 | 質問に応じた構造をサンプリングする |
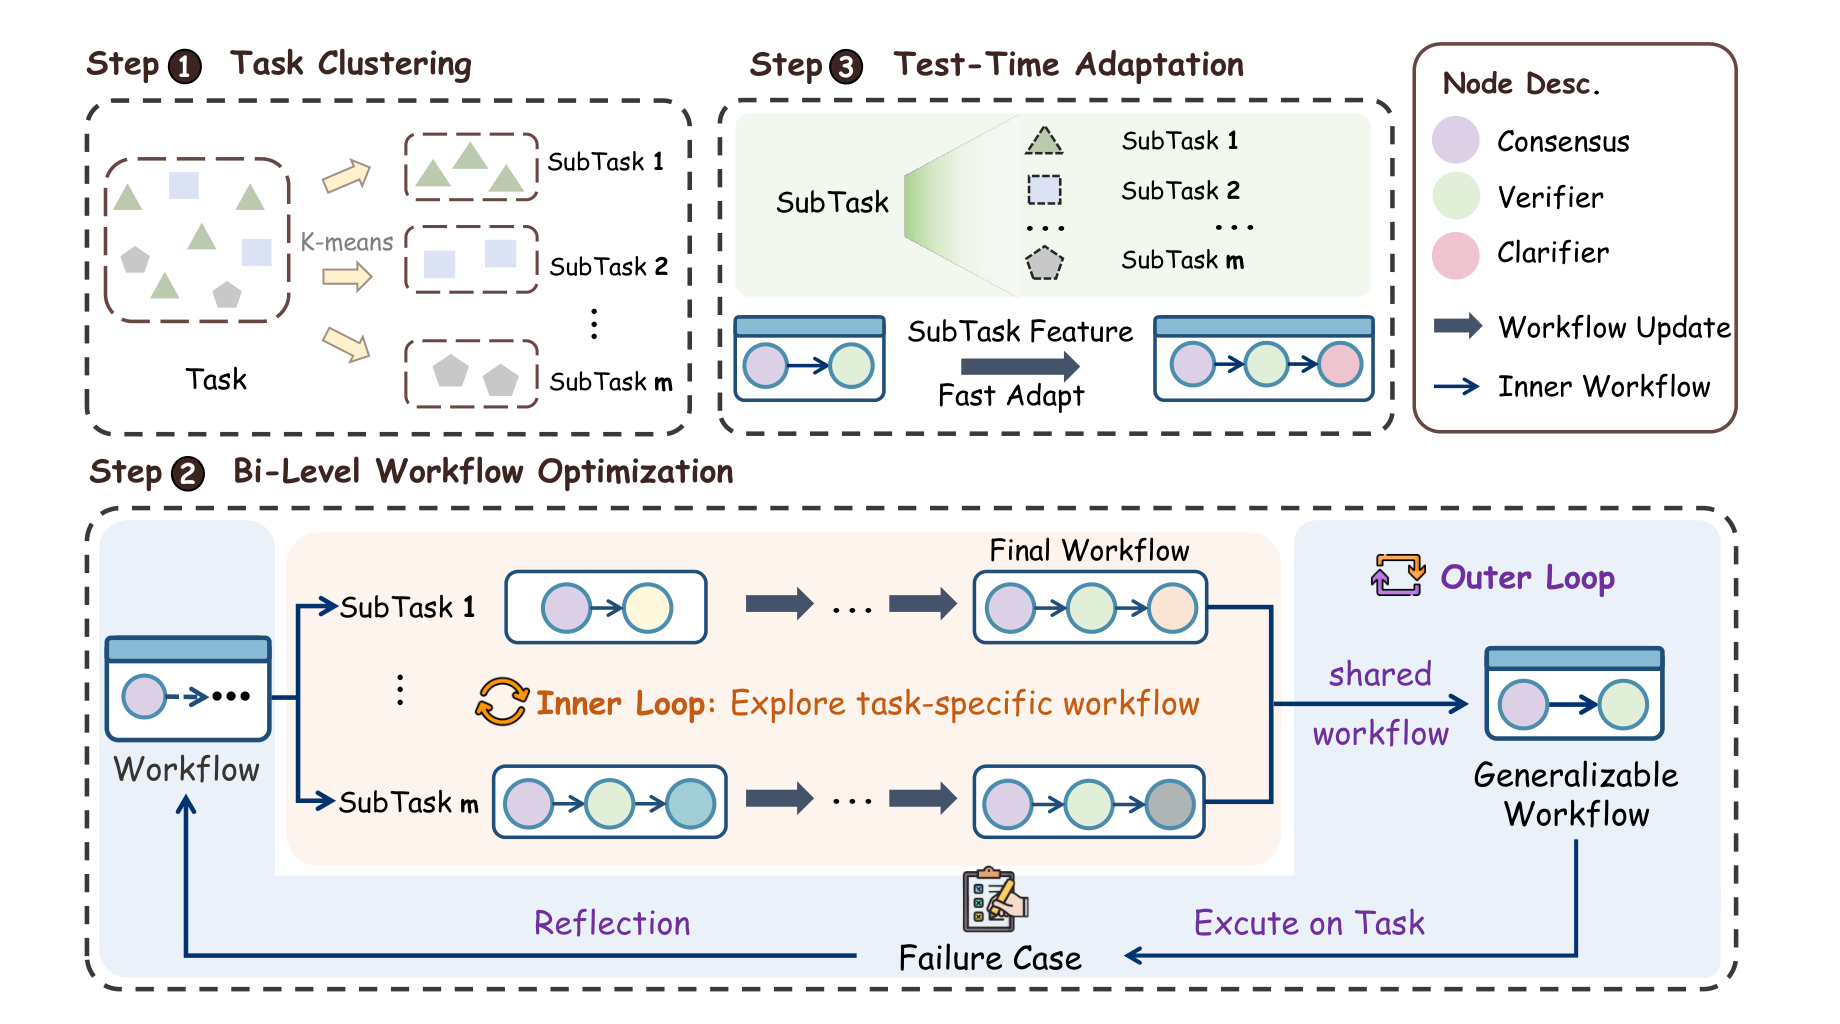
| 下位課題に応じた特殊化 | AdaptFlow | 共通初期ワークフローと適応規則 | 未知の下位課題の入力記述から特殊化する |
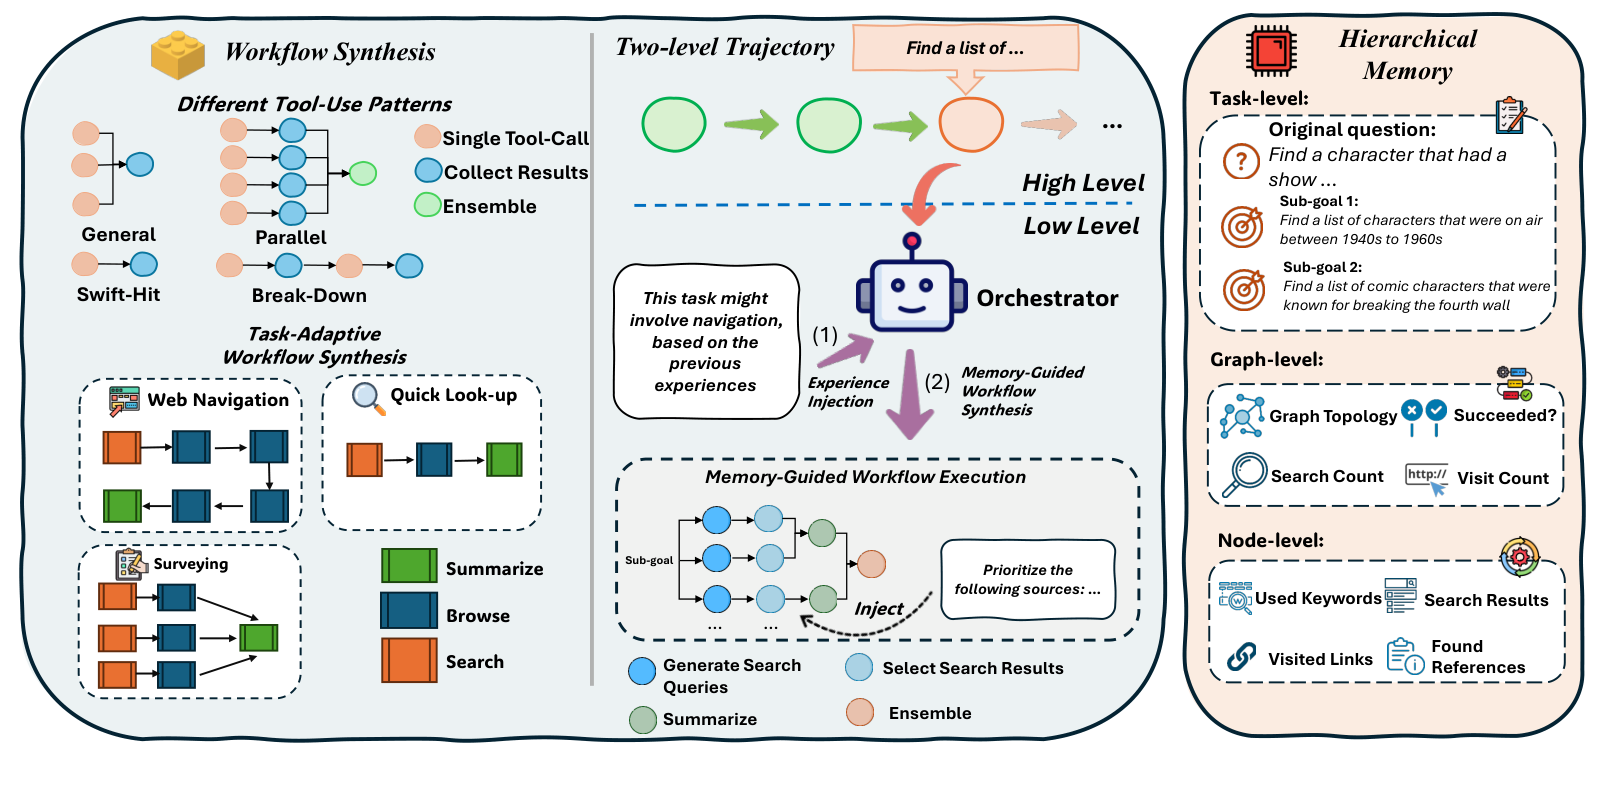
| 推論時の構造合成 | FlowSearcher | 構造経験を含む階層メモリ | 小目標ごとにグラフを作り、観測に応じて進める |
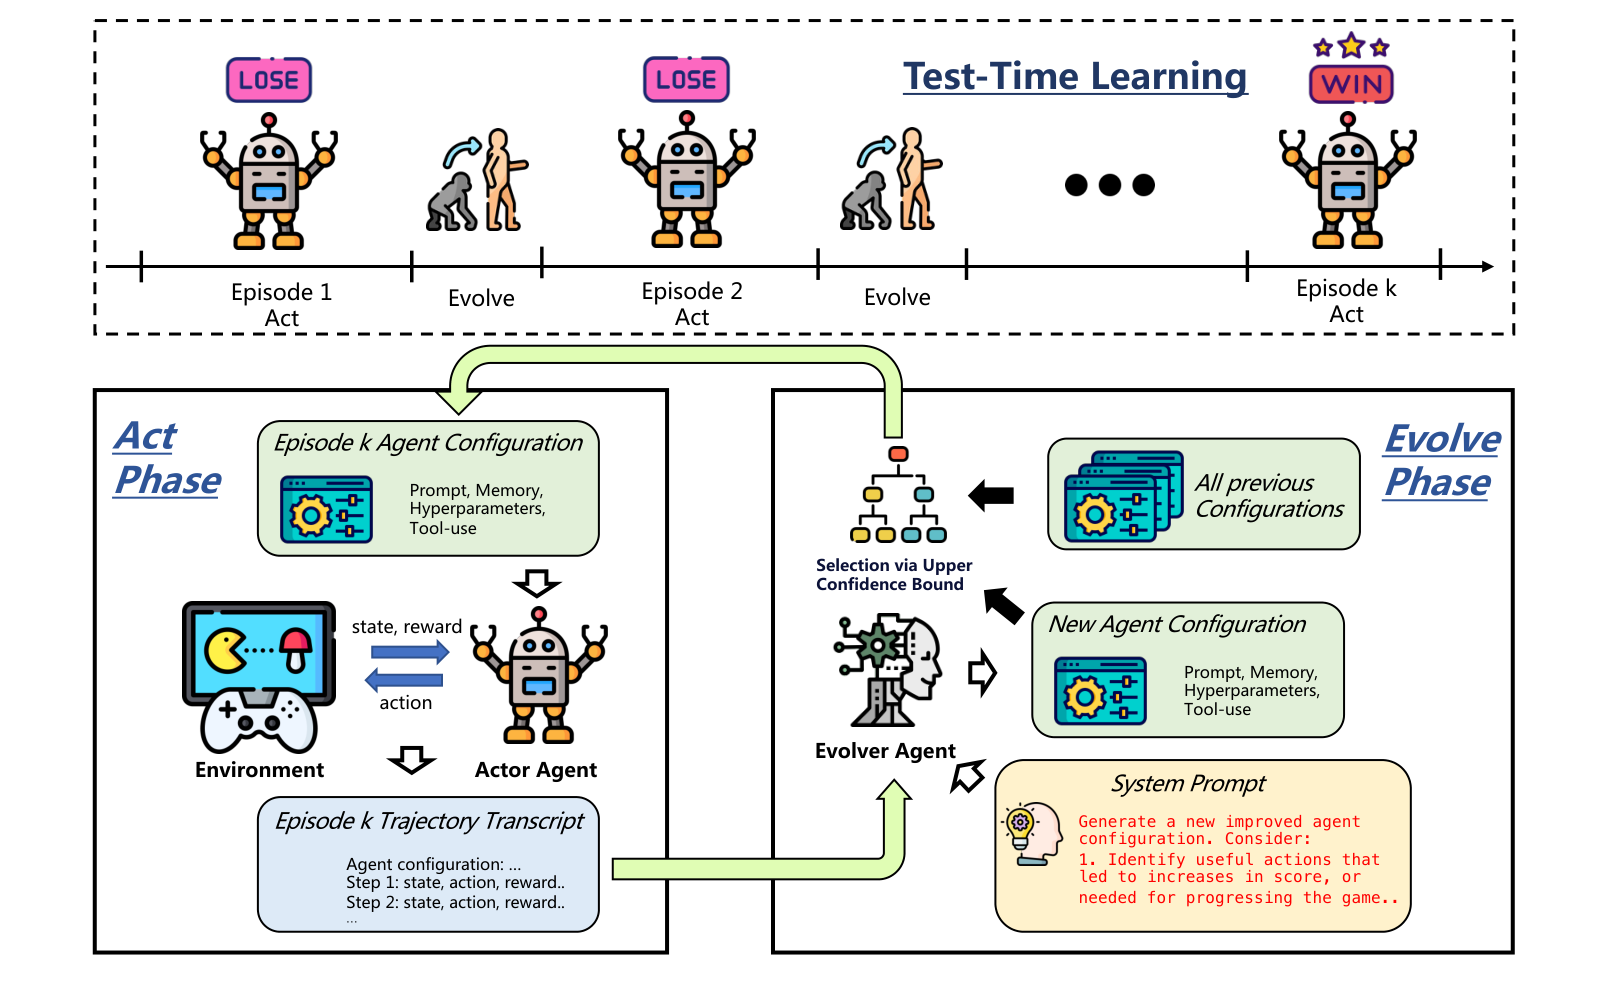
| 試行間の構成更新 | EvoTest | プロンプト、メモリ、設定、ツール手順 | 同じ環境での試行履歴を次の試行に反映する |
AgentOptimizer、ADAS、DGM のように関数ライブラリやエージェント実装自体を探索する方法は、エージェントコードの進化で扱う。生成器の学習を中心とする MAS-GPT と MAS-Architect は、最適化器の学習で扱う。本章では、構造の表現と評価をどう結び付けるかに焦点を絞る。
実行できる構造を探索候補にする
接続を変える効果は、単にエージェントの人数を増やすことではない。ある処理が誰の出力を読めるかが変わり、誤りの伝播や独立な解答の集約の仕方が変わる。GPTSwarm は、モデル呼び出しやツール処理をノード、情報の流れを辺とする有向非巡回グラフ(Directed Acyclic Graph, DAG)としてエージェントを表す。複数のエージェントを一つの複合グラフにまとめ、エージェント間の辺を最適化する。候補となる接続ごとに確率を持ち、サンプリングしたグラフの実行効用から分布のパラメータを更新するため、組合せを一つずつ列挙する必要がない。ノード側では、実行と評価のフィードバックからプロンプトを改善する。(Zhuge ほか 2024年, Sections 2.3–2.4)
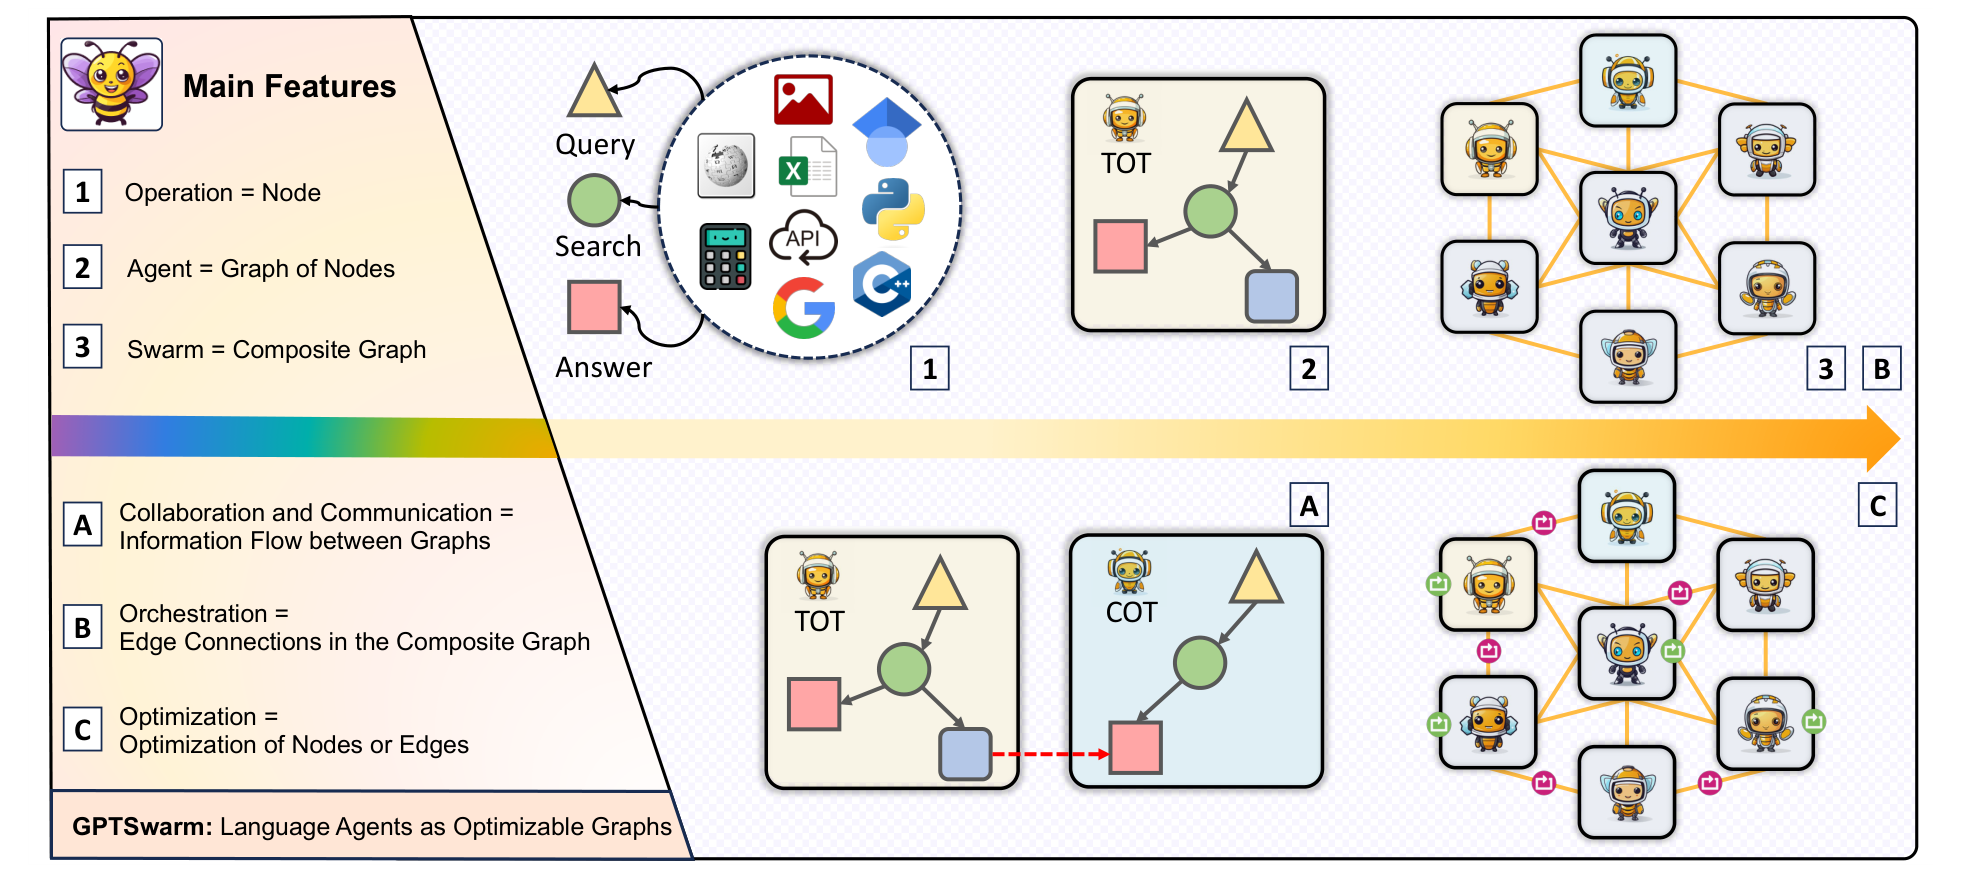
ここで更新する接続分布は、回答モデルの重みではない。また、同論文にはオンラインの接続最適化も含まれるため、GPTSwarm を「事前に一つの固定グラフだけを作る方法」と限定するのも不正確である。一方、基本表現は DAG であり、任意の反復や状態を持つ制御をそのまま表すものではない。構造の自由度を増やすには、どの実行規則まで探索可能にするかを明示する必要がある。
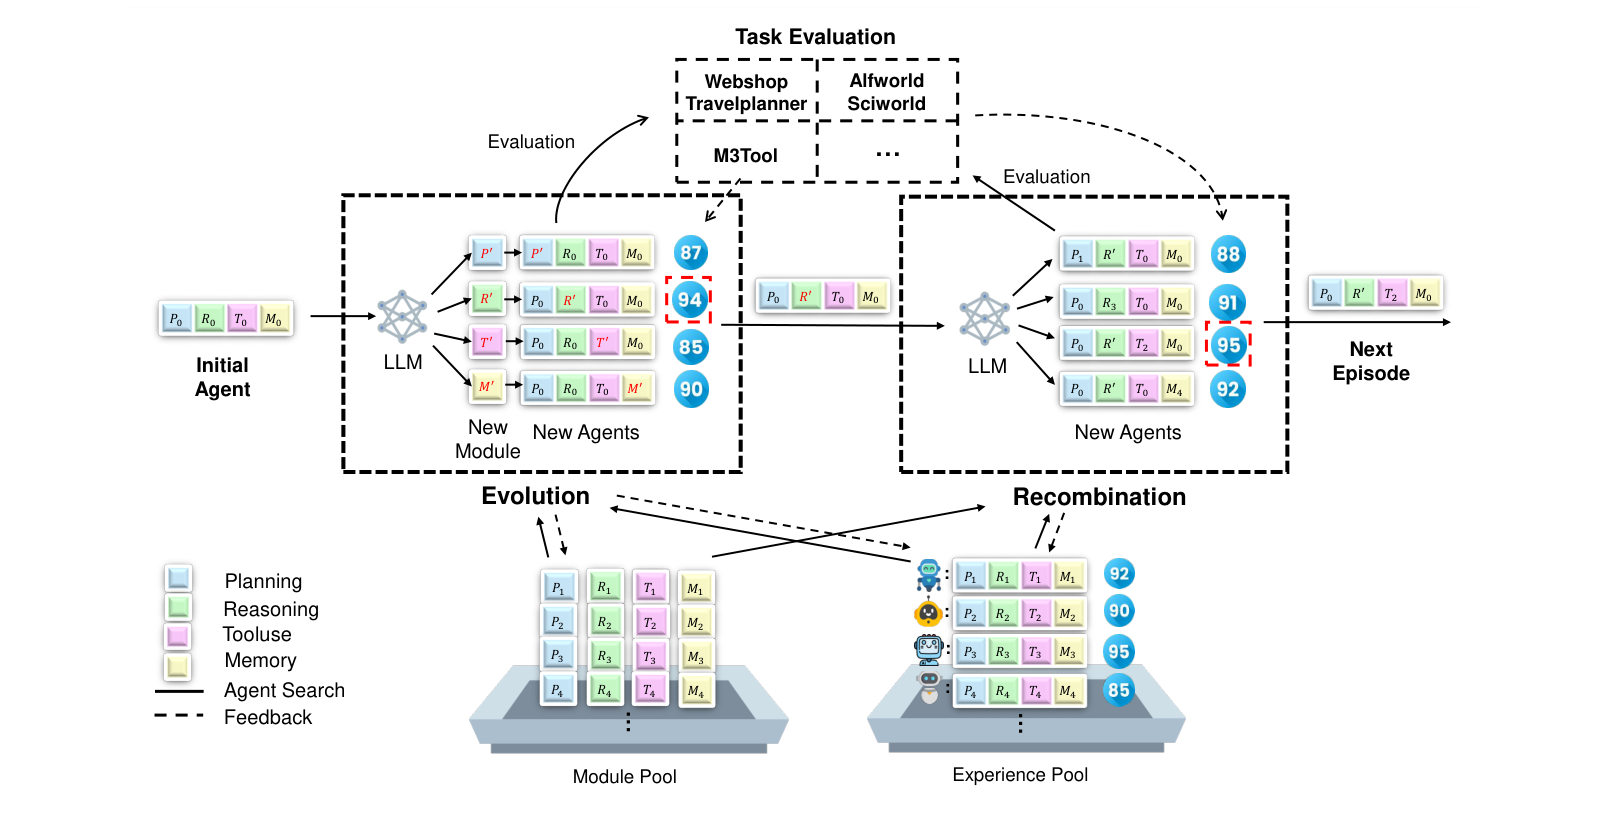
AgentSquare は、自由なグラフではなく、計画、推論、ツール利用、メモリの四種類のモジュールに標準入出力を与える。既存設計をモジュール単位で再結合する操作と、新しいモジュールを提案する進化操作を交互に使う。さらに、評価済みの構成と成績を文脈として用いる性能予測器により、有望でない候補の実行を省く。この制約は探索空間を狭くするが、別々の実装から得られた部品を再利用できる利点がある。多数エージェント間の通信グラフを最適化する GPTSwarm とは異なり、一つのエージェントの内部構成を探索する方法である。(Shang ほか 2025年, Sections 2–3) 図 2 では、再結合が既存のモジュール群を使う一方、進化が新しいモジュールを提案するため、組合せだけでなく再利用する部品も探索対象になる。
AFlow は、より直接的に実行可能コードを構造の表現として使う。ノードは LLM 呼び出しに対応し、Ensemble や Review & Revise などの演算子は、よく使う処理の組合せを共通のインターフェースにまとめる。これらを呼ぶコードが、実行順序、条件分岐、ループを表す。一般の定式化ではモデル、温度、出力形式もノードの属性であるが、主要な探索設定ではこれらを固定し、主にプロンプトとコードで表した接続を変える。すべてのノード属性を同時に探索したという意味ではない。(Jiayi Zhang ほか 2025年, Sections 3–4)
探索器はモンテカルロ木探索(Monte Carlo Tree Search, MCTS)の変種である。木の各候補は回答の途中状態ではなく、ワークフローそのものである。有望な候補を選び、そのコード、過去の変更経験、実行フィードバックを LLM に渡して子候補を作る。新候補を検証集合で繰り返し実行し、成績、親からの変更内容、改善の成否を記録する。ここでの「逆伝播」は重みの微分ではなく、探索木へ評価と変更経験を返す処理である。
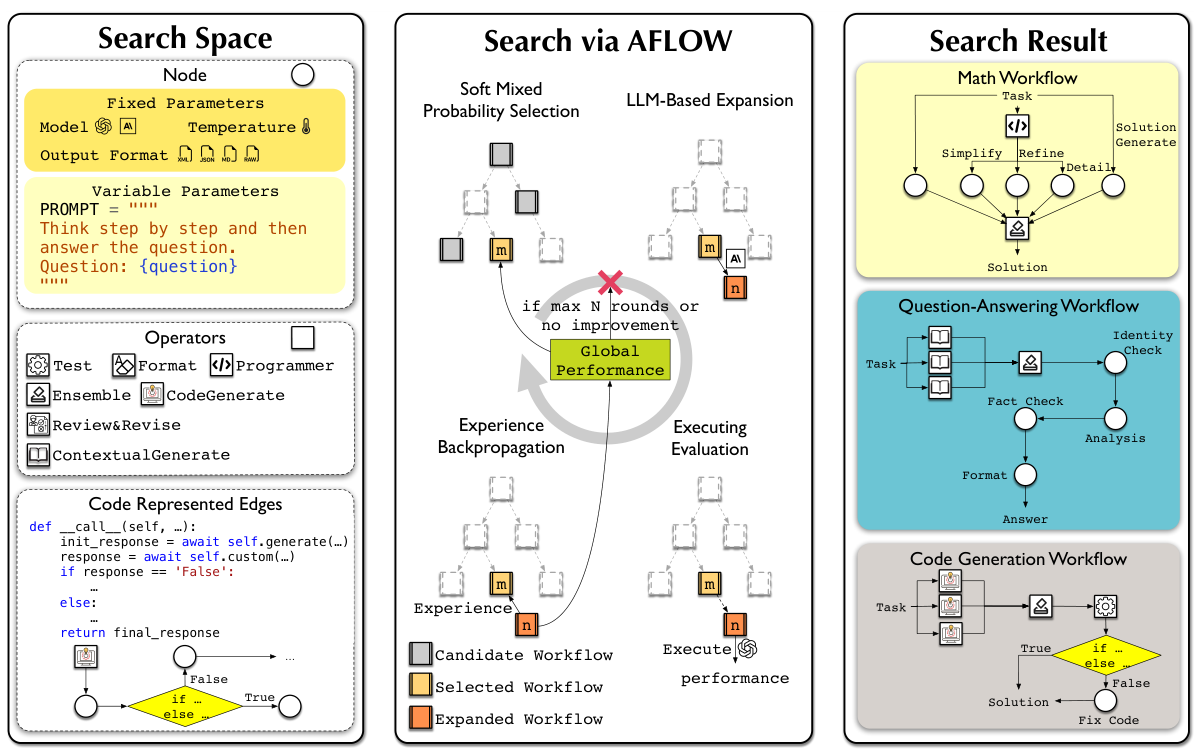
図 3 の左下では、辺が単なる接続線ではなく条件分岐を含むコードで表される。中央の変更経験は、ある候補で試した修正を次の候補生成へ渡すための記録である。右下のテスト後の分岐は、後掲の MBPP 掲載コードでも具体的に確認できる。
論文付録 C.1 の MATH 探索記録には、初期候補に Programmer 演算子を加え、Python で計算し、Custom 演算子で最終回答を整える変更が掲載されている。その候補には、さらに複数解を集約する変更が試されているが、同種の変更でも成功と失敗の両方が記録されている。これは「集約を追加すれば改善する」という一般則ではなく、どの親構造にどう追加したかを含めて評価する必要がある例である。(Jiayi Zhang ほか 2025年, Appendix C.1)
構造がコードに現れる具体例として、付録 B に掲載された MBPP 用ワークフローは、複数の解候補を作り、集約し、テストの結果に応じて修正する。次はその掲載コードから、分岐に関わる部分を抜粋したものである。探索途中の修正差分を再構成したものではない。(Jiayi Zhang ほか 2025年, Appendix B)
best_solution = await self.sc_ensemble(solutions=solutions, problem=problem)
test_result = await self.test(problem=problem, solution=best_solution['response'],
                             entry_point=entry_point)
if test_result['result']:
    return test_result['solution'], self.llm.cost_manager.total_cost
else:
    # If the test fails, try to fix the solution
    fixed_solution = await self.custom(
        input=f"Problem: {problem}\nFailed solution: {best_solution['response']}\nError: {test_result['solution']}",
        instruction=prompt_custom.FIX_CODE_PROMPT)
    return fixed_solution['response'], self.llm.cost_manager.total_cost
この例の重要点は、修正用の指示文だけでなく、修正を呼ぶ条件と渡すエラー情報が探索結果の一部になっていることである。それでも、探索後の各入力に対して同じプログラムを実行する設定であり、毎回新しいワークフローを探索する設定とは区別される。
部品のプロンプトと全体構造を切り離さない
構造だけを比較すると、ある部品のプロンプトが不十分だったために、その接続方式自体が無効に見える可能性がある。逆に、単独ではよい部品でも、他の部品と接続すると入力形式や役割が合わなくなる。MASS と FlowBot は、この依存関係を扱うが、共同最適化の進め方は異なる。
MASS(Multi-Agent System Search)は、部品のプロンプト最適化、構造探索、全体のプロンプト再最適化という三段階を使う。まず基本の解答器を改善し、それを条件に、集約、反省、討論、要約、ツール利用などの最小構成で指示と例示を最適化する。次に、基本解答器に対する各部品の相対的な検証成績を影響度として使い、構造の探索次元を選ぶ確率に反映する。候補をエージェント数の上限内でサンプリングし、検証成績で構造を選ぶ。最後に、選ばれた全体構造のもとでプロンプトを再度共同最適化する。(Zhou ほか 2026年, Section 3, Algorithm 1)
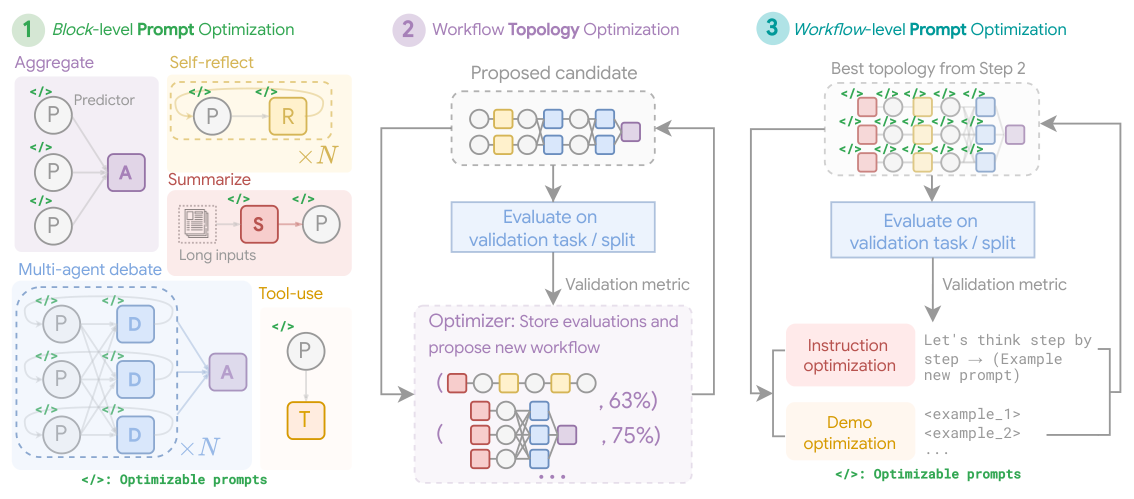
図 4 は、同時にすべてを自由探索するのではなく、条件を順に固定して組合せの複雑さを抑える点を示している。構造も任意のグラフではない。付録 C.3 では要約、反省、討論、集約の既定順序を用い、並列数や反復回数、実行器の有無などを探索する。したがって MASS の結果は、無制約なコード探索よりも、プロンプトを十分に調整した部品からなる構成空間の有効性を示す。
同論文の Figure 2 は、構造を複雑にする前に部品を改善する理由を、推論トークン数との関係で示す。Gemini 1.5 Pro を用いた MATH 実験で、自己整合性による複数解の集約、自己反省、討論に加えて、指示と一つの例示を最適化した解答器、およびその解答器に自己整合性を加えた構成を比較する。付録 C.1 の当該データ設定は検証 60 問、テスト 100 問のサブセットである。横軸は各構成が消費した問題当たりの推論時トークン数であり、全手法に同じトークン上限を課した一点比較ではない。(Zhou ほか 2026年, Figure 2, Appendix C)
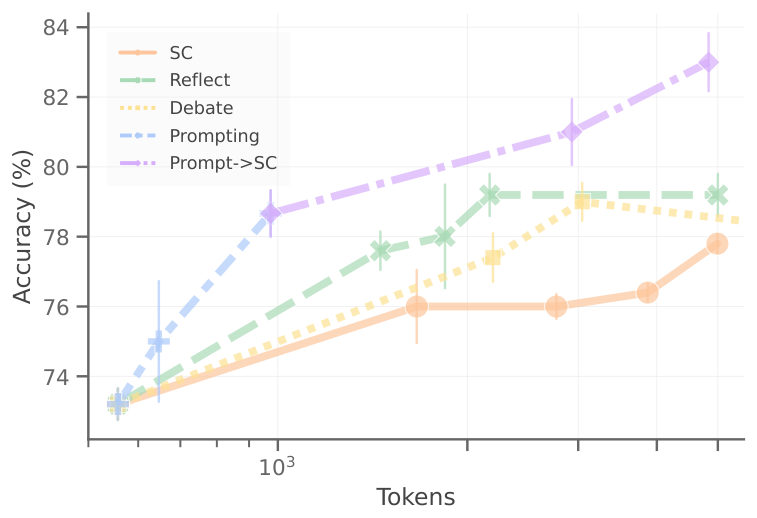
図 5 では、プロンプトを改善してから複数解を集約する構成が、既定プロンプトのまま呼び出しを増やす構成とは異なる費用対性能の関係を示す。ただし、これは探索費用を含む総費用の優位性ではない。多数の将来入力に同じ構成を使えば探索費用を分担できるが、少数入力だけなら結論は変わり得る。また、図の曲線は部品の効果を調べる実験であり、MASS 全体とあらゆる探索器の優劣を直接示すものでもない。
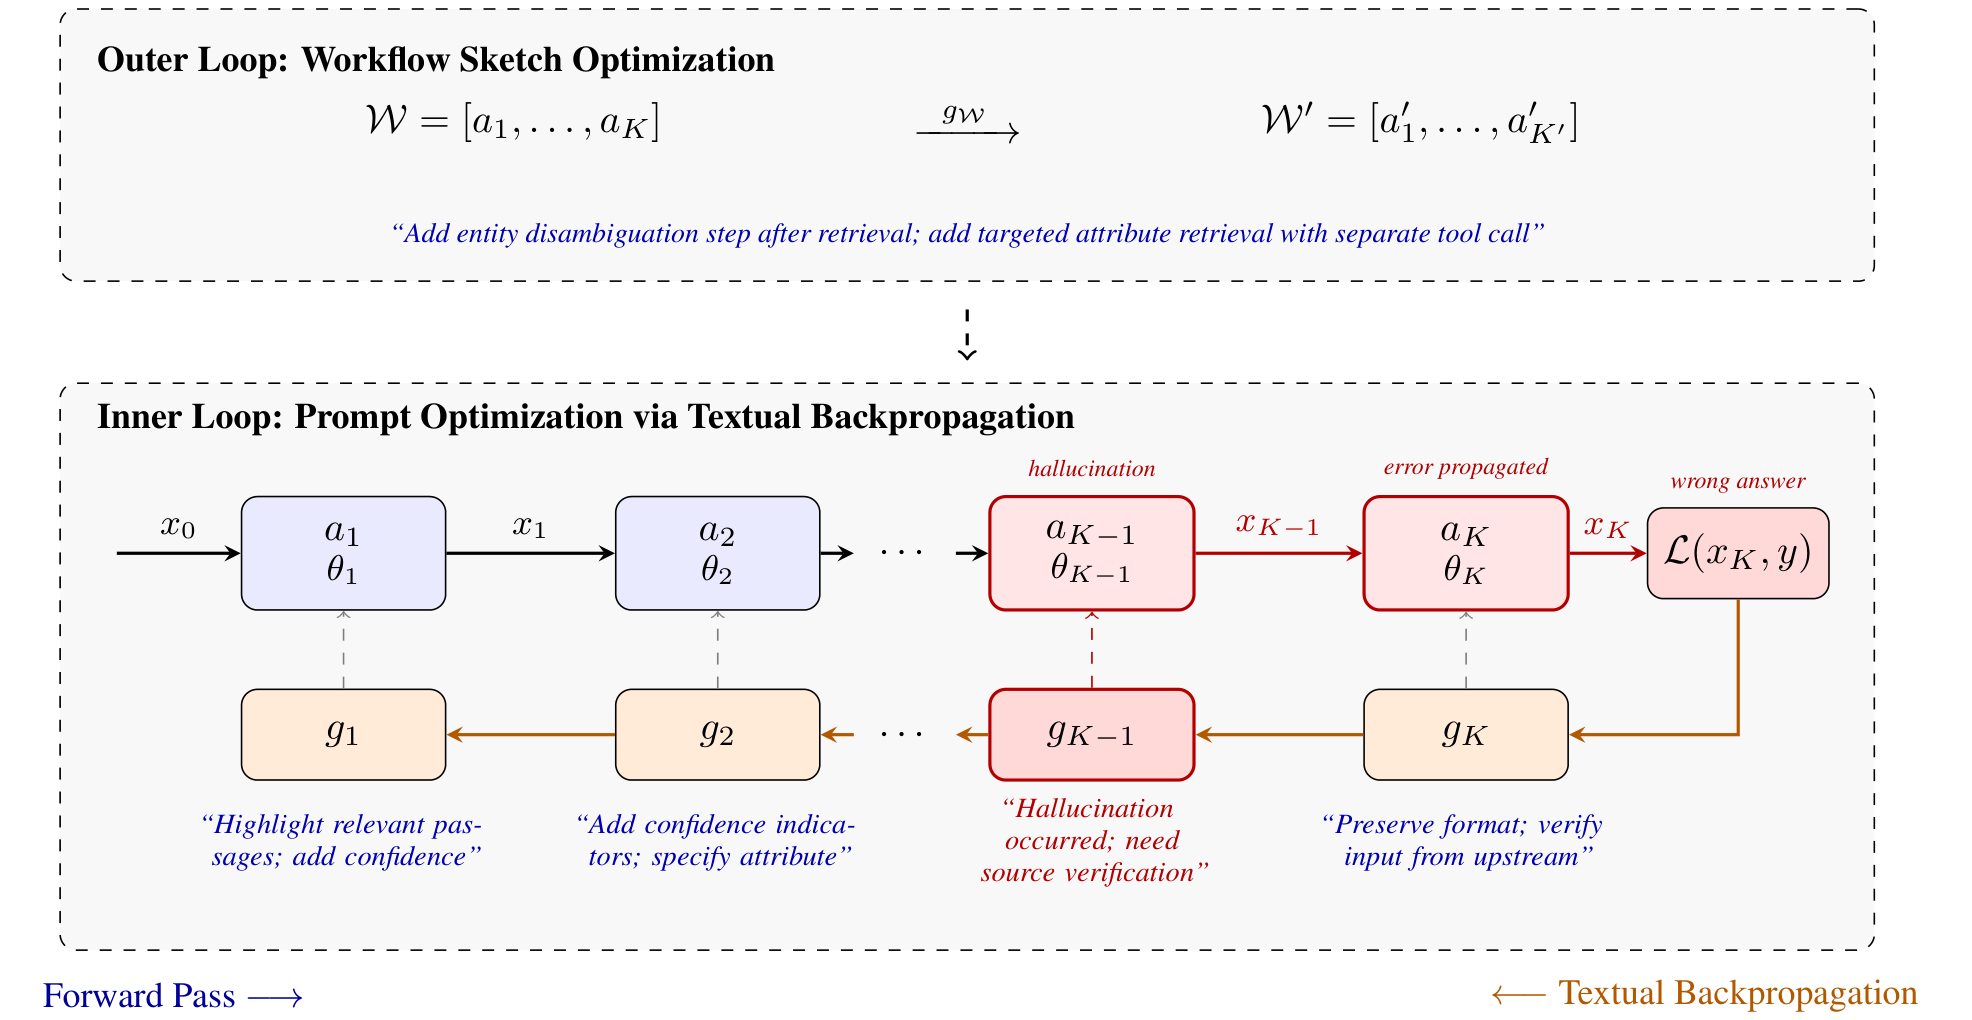
FlowBot は三段階を一度進める代わりに、外側で高水準のワークフロー記述、内側で各呼び出しの詳細プロンプトを交互に最適化する。構造はコードではなく、各呼び出しの役割を記したテキストの概略で表す。内側では最終出力への評価を中間処理へさかのぼって渡し、各ノードへの自然言語の改善提案を生成する。外側では呼び出しの追加、削除、統合を提案する。これは数値微分ではなく、LLM による文章上のフィードバックの分配と適用である。学習データで更新し、検証成績が最もよいワークフローをテストに使うため、実行するたびに構成を更新するオンライン手法ではない。MASS が部品の事前調整と構造選択後の整合に重点を置くのに対し、FlowBot は構造と部品を反復して調整する。(Yu ほか 2026年, Sections 2–3)
失敗箇所の修正と探索戦略の更新
平均成績は候補選択には便利だが、何を変えるべきかは教えない。同じ不正解でも、計算の誤り、途中結果の欠落、出力形式の違反では修正対象が異なる。ICML 2026 の Failure-Driven Workflow Refinement は、CE-Graph という手法により、失敗をまとめてから局所的なグラフ編集を提案する。(Jusheng Zhang ほか 2026年)
CE-Graph はまず失敗した実行を反例集合へ蓄積し、各実行から「誤りを生じたノード」と「誤りの内容」を抽出する。ノード識別子の表現とエラーメッセージの意味埋め込みを連結した失敗署名を作り、ガウス混合モデルで繰り返し現れる失敗の群を推定する。基本設定では出現の多い群を優先し、必要に応じて深刻度で重み付けする。単に直近の一例を修正するのではなく、集中して発生する弱点を修正対象にする設計である。(Jusheng Zhang ほか 2026年, Sections 3.1–3.2)
提案器は対象の失敗群を条件に変更案を出す。実行可能な編集は、既存ノードのプロンプト修正、明示的な入出力を持つノードの挿入、冗長なノードの削除である。候補を対象群の事例で実行して比較した後、ワークフロー全体の検証成績も確認する。局所的な修復が他の問題を壊す可能性があるため、この二つの確認は代替関係にない。同論文の主要設定は最小の解答ノードと検証器から始め、最大 20 回の反復と収束に応じた停止を用いる。(Jusheng Zhang ほか 2026年, Algorithm 1, Section 4.1)
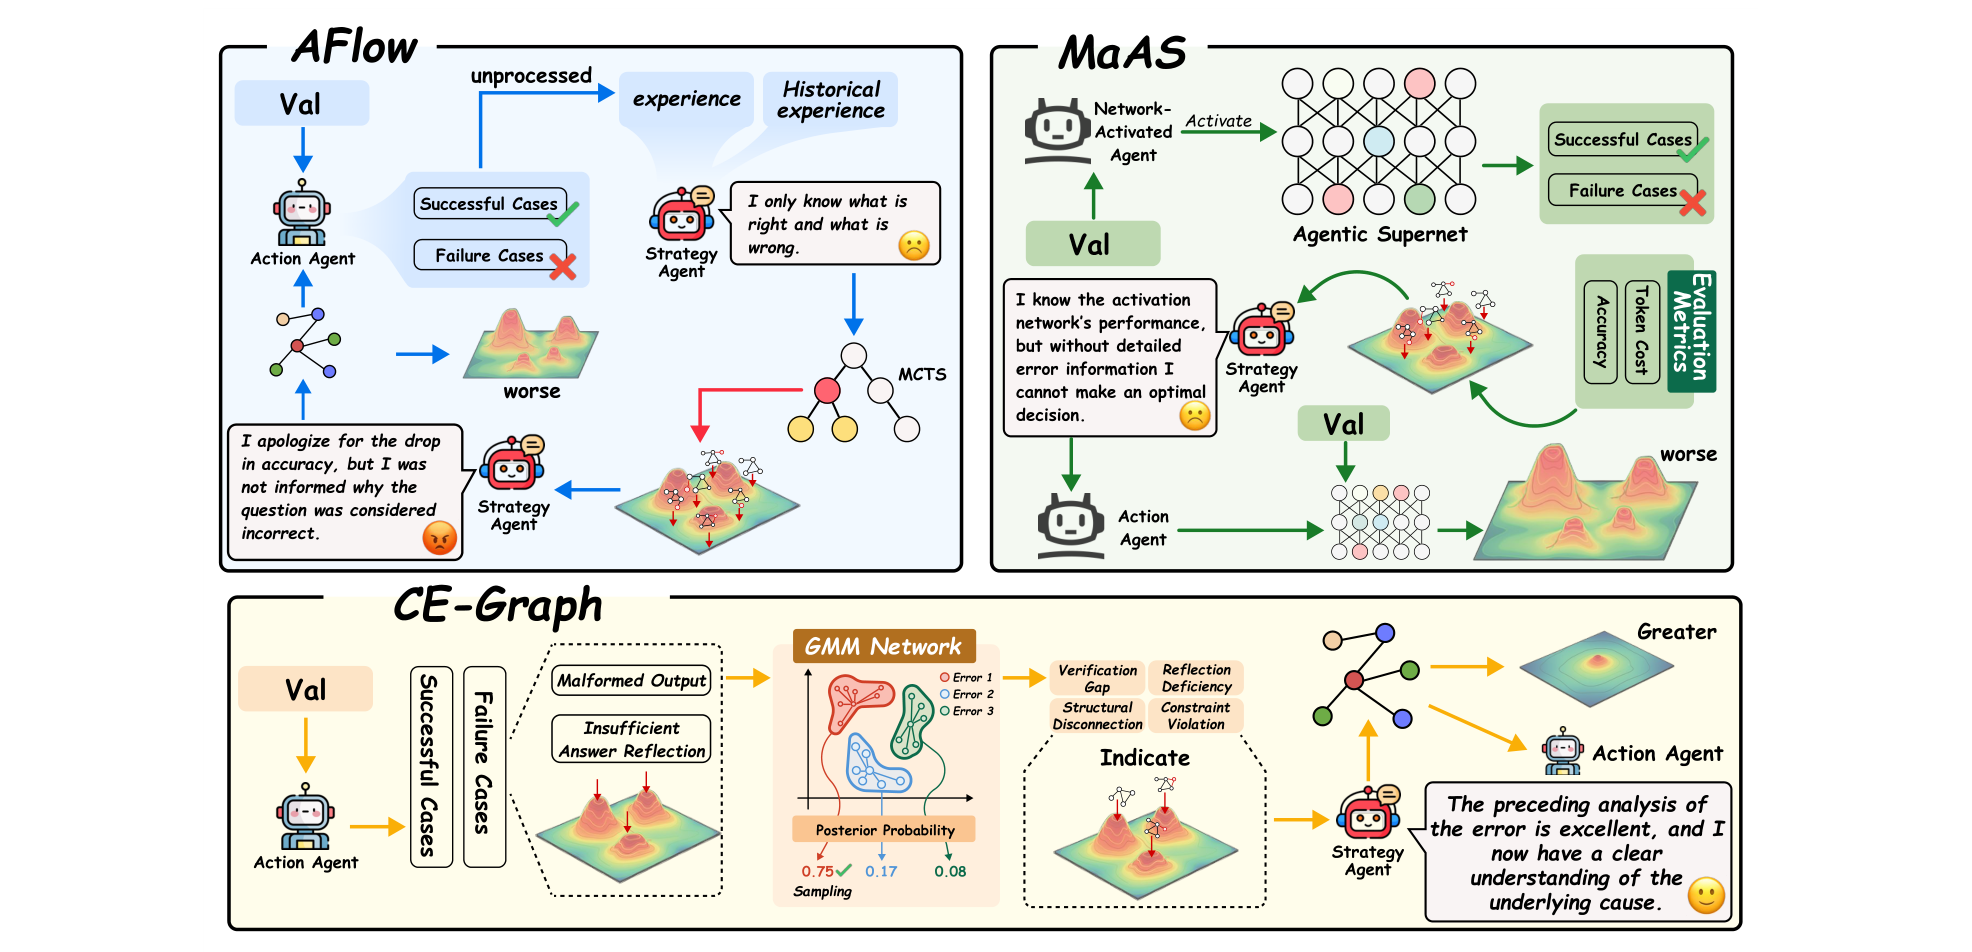
AFlow も実行フィードバックを用いるので、両者の違いを「失敗を見るかどうか」とするのは適切でない。AFlow は候補木と親からの変更経験を使って広く探索するのに対し、CE-Graph は失敗位置と意味を明示的に集約し、支配的な失敗群に編集を条件付ける。失敗密度を減らすという定式化も、編集に対する通常の微分が計算できるという意味ではない。論文中の改善保証には局所修正の影響に関する仮定があり、任意の LLM 提案が必ず全体を改善する保証ではない。
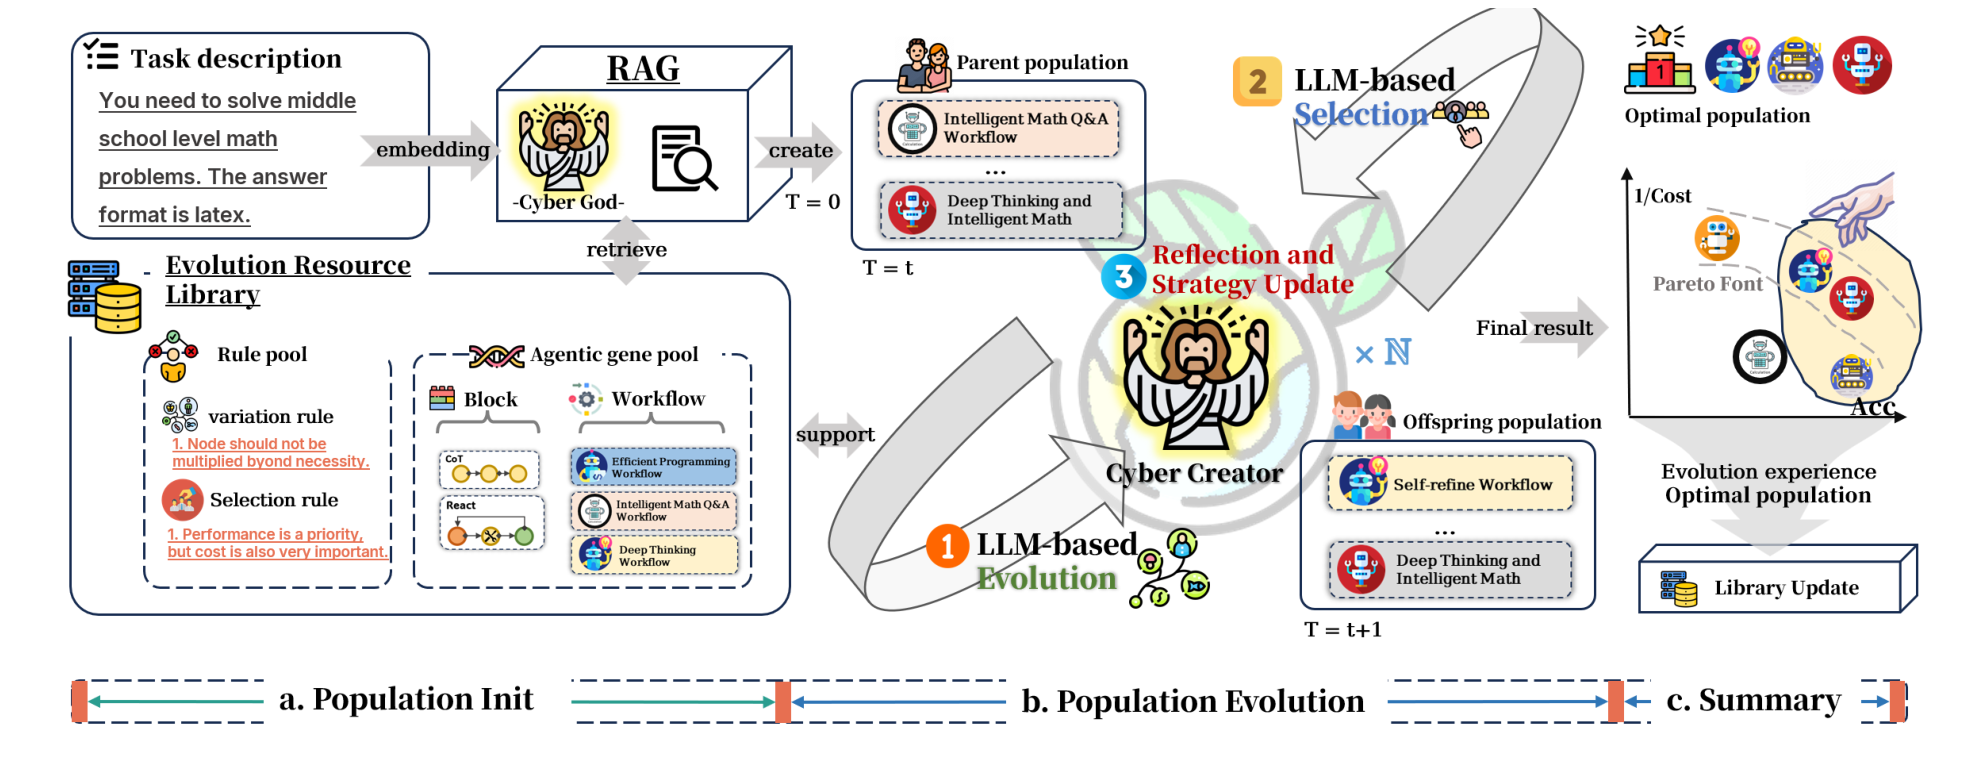
別の方向から探索効率を改善するのが EvoMAS である。構造や役割を変える複数の進化操作を持ち、探索を広げる操作と有望候補を改善する操作の選び方を調整する。課題を易しいものから難しいものへ進め、定期的に Cyber Creator というメタ制御器が探索履歴を反省し、無効な構造を避ける規則や操作選択の戦略を更新する。CE-Graph が「どの失敗に編集を集中するか」を変えるのに対し、EvoMAS は「候補を生む規則と操作の配分」も変える。ここでいう進化は主として開発時の探索であり、運用中の各入力で役割や接続を学習し続けることと同一ではない。(Wei ほか 2026年, Sections 4.1–4.3)
入力別生成と試行間適応は別の問題である
一つの共通構造では、単純な問題に過剰な処理を割り当て、難しい問題には処理が不足することがある。MaAS は、利用可能な演算子と接続を含む agentic supernet を用意し、質問を条件に必要な構造をサンプリングする。各層で演算子を選択し、早期終了演算子が選ばれればそこで止まる。開発時には、解答の品質と実行費用から構造分布を更新し、演算子のプロンプト、温度、内部構成には文章による改善提案を使う。回答モデルの重みを更新することと、構造を選ぶ分布を学ぶことは別である。(G. Zhang ほか 2025年, Section 3, Algorithm 1)
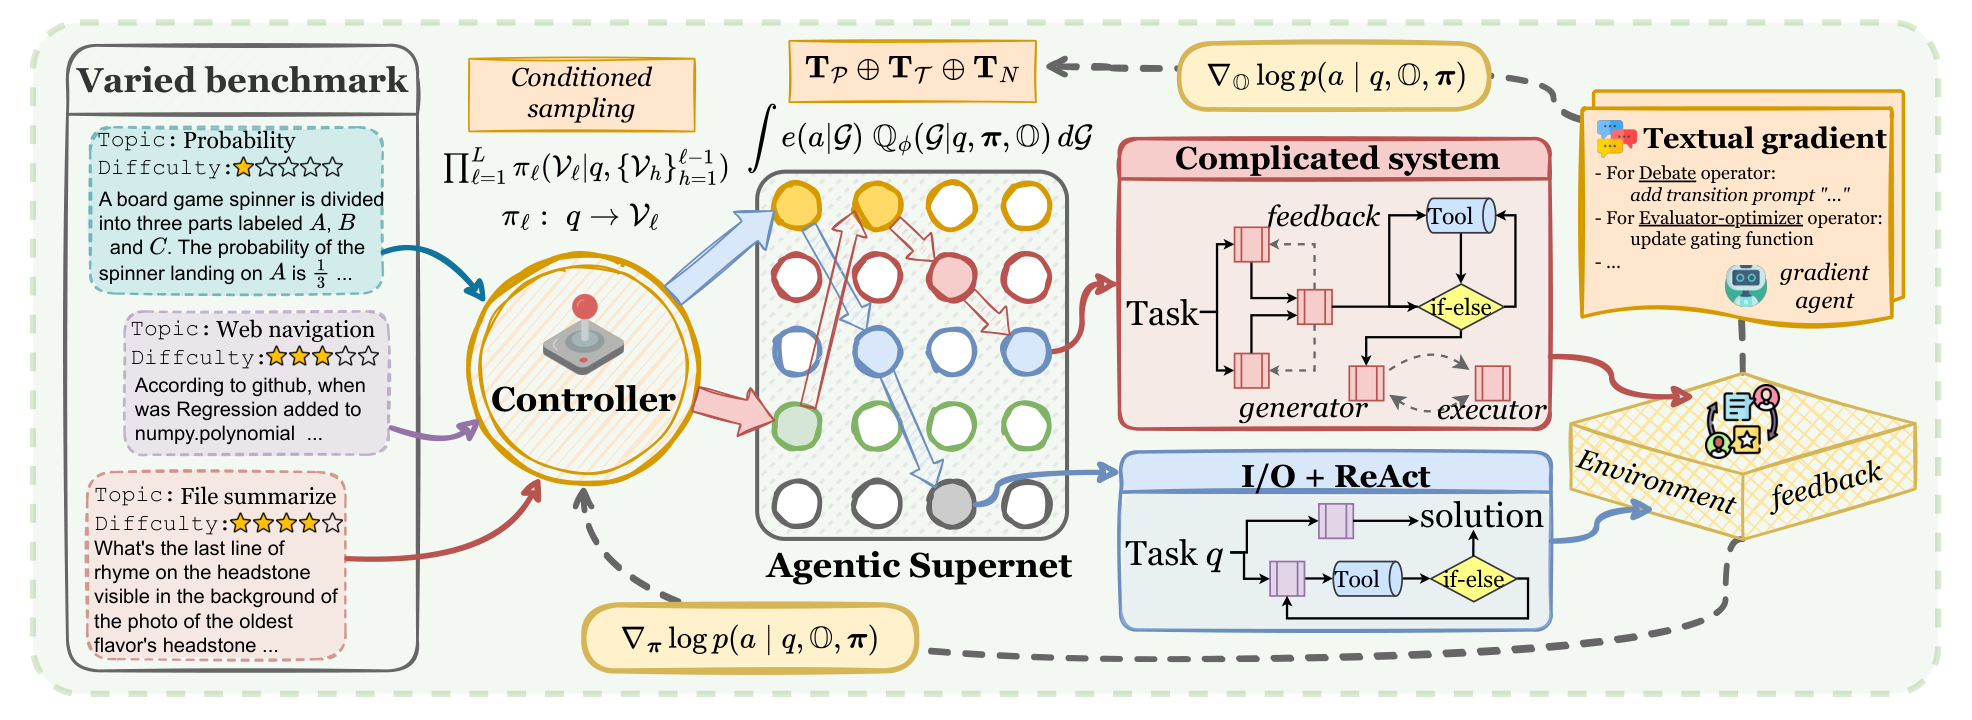
MASS との違いは重要である。MASS はデータ集合で有効な構造を選んで共有するが、MaAS は構造を選ぶ仕組みを共有し、実際に実行する構造は質問に応じて変える。このため後者では、平均性能だけでなく、難度に応じて呼び出し数がどう配分されるかも検証対象になる。固定構造の探索を高度化するだけでは、この入力依存性は自動的には得られない。
AdaptFlow は中間的な単位として、意味の近い入力をまとめた下位課題を用いる。内側で下位課題ごとのワークフローを改善し、外側で改善フィードバックを集約して共通の初期構造を更新する。未知の下位課題では、入力質問だけから作った意味的な記述を使って構造を特殊化する。テストの正解を受け取って内側の探索を続ける方式ではない。また、メタ学習に着想を得ているが、対象はコード空間の記号的更新であり、少数の勾配更新で新しい課題へ適応しやすいモデル重みの初期値を学ぶ MAML(Model-Agnostic Meta-Learning)と同じ処理ではない。ここでの比較対象はモデル重みの勾配ベースのメタ学習であり、MAML のすべての派生法が二階微分を必要とするという意味ではない。同論文は EMNLP 2025 の Findings 採録である。(Zhu ほか 2025年, Sections 3–4)
FlowSearcher では、共有する対象が固定の全体構造から、構造を生成する際の経験へ移る。Web 情報探索の質問を小目標へ分け、それぞれについて検索、閲覧、分析などの処理を組み合わせたグラフを合成する。ノード、グラフ、課題という複数の水準で過去の経験を保持し、生成と実行の両方を支援する。手順の深さ、順序、ツールの組合せを入力と観測に応じて変えるため、共通ワークフローの最終候補を選ぶ実験とは目的が異なる。階層メモリの存在だけでなく、それが新しい構造の合成条件になる点が特徴である。(Xiang ほか 2026年, Section 3) 図 11 でメモリが構造の合成と実行の両方へ入る点から、過去の経験を使うこととトポロジーを固定することが異なると分かる。
EvoTest は、さらに時間軸が異なる。同じゲーム課題を複数回試行し、Actor が実行した全履歴と報酬を Evolver に渡して、次の試行のプロンプト、メモリ、ハイパーパラメータ、ツール利用手順を更新する。過去の構成からの選択には上側信頼限界を用いる。モデル重みを更新せず試験時に適応するが、中心は必ずしもトポロジー探索ではなく、構成全体の進化である。初見の別問題に使う共通グラフの改善と、同じ環境を繰り返し経験したことによる改善を混同してはならない。(He ほか 2026年, Sections 3–4) 図 12 の Act–Evolve ループでは構成の更新がエピソード間に置かれ、重みを訓練するループとは区別される。
以上の研究は、構造を自由にするだけでは十分でないことを示している。AFlow は実行可能性と変更履歴、MASS と FlowBot は部品と構造の依存、CE-Graph は失敗の位置と反復性、MaAS と FlowSearcher は入力ごとの必要処理、EvoTest は経験を更新へ戻す時点を明示する。未解決なのは、これらの自由度を増やしたとき、探索・構造生成・実行・適応の費用を同じ予算に含めても、未知の入力や環境で改善が残るかである。共通構造、入力別生成、試行間適応を分けることが、その問いを検証可能にする。
図版クレジット
Figure 1: (Zhuge ほか 2024年)。原図公刊版、Figure 1。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 3: (Jiayi Zhang ほか 2025年)。原図ICLR 2025公開版、Figure 3。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 3: (Zhou ほか 2026年)。原図公刊版、Figure 3。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (Zhou ほか 2026年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 1: (Yu ほか 2026年)。原図公刊版、Figure 1。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (Jusheng Zhang ほか 2026年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 3: (Wei ほか 2026年)。原図公刊版、Figure 3。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (G. Zhang ほか 2025年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 2: (Zhu ほか 2025年)。原図公刊版、Figure 2。CC BY 4.0。原図を切り抜き・ラスタライズ。
Figure 3: (Shang ほか 2025年)。原図論文PDF、Figure 3。原図を切り抜き・ラスタライズ。
Figure 1: (Xiang ほか 2026年)。原図論文PDF、Figure 1。原図を切り抜き・ラスタライズ。
Figure 1: (He ほか 2026年)。原図論文PDF、Figure 1。原図を切り抜き・ラスタライズ。